ComfyUIの画像生成とは|txt2imgの流れ
*2026年9月29日に確認した内容です。ComfyUI の公式ドキュメント「テキストから画像へ」によります。画面は、編集部の PC(Windows 11)のポータブル版(Python ごと1つのフォルダに入った Windows 向けの ComfyUI。ComfyUI v0.37.0・フロントエンド 1.52.7・画面の表示は日本語)で撮りました。
ComfyUI で文章から画像を作る(txt2img)ワークフロー(ノードをつないだ処理の流れ)は、6つのノード(処理を1つずつ受け持つ部品)でできています。チェックポイント(画像を作るモデルのファイル)を読み、プロンプトを CLIP で条件付け(モデルに作りたいものを伝えるデータ)にします。KSampler は、空の潜在(画像を縮めた数の並び)からノイズを取り除いて描き、VAE で画像に戻して保存します。この記事の最後に、画像の作り方と設定を学ぶ記事を、読む順に並べています。
文章から画像を作るワークフロー
公式ドキュメントによると、文章から画像(Text to Image)は、文章の説明に合う画像を作る流れで、AI で画像を作るときの基本です。その中心は、ノイズを少しずつ取り除いて画像を作る拡散モデルです。公式ドキュメントは、文章から画像を作るのに要るものとして、画家にあたる画像を作るモデル、キャンバスにあたる潜在空間、画像への注文にあたるポジティブとネガティブのプロンプトを挙げています。
公式ドキュメントの手引きは、SD1.5(Stable Diffusion 1.5)のモデルを使います。手引きによると、SD1.5 は Stability AI が作ったモデルで、512×512 の画像で学習されています。軽く、一般の GPU でも動くので入門によいとされる一方、手の形や複雑な光の表現が崩れやすく、1024×1024 を直接作ると質が落ちます。
最初の画像を作る手順は、「ComfyUIで最初に画像を作る手順|公式の例のワークフローからの生成」の記事で解説しています。
6つのノードの流れ
公式の例のワークフローを開いて実行すると、次の画面になります。
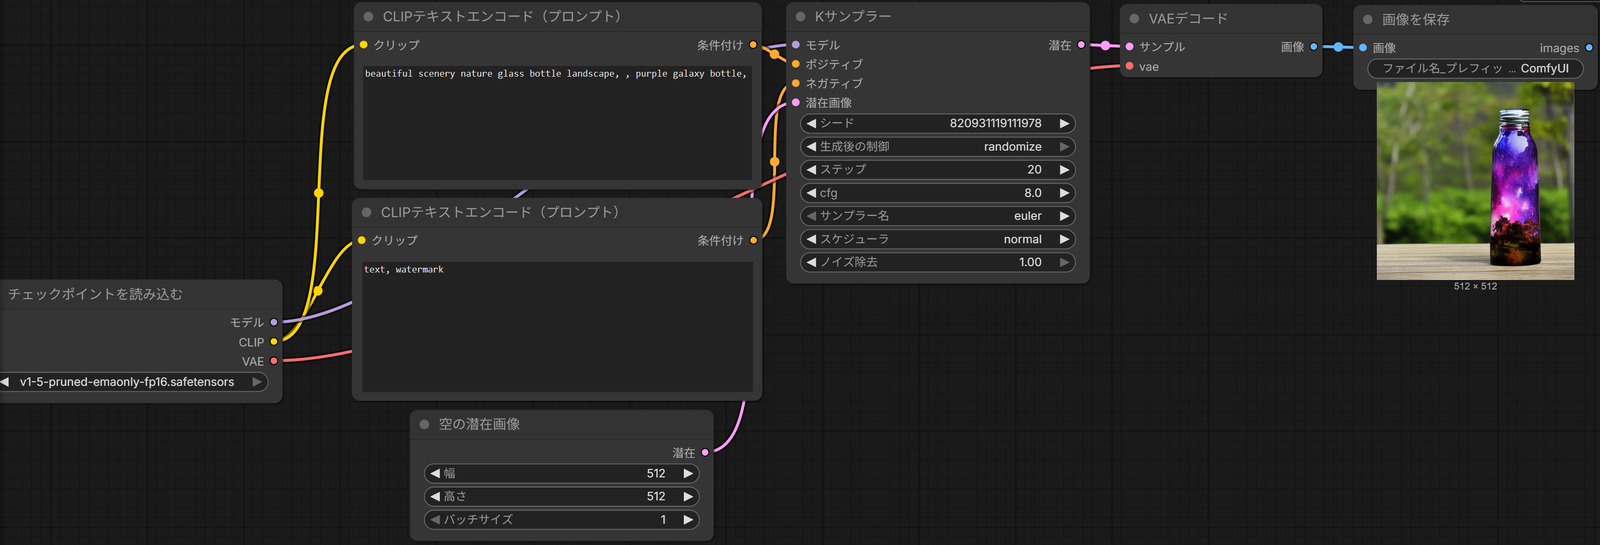
このワークフローは、次の6つのノードでできています。
| 順 | ノード(画面の名前) | 公式ドキュメントの説明 |
|---|---|---|
| 1 | Load Checkpoint(チェックポイントを読み込む) | 画像を作るモデルを読む。チェックポイントには、ノイズを予測して画像を作るモデル(UNet)・プロンプトを変える CLIP・画像と潜在を行き来させる VAE の3つが入っている |
| 2 | Empty Latent Image(空の潜在画像) | 純粋なノイズの潜在を作る。キャンバスの大きさ、つまりできる画像の解像度を決める |
| 3 | CLIP Text Encode(CLIPテキストエンコード(プロンプト)) | プロンプトを、CLIP でモデルが使える形に変える。KSampler のポジティブにつなぐものは画像に入れたい要素、ネガティブにつなぐものは入れたくない要素 |
| 4 | KSampler(Kサンプラー) | ワークフローの中心。ノイズを取り除き、潜在の画像を出す |
| 5 | VAE Decode(VAEデコード) | KSampler の潜在の画像を、画素の画像に変える |
| 6 | Save Image(画像を保存) | できた画像を見せ、ComfyUI/output のフォルダに保存する |
画像ができるまでの仕組み
公式ドキュメントによると、文章から画像を作る流れは、逆拡散(ノイズから画像へ戻していく過程)と捉えられます。
- KSampler が、シード(ノイズを作るもとになる数)をもとに、潜在にランダムなノイズを作る
- プロンプトを CLIP で変えた条件付け(ポジティブとネガティブ)を、モデルへの条件として渡す
- KSampler が、決めたステップ数だけ、少しずつノイズを取り除く
- できた潜在を、VAE Decode で画素の画像に戻す
公式ドキュメントによると、潜在空間は、拡散モデルで使う抽象的なデータの表し方です。画像を画素の空間から潜在空間に変えると、データの大きさが減り、拡散モデルの学習と生成が効率よくなります。画素(ピクセル)空間は、最後に目にする画像の画素の値を持つ空間です。
仕組みの考え方は、「拡散モデル|ノイズを少しずつ取り除いて作る画像」「潜在空間とVAE|画像を小さく縮めた計算」「テキストエンコーダとプロンプト|文章を数値にして絵に伝える仕組み」の記事で解説します。
続けて読む記事
上から順に読むと、ワークフローの基本から、元の画像から作る方法、LoRA(モデルに絵柄を足す軽いファイル)と Embedding(プロンプトで呼び出す学習済みのデータ)、仕上げと保存の順に学べます。
基本の流れと設定
- ComfyUIの画像生成とは|txt2imgの流れ(この記事)
- ComfyUIのKSamplerの設定|シード・ステップ・CFG・サンプラー・スケジューラ・デノイズ
- ComfyUIのカスタムサンプリング|SamplerCustom・ガイダー・ノイズ・シグマ
- ComfyUIのプロンプトと重み|CLIP Text Encode・語の強さ
- ComfyUIの条件付けの組み合わせ|Combine・Concat・Average・ステップの範囲
- ComfyUIの画像の大きさとバッチ|Empty Latent Image・バッチでの生成
- ComfyUIの潜在の加工|拡大・合成・切り抜き・演算
- ComfyUIのVAEデコードとエンコード|VAEの差し替え・タイル処理
元の画像から作る
LoRA と Embedding
仕上げと保存
- ComfyUIのモデルの調整ノード|FreeU・Rescale CFG・ガイダンスの補正
- ComfyUIのVRAMの節約と速さ|起動オプション・タイル・キャッシュ
- ComfyUIの画像の保存とプレビュー|Save Image・出力フォルダ・ワークフローの記録
- ComfyUIの画像を加工するノード|大きさ・切り抜き・色・合成・フィルタ
ComfyUI のモデルとカスタムノードの全体は、「ComfyUIのモデルとカスタムノードとは|モデルのファイルと機能を足すノード」の記事で解説しています。
会員登録(無料)
記事やテーマのお気に入り・学習履歴・フォローが使えます。
この記事について
PERSC編集部が、建築の制作に関わる知識を実務目線で整理しています。内容は公開・更新日時点の情報にもとづきます。誤りや古い情報にお気づきの場合はお問い合わせよりご連絡ください。