- ソフト・サービス
- ComfyUI
- ComfyUIの画像生成
- ComfyUIのVRAMの節約と速さ|起動オプション・タイル・キャッシュ
ComfyUI
ComfyUIのVRAMの節約と速さ|起動オプション・タイル・キャッシュ
ComfyUIのVRAMの節約と速さ|起動オプション・タイル・キャッシュ
*2026年9月29日に確認した内容です。ComfyUI の公式ドキュメント(「トラブルシューティングの概要」「モデルの問題」・組み込みのノードの「VAEDecodeTiled」「EasyCache」「LazyCache」)と、ComfyUI の公式リポジトリの
comfy/cli_args.py(v0.37.0)によります。起動の記録と画面は、編集部の PC(Windows 11・NVIDIA GeForce RTX 4060・VRAM 8,188MB・RAM 30,421MB)のポータブル版(Python ごと1つのフォルダに入った Windows 向けの ComfyUI。ComfyUI v0.37.0・フロントエンド 1.52.7)で確かめました。
VRAM は、GPU が使う専用のメモリです。VRAM が足りないと、ComfyUI は遅くなったり、「CUDA out of memory」のエラーで止まったりします。起動の引数(起動のコマンドの後ろに付ける指定)で、VRAM の使い方を変えられます。VAE のデコードはタイルに分けて処理でき、キャッシュ(結果を取っておくこと)は、起動の引数とノードで速さとメモリの釣り合いを変えられます。
VRAMが足りないときに起きること
公式ドキュメントでは、「生成がとても遅い」「PC が固まる」「メモリ不足のエラーが出る」を、「パフォーマンスが遅い」ときの症状としています。公式ドキュメントが最初に挙げる直し方は、次の4つです。
- 画像の大きさか、まとめて作る枚数(バッチサイズ)を減らす
- メモリを減らす起動の引数を使う(次の見出し)
- 使っていないアプリを閉じて、RAM と VRAM を空ける
- タスクマネージャーで CPU と GPU の使われ方を見て、どこで詰まっているかを探す
公式ドキュメントのモデルのエラーのページでは、「RuntimeError: CUDA out of memory」(GPU のメモリが足りない)のエラーが出るときも、起動の引数で VRAM の使用量を減らすとしています。GPU と VRAM の量でできることは、「ComfyUIの動作環境|GPU・VRAM・OS」の記事で解説しています。
起動の引数でVRAMの使い方を変える
ポータブル版では、ComfyUI_windows_portable のフォルダでターミナル(フォルダの中の右クリックのメニューから開ける)を開き、起動のコマンドの後ろに引数を付けて入力します。
.\python_embeded\python.exe -s ComfyUI\main.py --windows-standalone-build --lowvram
説明は ComfyUI v0.37.0 の cli_args.py と公式ドキュメントによります。VRAM の使い方を変える引数は、次のとおりです。dynamic VRAM は、cli_args.py の --disable-dynamic-vram の説明によると、見積もりに基づかずにモデルを読み込むしくみで、v0.37.0 では対応している環境で初めから有効になります。
| 引数 | 説明 |
|---|---|
--lowvram | 公式ドキュメントでは、テキストエンコーダを CPU で動かす低 VRAM のモード。v0.37.0 の cli_args.py では、dynamic VRAM が有効なときは何もしない |
--novram | cli_args.py の説明は「--lowvram で足りないとき」だけ。編集部の起動の記録では、VRAM の状態が NO_VRAM になり、dynamic VRAM は有効にならなかった |
--force-fp16 | fp16 に固定する。公式ドキュメントのモデルのエラーのページでは、精度を下げてメモリを減らす方法に挙げている |
--cpu | すべてを CPU で動かす。公式ドキュメントでは、とても遅いので最後の手段 |
--highvram | 使い終わったモデルを CPU のメモリに移さず、GPU のメモリに置いたままにする |
--gpu-only | テキストエンコーダなども含め、すべてを GPU に置いて動かす |
--reserve-vram 2 | OS やほかのソフトのために残す VRAM の量(GB) |
--disable-smart-memory | モデルを VRAM に置いておける場合でも、積極的にふつうの RAM へ移す |
--use-pytorch-cross-attention | PyTorch 2.0 のアテンション(モデルの中の計算の1つ)の関数を使う |
--async-offload | 重みを、計算と並行して RAM と行き来させる。cli_args.py では、NVIDIA の GPU では初めから有効 |
--disable-dynamic-vram | dynamic VRAM を止め、見積もりに基づいてモデルを読み込む |
編集部は、ポータブル版を引数を変えて起動し、起動の記録を見ました。
(引数なし)     Set vram state to: NORMAL_VRAM / DynamicVRAM support detected and enabled
--lowvram        Set vram state to: LOW_VRAM / DynamicVRAM support detected and enabled
--novram         Set vram state to: NO_VRAM(DynamicVRAM の行は出ない)
--cpu            Set vram state to: DISABLED / Device: cpu
編集部の PC(RTX 4060)では、引数なしで dynamic VRAM が有効になりました。--lowvram を付けても dynamic VRAM は有効のままで、cli_args.py の説明のとおり、--lowvram は効かない状態です。--novram と --cpu では、dynamic VRAM の行は出ませんでした。
公式ドキュメントのモデルのエラーのページは、「CUDA out of memory」が出たら --lowvram → --novram → --cpu の順に試すとしています。そのため v0.37.0 では、--novram から試すことになります。精度を下げて小さくしたモデル(fp8 など)を使う方法は、「ComfyUIのモデルのファイル形式と量子化|safetensors・fp8・GGUF」の記事で解説しています。
キャッシュの起動の引数
ComfyUI は、実行したノードの結果をキャッシュします。キャッシュの方式は、起動の引数で変えられます。
| 引数 | 説明(cli_args.py・公式ドキュメント) | 編集部の起動の記録 |
|---|---|---|
(引数なし)・--cache-ram | RAM の余裕に合わせてキャッシュする。v0.37.0 の初めの方式 | Using RAM pressure cache. |
--cache-classic | 前のやり方の、積極的なキャッシュ | キャッシュの行は出ない |
--cache-lru 10 | ノードの結果を、決めた数(この例は10)までキャッシュする。公式ドキュメントでは速いとしている。RAM・VRAM を多く使うことがある | Using LRU cache |
--cache-none | キャッシュしない。RAM と VRAM の使用は減るが、実行のたびにすべてのノードを動かす | Disabling intermediate node cache. |
公式ドキュメントでは、ほかに、サンプリング中のプレビューを出さない --preview-method none で VRAM と処理を節約できるとしています。v0.37.0 の cli_args.py では、プレビューの初めの値はプレビューなしです。
VAEのデコードをタイルに分ける
大きい画像を潜在から画像に戻すときは、VAE Decode の代わりに VAE Decode (Tiled)(画面の名前は「VAEデコード(タイル)」)を使えます。公式ドキュメントによると、画像を小さなタイルに分けて1つずつ処理し、メモリの使用量を抑えます。
タイルの設定と、画像を潜在にする VAE Encode (Tiled) は、「ComfyUIのVAEデコードとエンコード|VAEの差し替え・タイル処理」の記事で解説しています。
キャッシュのノードで速くする
EasyCache は、公式ドキュメントによると、毎ステップ計算し直す代わりに、前のステップの結果を使い回して、サンプリングを速くするノードです。「チェックポイントを読み込む」の「モデル」と、「Kサンプラー」の「モデル」の間につなぎます。
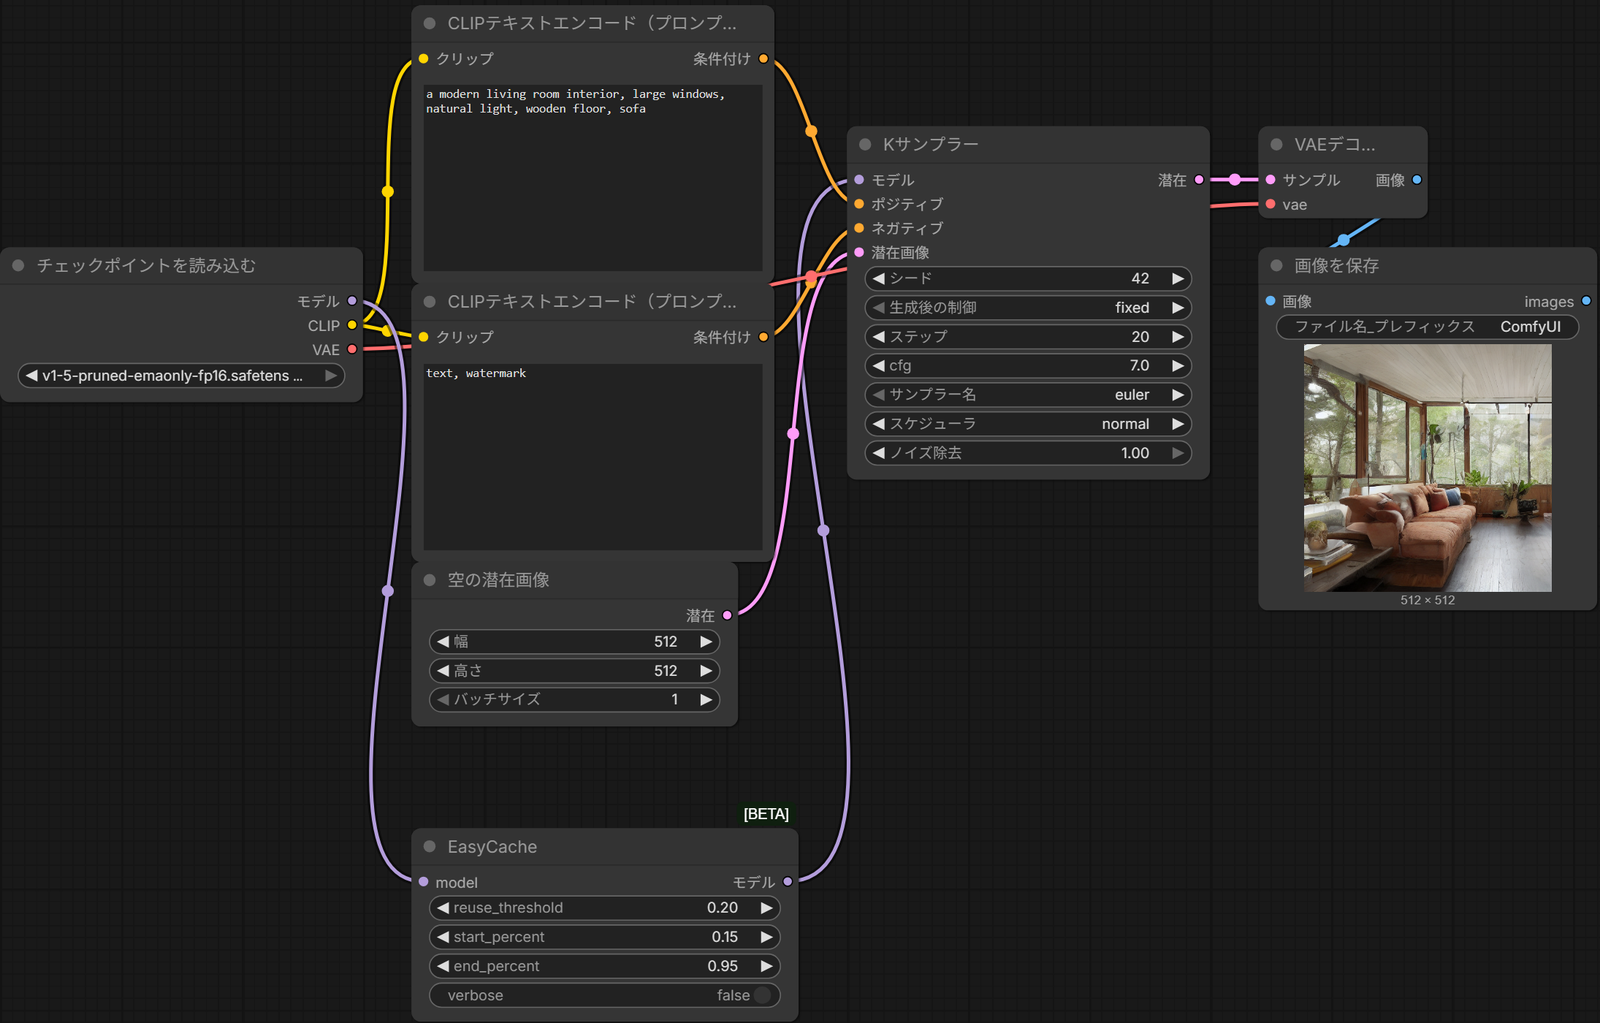
| 値 | 初めの値 | 公式ドキュメントの説明 |
|---|---|---|
| reuse_threshold | 0.2 | キャッシュしたステップを使い回すかを決めるしきい値 |
| start_percent | 0.15 | 使い始めるサンプリングの位置(割合) |
| end_percent | 0.95 | 使い終わるサンプリングの位置(割合) |
| verbose | false | 詳しい情報を記録に出すかどうか |
編集部は、SD1.5(512×512・ステップ 20)で、EasyCache を付けて実行しました(reuse_threshold・start_percent・end_percent は初めの値、記録を見るため verbose だけ true)。ComfyUI の記録には「EasyCache - skipped 10/20 steps (2.00x speedup)」(20ステップのうち10ステップを飛ばした)と出ました。実行にかかった時間は、EasyCache なしが 2.05 秒、ありが 1.20 秒でした。できた画像は、EasyCache なしの画像と比べて、構図や細部が変わりました。
LazyCache は、公式ドキュメントでは、EasyCache の実験的な版で、ComfyUI のモデルと広く合うように作られています。ただし、ふつうは EasyCache より性能が低く、まれな場合にだけ役立つかもしれない、としています。値は EasyCache と同じ4つです。
VRAM の考え方は、「VRAM(ビデオメモリ)とは|GPUが使う専用のメモリと足りないときに起きること」の記事で解説します。モデルが見つからない・読み込めないときは、「ComfyUIのモデルのエラー|形式の違い・見つからないモデル」の記事で解説しています。
会員登録(無料)
記事やテーマのお気に入り・学習履歴・フォローが使えます。
この記事について
PERSC編集部が、建築の制作に関わる知識を実務目線で整理しています。内容は公開・更新日時点の情報にもとづきます。誤りや古い情報にお気づきの場合はお問い合わせよりご連絡ください。