ComfyUIのFluxのControlNet|Flux.1のワークフロー
この記事では、画像を作るモデル Flux.1 で、元の画像の線や深度(カメラからの距離を白黒の濃さで表した画像)から形を決める見本のワークフローを ComfyUI で開き、ノードの組み方を確かめます。
Black Forest Labs が出した FLUX.1 Canny [dev]・Depth [dev] と、コミュニティが公開した Flux 用の ControlNet を扱います。
画面:ComfyUI v0.37.0 ポータブル版(Windows・2026年9月)ComfyUIのFlux ControlNetとは|FLUX.1 Canny・Depthの種類
Flux.1 は、文章から画像を作るモデルで、Black Forest Labs が2024年に公開しました。
Flux.1 で ControlNet(形の手がかりの画像を足す仕組み)のように形を決めるには、Flux.1 用のモデルを使います。
この記事では、そうした Flux.1 用のモデルをまとめて、Flux の ControlNet と呼びます。
FLUX.1 Canny [dev] と FLUX.1 Depth [dev] は、Black Forest Labs が FLUX.1 Tools として出しました。
どちらも、パラメータ(学習で決まる、モデルの中の数値)が120億ある Rectified Flow Transformer(Flux.1 と同じ形の、画像を作るモデル)です。
表の拡散モデルは画像を作る本体のモデルで、LoRA はモデルに足す小さな追加の学習のファイルです。
| モデル | 手がかり | 使い方 |
|---|---|---|
| FLUX.1 Canny [dev] | 元の画像のキャニーの線(写真から取った輪郭の線) | Flux.1 [dev] の拡散モデルの代わりに、このモデルを読む |
| FLUX.1 Depth [dev] | 元の画像の深度 | Flux.1 [dev] の拡散モデルの代わりに、このモデルを読む |
| FLUX.1 Canny [dev] LoRA | キャニーの線 | Flux.1 [dev] に LoRA として足す |
| FLUX.1 Depth [dev] LoRA | 深度 | Flux.1 [dev] に LoRA として足す |
SD1.5(2022年に公開された、文章から画像を作るモデル)の ControlNet は、画像を作るモデルに別のモデルを足して使います。
FLUX.1 Canny [dev] と Depth [dev] は、線や深度を受け取れるように学習し直した、Flux.1 の拡散モデルそのものです。
LoRA 版は、FLUX.1 Canny [dev]・Depth [dev] から取り出した、小さな追加のファイルです。
Flux.1 [dev] に足すと、線や深度で形を決められるようになります。
Flux.1 [dev] の本体を入れてあれば、Canny [dev] や Depth [dev] の本体(1つ約24GB)を別に入れずに済むでしょう。
Black Forest Labs が挙げる、2つのモデルの特長です。
- 細かく質の高い画像になる
- 元の画像の形を保ちながら、プロンプトにもよく従う
- 案内つきの蒸留(guided distillation。大きなモデルの結果を、別のモデルにまねさせて学ばせる学習)で、速く作れる
- 研究のために、モデルのファイル(重み)が公開されている
- ネットで使う API(ほかのプログラムから使う窓口)の Pro 版と、ファイルを公開した Dev 版がある
Flux ControlNetを使う前に|ComfyUIの言葉とPCの要件
ComfyUI の画面の言葉を、この記事での意味とあわせて表にしました。
| 言葉 | 意味 |
|---|---|
| ポータブル版 | Python ごと1つのフォルダに入った、Windows 向けの ComfyUI。NVIDIA の GPU の PC では、展開したフォルダの中の run_nvidia_gpu.bat をダブルクリックして起動する。入れ方はComfyUI ポータブル版|Windowsで解説している |
| ノード | 画像を読み込む・画像を作るなど、処理を1つずつ受け持つ四角い部品 |
| キャンバス | ノードを並べてつなぐ、画面の広い作業の場 |
| ワークフロー | ノードを接続線でつないだ、画像を作るまでの処理の流れ |
| テンプレート | ComfyUI に入っている、すぐに開ける見本のワークフロー |
| サブグラフ | いくつかのノードを1つにまとめたもの |
| モデル | 学習した結果を収めたファイル。画像を作る本体のモデルのほかに、ControlNet などが使う補助のモデルもある |
| Flux.1 | Black Forest Labs が2024年に公開した、文章から画像を作るモデル。[dev] は、モデルのファイルが配られていて、手元の PC で動かせる版 |
| 拡散モデル | 画像を作る本体のモデル |
| LoRA | モデルに足す、小さな追加の学習のファイル |
| テキストエンコーダ | プロンプトの文を、モデルが読める形に変えるモデル。Flux.1 は clip_l と t5xxl の2つを使う |
| VAE | 潜在とふつうの画像を行き来させるモデル。「VAEデコード」は、潜在を画像に戻すノード |
| 潜在 | 画像になる前のデータ。「空の潜在画像」のノードで、作る画像の大きさを決める |
| プロンプト | 作りたい画像を英語などで書いた文。1つめのプロンプト(ポジティブ)に描きたい物を、2つめ(ネガティブ)に描かせたくない物を書く。1つめは、Kサンプラーの「ポジティブ」の点につながっている方 |
| 条件付け | プロンプトの文を、モデルが読める形にしたもの |
| Kサンプラー | ノイズを少しずつ取り除く処理(ステップ)を繰り返して、画像のもとになる潜在を作るノード |
| ControlNet | 画像を作るモデルに、形の手がかりになる画像を足して渡す仕組み |
| Hugging Face | AI のモデルを公開・配布するサイト。ファイルをまとめて置いた場所を、リポジトリと呼ぶ |
テンプレートは、画面の左の列の「テンプレート」から開き、開くとワークフローがキャンバスに出ます。
画面の右上の「実行する」を押すとワークフローが動き、結果は右の「画像を保存」やプレビューのノードに出ます。
Flux.1 のテンプレートを動かすには、大きなモデルを入れる場所と、それを動かせる PC が要るでしょう。
拡散モデル(画像を作る本体のモデル)だけで、1つが 17〜24GB ほどあります。
テンプレートを実行するには、「Flux ControlNetのモデルとライセンス」の節の表のモデルを入れてください。
なお、Flux.1 の基本のワークフロー(2つのテキストエンコーダ・VAE の読み方)は、「ComfyUIのFlux.1のワークフロー|Dev・Schnell・Krea Dev」(準備中)の記事で解説します。
テンプレートやノードの名前は、日本語の表示で書いています。
英語で出ている人は、左下の歯車で設定を開き、検索の欄に Language と打って日本語に替えてください。
表の models/… のフォルダは、ポータブル版では、ComfyUI_windows_portable の中の ComfyUI\models の下にあります。
Flux ControlNetのモデルとライセンス
Flux.1 の ControlNet は、どれも FLUX.1 [dev] Non-Commercial License のモデルです。
ライセンスの本文では、作った画像の使い道とモデルの使い道が分けて書かれています。
仕事で使う前に、記事の最後のリンクからライセンスの本文を読んで確かめてください。
Black Forest Labs の元のリポジトリ(FLUX.1-Canny-dev など)から落とすには、Hugging Face で使う条件に同意する必要があります。
テンプレートは、拡散モデルと LoRA を Comfy-Org/flux1-dev から、テキストエンコーダを comfyanonymous/flux_text_encoders から、VAE を Comfy-Org/Lumina_Image_2.0_Repackaged から落とすように組まれています。
| ファイル | 置き場所 |
|---|---|
flux1-canny-dev.safetensors(Canny の本体。約24GB) | models/diffusion_models |
flux1-dev-fp8.safetensors(Depth の LoRA のテンプレートが読む Flux.1 [dev] の fp8 の版〈数の細かさを落としてファイルを小さくした版〉。約17GB) | models/diffusion_models |
flux1-depth-dev-lora.safetensors | models/loras |
t5xxl_fp16.safetensors | models/text_encoders |
clip_l.safetensors | models/text_encoders |
ae.safetensors | models/vae |
lotus-depth-d-v1-1.safetensors(Depth の LoRA のテンプレートで、深度の画像を作る) | models/diffusion_models |
vae-ft-mse-840000-ema-pruned.safetensors(同じ) | models/vae |
表の中の約24GB・約17GB は、Hugging Face に出ている値です(2026年9月29日)。
表の最後の2つは、Comfy-Org/lotus と stabilityai/sd-vae-ft-mse-original から落とすように組まれています。
Flux Cannyのワークフロー
公式のテンプレート「Flux.1 Canny モデル」は、FLUX.1 Canny [dev] の本体を使うワークフローです。
テンプレートを開く
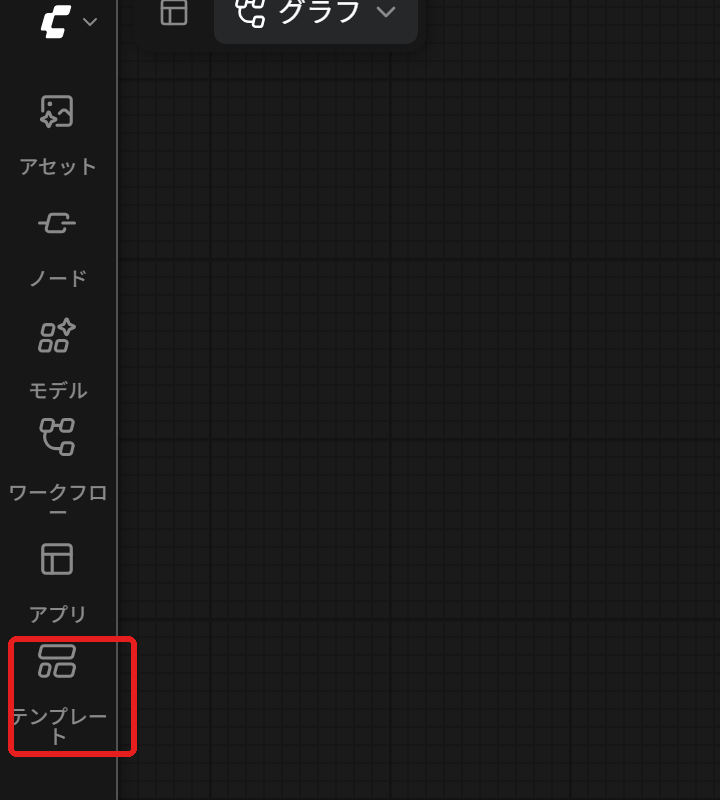
「テンプレート」
画面の左の列で、ComfyUI のマークの下から数えて6つ目にある「テンプレート」を押します。
テンプレートの一覧の画面が開きます。
「Flux.1 Canny」
一覧の画面の右上の検索の欄に、「Flux.1 Canny」と打ちます。
「Flux.1 Canny モデル」のカードが1つ出ます。
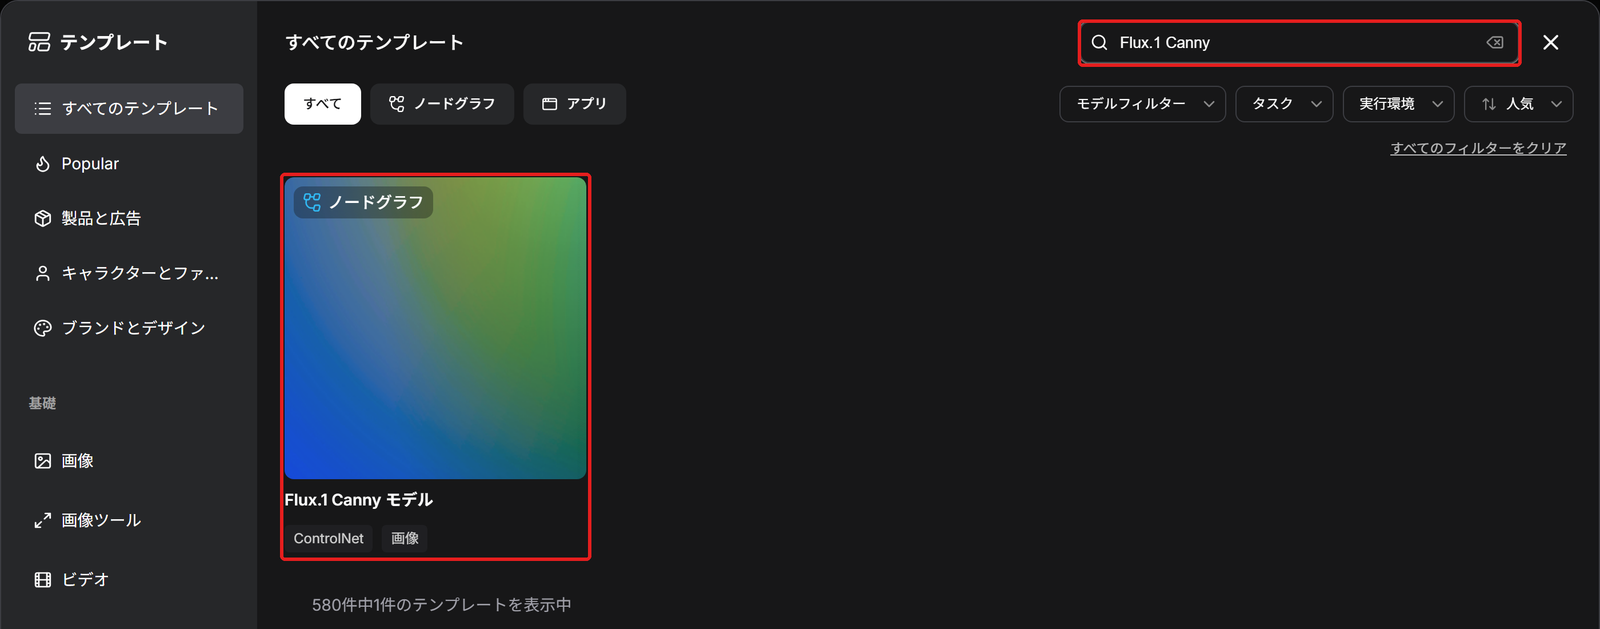
カードを
「Flux.1 Canny モデル」のカードを押します。
キャンバスにワークフローが開きます。
足りないモデルの
入っていないモデルがあると、足りないモデルの一覧の画面が出ます。
一覧の画面の右上の × を押して閉じると、ワークフローの全体が見えます。
一覧の画面からモデルを落とす方法は、ComfyUIのモデルのダウンロードと置き場所|テンプレートからの取得・別のフォルダの指定で解説しています。
ノードの並び
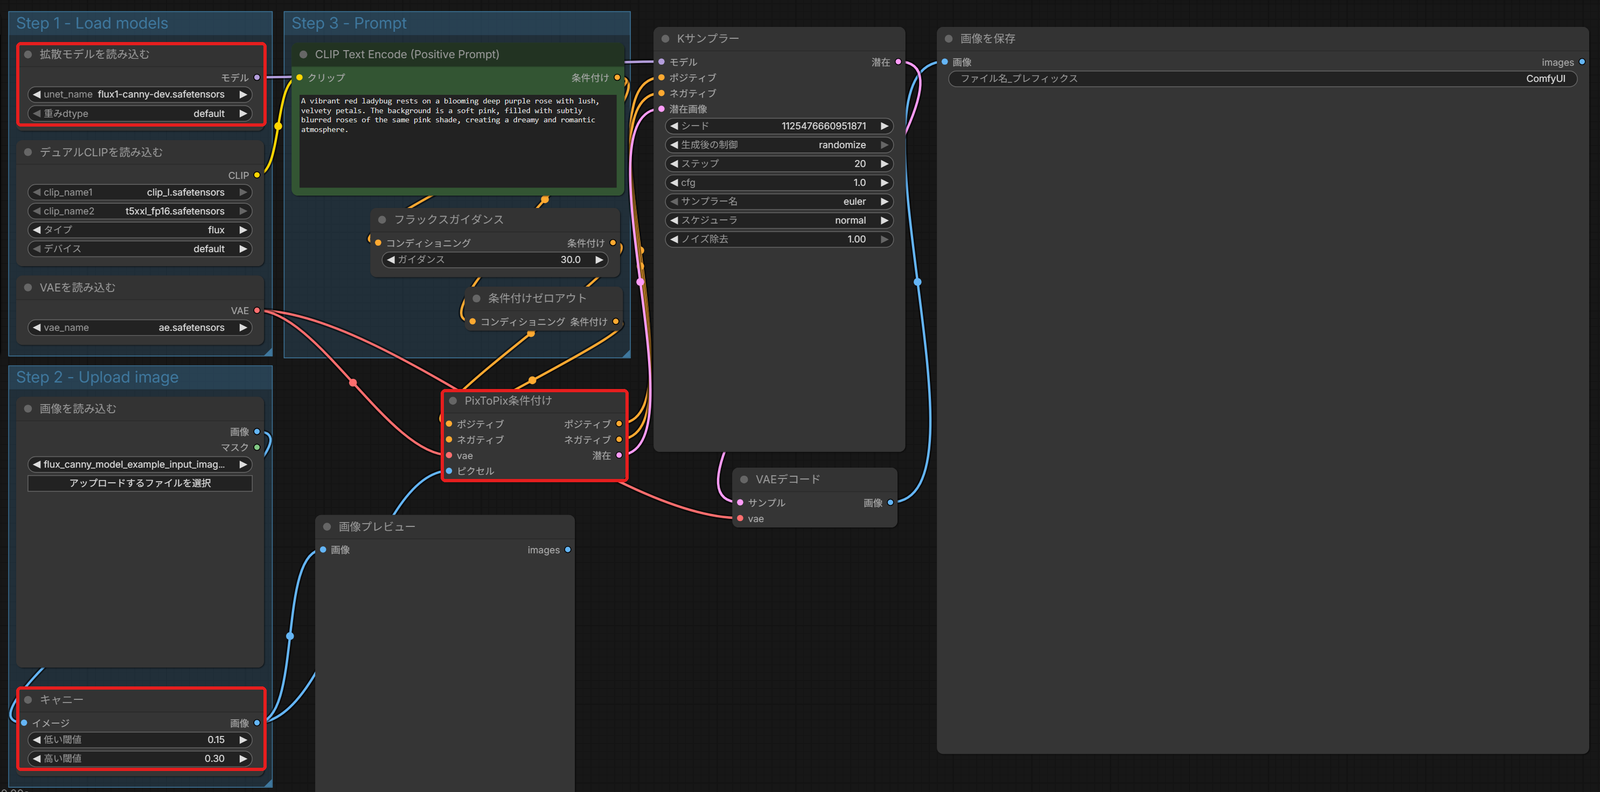
| ノード(画面の名前) | テンプレートの値 | 働き |
|---|---|---|
| 拡散モデルを読み込む | flux1-canny-dev | FLUX.1 Canny [dev] を読む |
| デュアルCLIPを読み込む | clip_l・t5xxl_fp16・タイプ flux | 2つのテキストエンコーダを読む |
| VAEを読み込む | ae | Flux.1 の VAE(ae)を読む |
| 画像を読み込む → キャニー | 低い閾値 0.15・高い閾値 0.30 | 元の画像からキャニーの線を取る |
| CLIP Text Encode (Positive Prompt) → フラックスガイダンス | ガイダンス 30.0 | プロンプトを条件付けにし、プロンプトにどれだけ従わせるかの強さ(ガイダンス)を決める |
| 条件付けゼロアウト | (欄なし) | ネガティブの条件付けを空にする |
| PixToPix条件付け | (欄なし) | 線の画像を VAE で潜在にして、ポジティブとネガティブの条件付けに足す |
| Kサンプラー | ステップ 20・cfg 1.0・euler・normal | 画像のもとになる潜在を作る。cfg は 1.0 のまま使い、プロンプトに従わせる強さはフラックスガイダンスで決める。euler と normal は作り方の種類 |
SD1.5 の ControlNet の「ControlNetを適用」の代わりに、「PixToPix条件付け」が線の画像を条件付けに足しています。
モデルを入れたら、「拡散モデルを読み込む」「デュアルCLIPを読み込む」「VAEを読み込む」の欄で、ファイルの名前が選べているかを確かめましょう。
そのあと、「CLIP Text Encode (Positive Prompt)」の文の欄を作りたい画像の文に書き換え、「画像を読み込む」の「アップロードするファイルを選択」で元の画像を選んでから実行してください。
同じ組み方で、拡散モデルを FLUX.1 Depth [dev] に替えることもできます。
そのときは、手がかりも「キャニー」の線から深度の画像に替えます。
Flux Depth LoRAのワークフロー
公式のテンプレート「Flux.1 深度 Lora」は、Flux.1 [dev] に FLUX.1 Depth [dev] の LoRA を足すワークフローです。
テンプレートの
左の列の「テンプレート」(上から6つ目のボタン)を押します。
テンプレートの一覧が開きます。
「Flux.1 深度」
右上の検索の欄に「Flux.1 深度」と打ち、出てきた「Flux.1 深度 Lora」のカードを押します。
ワークフローがキャンバスに開きます。
サブグラフの
真ん中の「Depth to Image(Flux.1 Dev)」は、いくつかのノードを1つにまとめたサブグラフです。
下のほうの「unet_name」に flux1-dev-fp8.safetensors、「lora_name」に flux1-depth-dev-lora.safetensors が選ばれています。
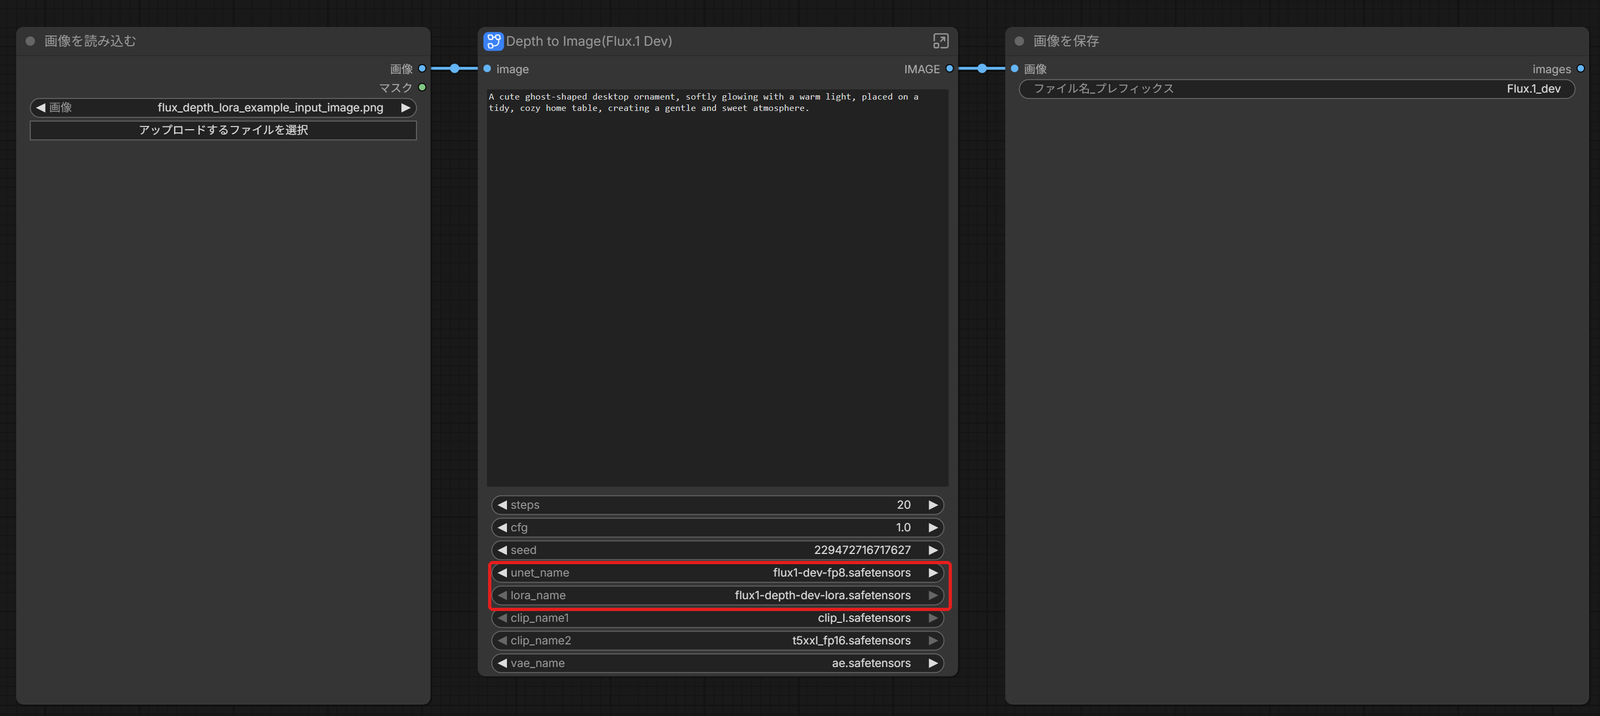
サブグラフの
「Depth to Image(Flux.1 Dev)」の名前の右端の、四角と矢印の絵のボタンを押します。
サブグラフの中のノードが、キャンバスに出ます。
サブグラフの中では、拡散モデル(flux1-dev-fp8)に「LoraLoaderModelOnly」で深度の LoRA を足しています。
元の画像から深度の画像を作る所は、もう1つのサブグラフ「Lotus Depth」です。
Lotus(画像から深度を割り出すモデル)の深度のモデルと、VAE を読んでいます。
サブグラフの外に戻るには、画面の上に並ぶ名前のうち、左のワークフローの名前を押します。
モデルを入れたら、「Depth to Image(Flux.1 Dev)」の文の欄を作りたい画像の文に書き換え、「画像を読み込む」で元の画像を選んでから実行してください。
Lotus の使い方は、ComfyUIの深度と法線の推定|Depth Anything 3・Marigold・MoGe・Lotusで解説しています。
公式ドキュメントのファイルの一覧は flux1-dev.safetensors(約24GB)ですが、v0.37.0 のテンプレートは fp8 の flux1-dev-fp8.safetensors(約17GB)を読む組み方です。
同じ組み方で、LoRA を FLUX.1 Canny [dev] の LoRA に替えることもできます。
そのときは、手がかりも Lotus の深度の画像から、キャニーの線に替えてください。
コミュニティのFlux ControlNet|Union・Canny・Depth
Black Forest Labs のモデルのほかに、コミュニティが公開した Flux 用の ControlNet もあります。
ファイルの置き場所は、どれも ComfyUI/models/controlnet です。
| 公開元 | モデル |
|---|---|
| InstantX | FLUX.1-dev-Controlnet-Canny |
| Shakker Labs | FLUX.1-dev-ControlNet-Depth |
| Shakker Labs | FLUX.1-dev-ControlNet-Union-Pro(1つで複数の種類を扱う Union) |
| XLabs | flux-controlnet-collections(種類ごとのファイルの集まり) |
これらのワークフローの例は、ComfyUI の作者の例のページ「Flux Examples」の「Community Flux Controlnets」に載っています。
Union の種類の選び方は、ComfyUIの複数のControlNetの併用|Union ControlNetを見てください。
元の画像から線や深度の画像を作るには、comfyui_controlnet_aux(ComfyUI にあとから足す、前処理のノードのまとまり)が使えます。
前処理のしかたは、ComfyUIの前処理|プリプロセッサ・comfyui_controlnet_auxの記事のとおりです。
Flux ControlNetのテンプレートが動かないとき
| 起きること | 直し方 |
|---|---|
| テンプレートを開くと、足りないモデルの一覧の画面が出る | 表のファイルを、表の置き場所に入れてください |
| Black Forest Labs のリポジトリからモデルを落とせない | Hugging Face にログインし、リポジトリのページで使う条件に同意します |
| 「拡散モデルを読み込む」に置いたモデルが出ない | models/diffusion_models に入っているかを確かめ、キャンバスで R を押して一覧を読み込み直します |
参考にしたのは、ComfyUI の公式ドキュメントのFlux.1 ControlNetのページと公式のテンプレート、FLUX.1 [dev] Non-Commercial Licenseです(2026年9月29日に確認)。
会員登録(無料)
記事やテーマのお気に入り・学習履歴・フォローが使えます。
この記事について
PERSC編集部が、建築の制作に関わる知識を実務目線で整理しています。内容は公開・更新日時点の情報にもとづきます。誤りや古い情報にお気づきの場合はお問い合わせよりご連絡ください。