Transformer|今の言語モデルの骨組みと注意機構
- Transformer って何?
- アテンション(注意機構)の意味が分からない
- 大規模言語モデルと Transformer の関係を知りたい
ChatGPT などで文章を作る大規模言語モデルの多くは、Transformer という骨組みを使っています。しかし、何をする仕組みで、なぜ広く使われているのかは、名前からは見当がつきにくいものです。
この記事では、Transformer の中心にある注意機構の働きと、それまでの骨組みとの違いを解説します。今の大規模言語モデルの骨組みになった理由も分かります。
Transformer は、2017年に発表された、今の大規模言語モデルの多くが使う骨組み(モデルの中の計算の組み立て方)です。
Transformer とは
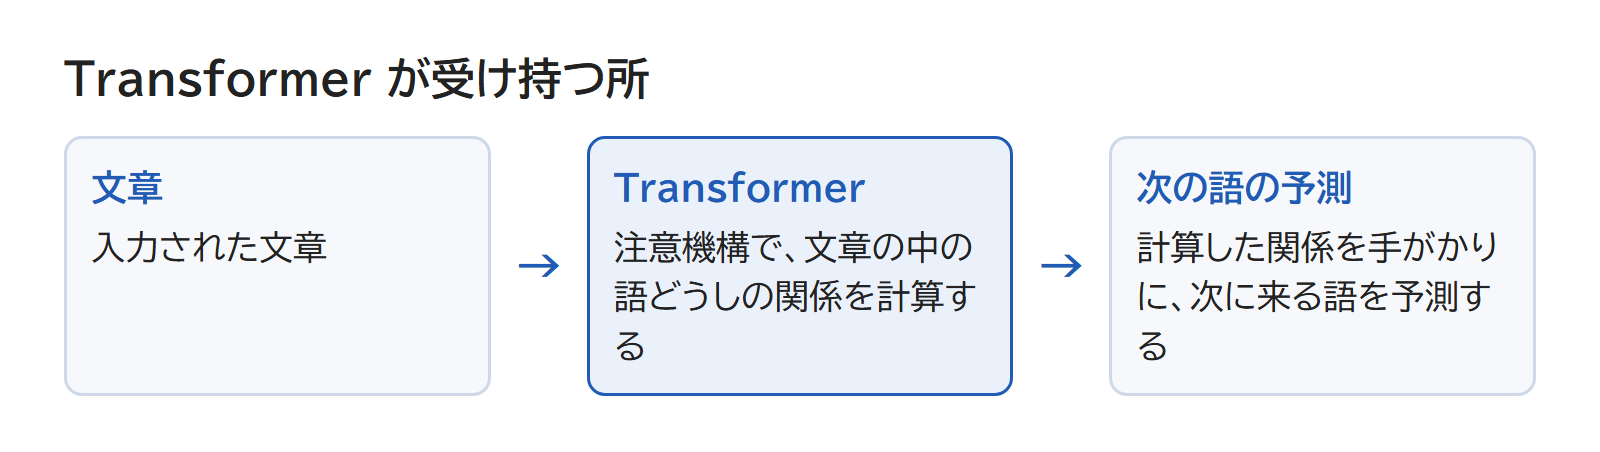
Transformer とは、注意機構だけを中心にして、文章を頭から1語ずつ順に処理せずに計算するモデルの骨組みです。
2017年に、米国 Google が発表しました。
発表のときに試されたのは、英語をドイツ語やフランス語に訳す機械翻訳です。それまでの方法より訳の質が高く、学習にかかる時間も短く済みました。
大規模言語モデルは、膨大な文章で学習し、次の語を予測して文章を作る言語モデルを言います。Transformer は、こうした文章の生成や要約、機械翻訳に用いる大規模言語モデルに向く骨組みです。
Transformer は、ChatGPT のようなサービスの名前ではありません。サービスの中で文章を作る大規模言語モデルの、計算の組み立て方の名前です。
注意機構とは
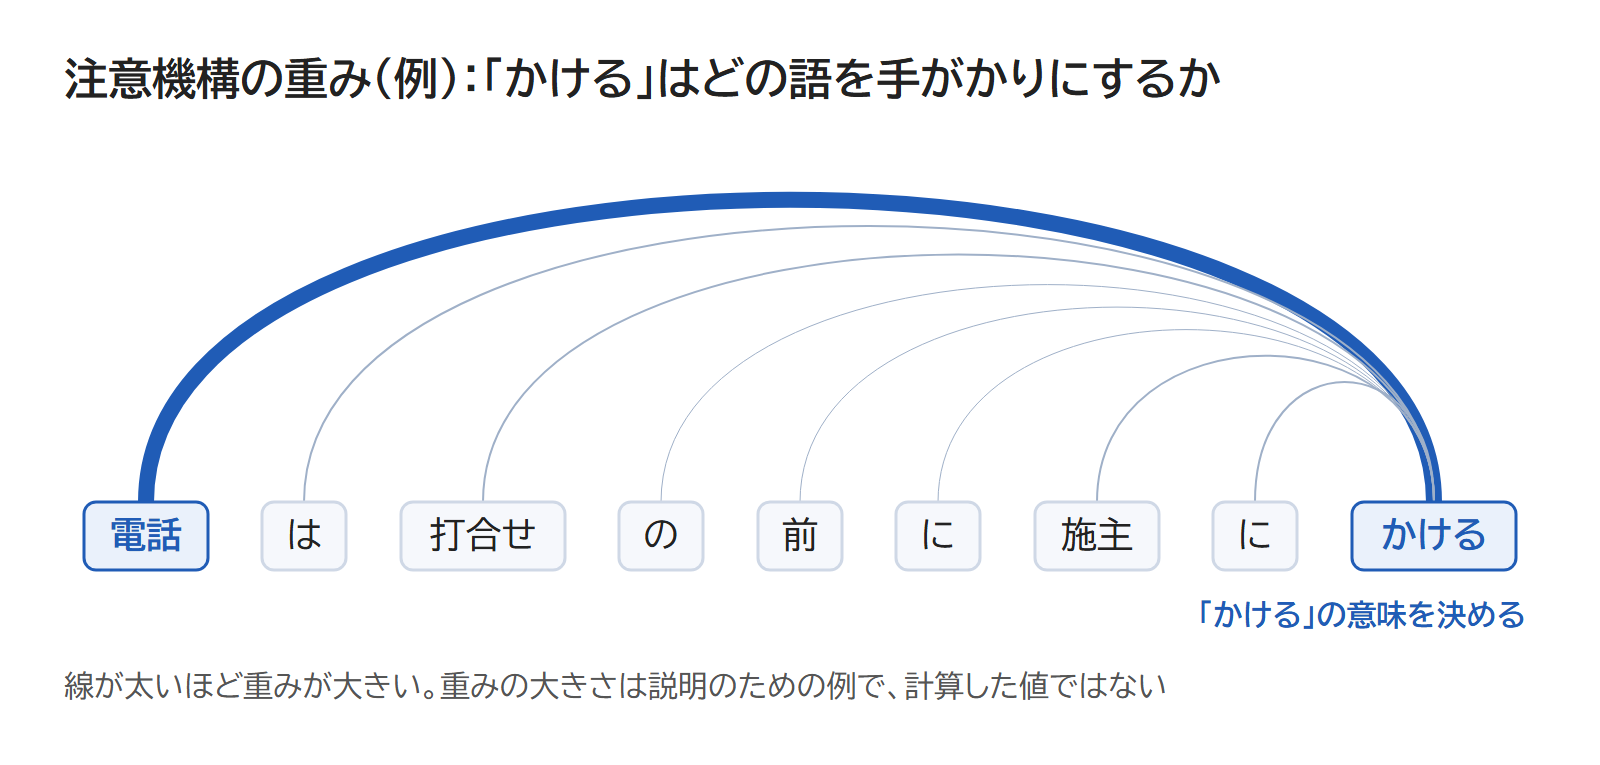
注意機構とは、文章の中の重要な語を選んで重みを付け、離れた所にある語どうしの結びつきを扱う仕組みです。英語では attention(アテンション)と言います。
ここでいう重みは、ある語の意味を決めるときに、ほかの語をそれぞれどれだけ手がかりにするかを表す大きさです。どの語にどれだけ重みを付けるかは、モデルが学習の中で身につけます。
たとえば「電話は、打合せの前に施主にかける」の「かける」が電話をする意味だと分かるのは、離れた所にある「電話」のおかげです。注意機構は、こうした手がかりの語に大きな重みを付けて計算します。
Transformer の注意機構の中心は、同じ文章の中の語どうしで重みを計算する、自己注意(セルフアテンション)です。
なお、Transformer が計算する単位は、語とは限らないトークンです。トークンは文章を扱う最小の単位で、語のことも、語の一部や1文字のこともあります(この記事では分かりやすく「語」と書きます)。
Transformer がそれまでの骨組みと違う所
注意機構の働きが分かると、それまでの骨組みとの違いが見えてきます。Transformer の前は、RNN(再帰型ニューラルネットワーク)などの骨組みが主流でした。
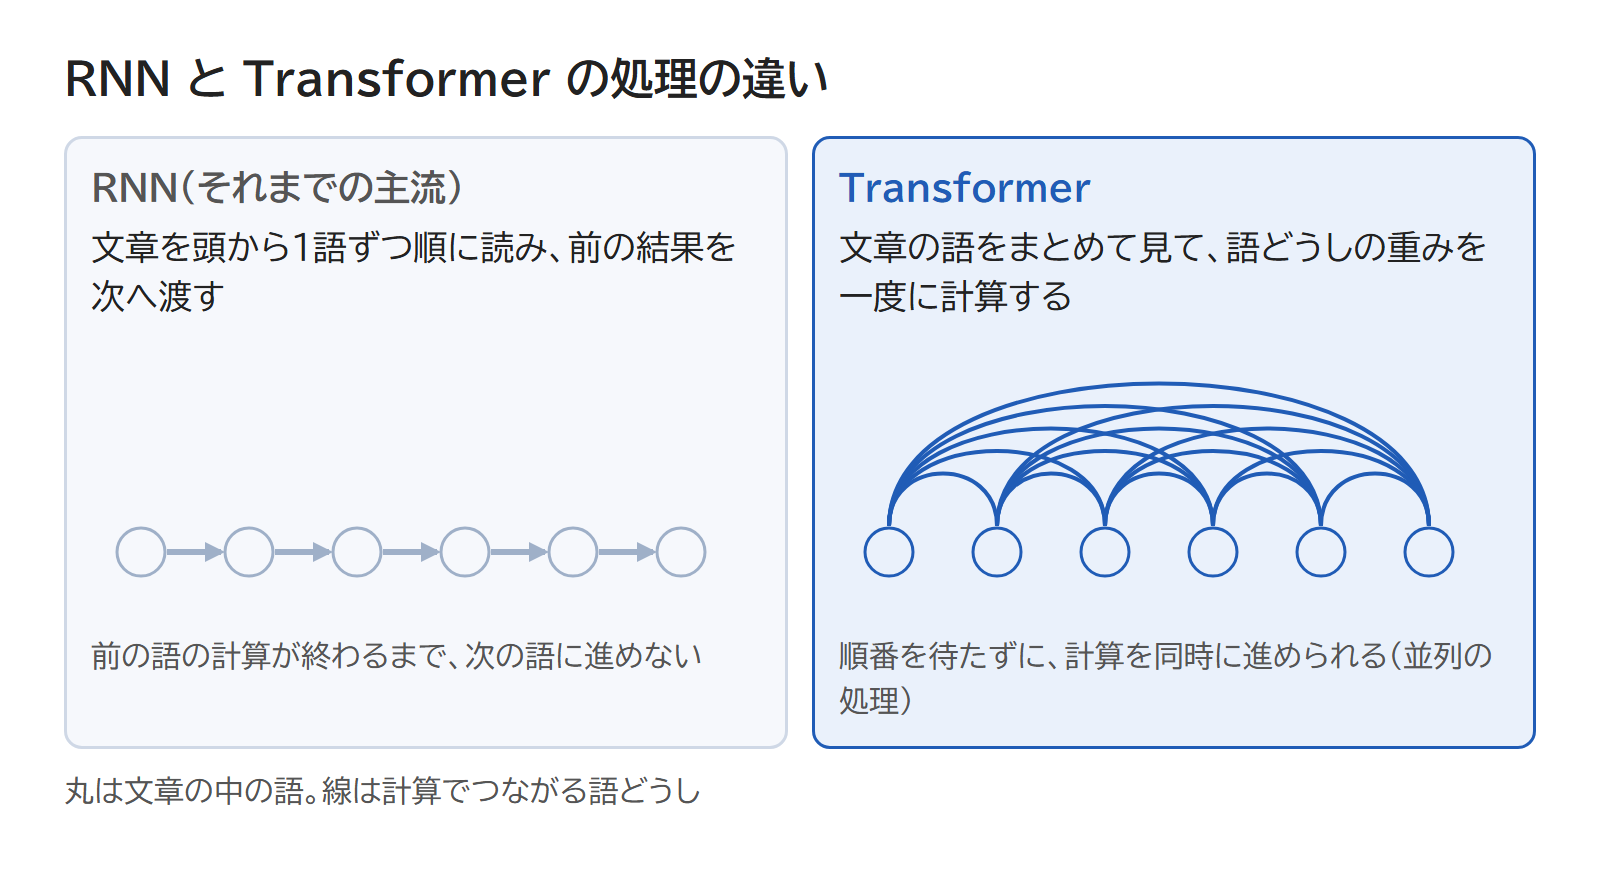
RNN は、文章を頭から1語ずつ順に読み、前の語までの計算の結果を次の語へ渡して進みます。RNN と比べたときの Transformer の違いは、次の2つです。
- 文章をまとめて計算できる
- 離れた語の関係を扱いやすい
文章をまとめて計算できる
Transformer は、注意機構で語どうしの重みを直接計算するので、前の語の結果を待つ必要がありません。そのため、文章の語をまとめて見て、順番を待たずに計算を同時に進める並列の処理が可能です。
RNN では、前の語の計算が終わるまで、次の語の計算に進めません。並列に計算できる Transformer は、その分、学習にかかる時間を短くできました。
離れた語の関係を扱いやすい
RNN は、文章が長くなると、前のほうの語の情報を後ろまで伝えにくい骨組みです。そのため、離れた所にある語どうしの関係をとらえるのが苦手でした。
注意機構は、ある語と、文章の中のほかの語との間で重みを計算します。語がどれだけ離れていても、手がかりの語に直接重みを付けられるので、離れた語の結びつきも扱えます。
ただし、文章を作るときに次の語を1つずつ予測していくのは、Transformer でも同じです。まとめて計算する対象は、すでにある文章の語どうしの関係になります。
大規模言語モデルの骨組みになった理由
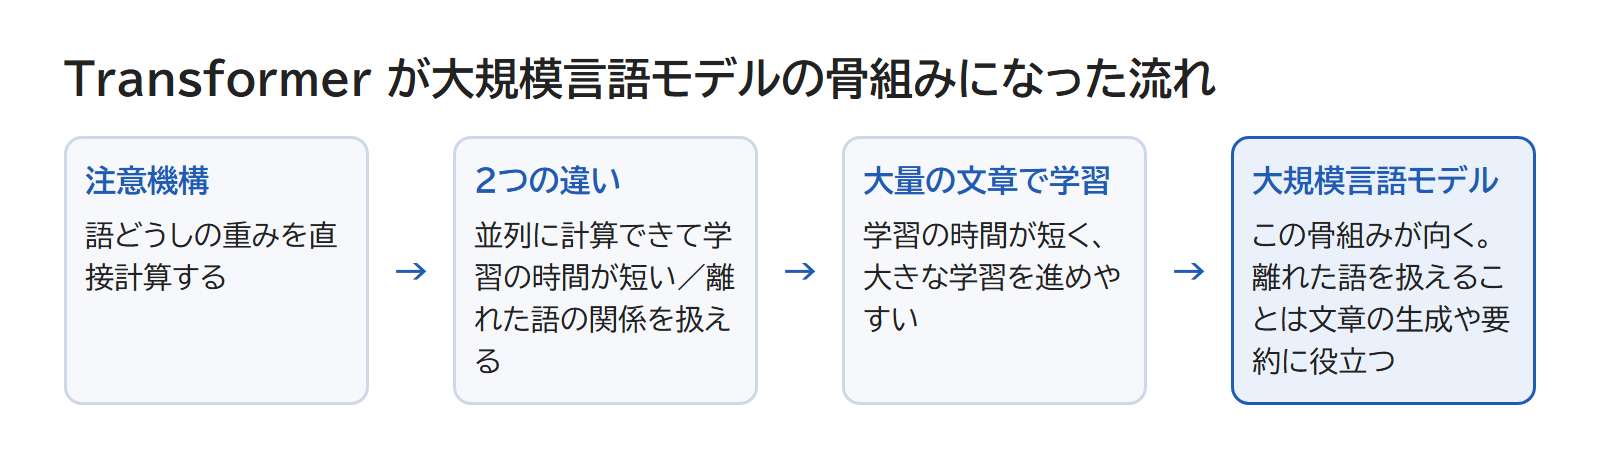
Transformer が大規模言語モデルの骨組みになったのは、前の節の2つの違いが、大量の文章で学ぶ言語モデルに向いていたからです。並列に計算できるので、大量の文章で効率よく学習させられました。
大規模言語モデルは、それまでの言語モデルより計算量・データ量・パラメータ数(確率の計算に使う係数の数)が大きい言語モデルです。
学習の時間を短くできる Transformer は、こうした大きな学習を進めやすくしました。
もう1つの違いの、離れた語の関係を扱えることも、文章の生成や要約に役立ちます。長い文章でも、前のほうの語を手がかりにして次の語を予測できるためです。
注意機構から Transformer の仕組みをつかもう
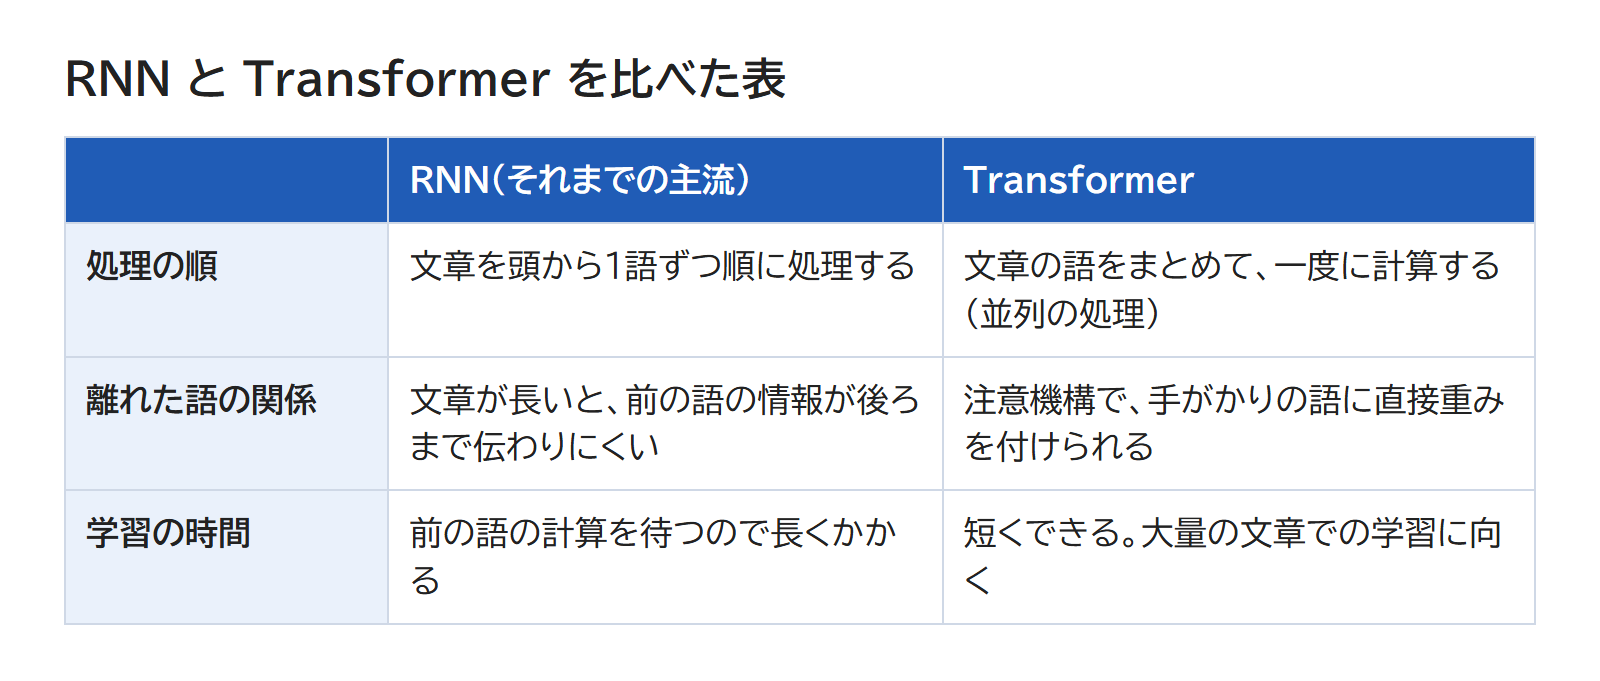
Transformer は、注意機構で語どうしの重みを計算する、今の大規模言語モデルの多くが使う骨組みです。それまでの骨組みとの違いは、次の2つです。
- 文章をまとめて計算できる
- 離れた語の関係を扱いやすい
大規模言語モデルの説明で Transformer やアテンションという語を見かけたら、語どうしの関係を重みで計算する仕組みのことだと思い出してみてください。
あわせて読みたい
- 言語モデルと大規模言語モデル|次の語を予測して文章を作る仕組み — 次の語を予測して文章を作る仕組みから知りたいとき
- 事前学習と調整|人の評価で答え方を整える仕組み — Transformer を骨組みにした言語モデルを、どう学習させるかを知りたいとき
- 「トークン|文章を数える単位」(準備中) — 注意機構が計算の単位にしているトークンを知りたいとき
- UNetとDiT|モデルの骨組みの違い — 画像生成AIで Transformer がどう使われるかを知りたいとき
会員登録(無料)
記事やテーマのお気に入り・学習履歴・フォローが使えます。
この記事について
PERSC編集部が、建築の制作に関わる知識を実務目線で整理しています。内容は公開・更新日時点の情報にもとづきます。誤りや古い情報にお気づきの場合はお問い合わせよりご連絡ください。
PERSC では、記事の次の段としてオンライン講座とプラグインを用意しています。