事前学習と調整|人の評価で答え方を整える仕組み
- 事前学習とは何?
- ファインチューニングや RLHF の意味が分からない
- AIがどうやって質問に答えられるようになるのか知りたい
大規模言語モデルは、膨大な文章で次の語を予測するように学んで作られます。しかし、次の語を予測する学習が、質問に答えたり指示に従ったりする力にどうつながるのかは、すぐには分からないものです。
この記事では、最初の学習である事前学習と、そのあとに答え方を整える調整を解説します。人が書いた手本と人の評価で、答え方がどう整うのかも分かります。
事前学習は、言語モデルが最初に受ける、次の語を当てる学習です。
事前学習とは
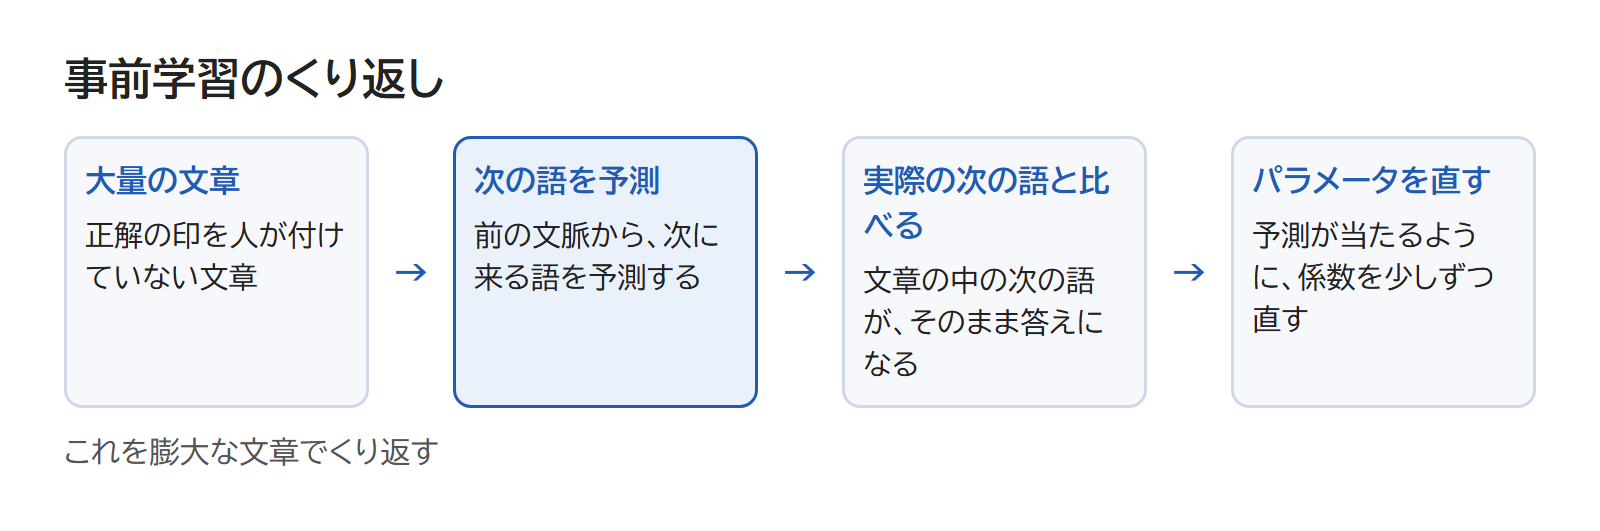
事前学習とは、ラベル(正解の印)を人が付けていない大量の文章で、前の文脈から次の語を予測するように言語モデルを学ばせる、最初の学習です。
言語モデルは、ある語の後に別の語が出てくる確率を表したものを言います。
ラベルが要らないのは、文章の中の次の語そのものが答えになるためです。たとえば「明日の打合せは午前10時からです」という文なら、「明日の打合せは午前」の次を予測させ、答えの「10時」と比べられます。
学習では、予測が実際の次の語に当たるように、モデルの中のパラメータ(確率の計算に使う係数)をくり返し直します。膨大な文章でこの事前学習をした言語モデルが、大規模言語モデルです。
事前学習だけのモデルが苦手なこと
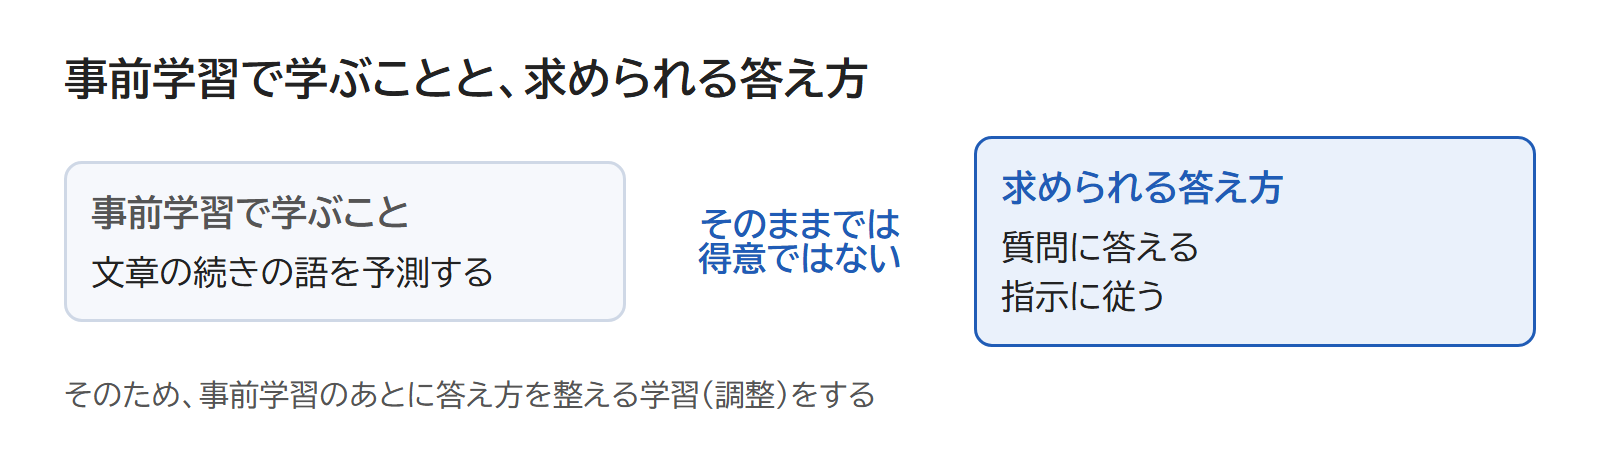
事前学習しただけの言語モデルは、質問に答えたり指示に従ったりするのが得意ではありません。事前学習で学ぶのは文章の続きを予測することで、質問に答えることそのものではないためです。
そのため、事前学習しただけのモデルに望む答え方をさせるには、頼み方にかなりの工夫が要ります。パラメータの数を増やしてモデルを大きくしても、それだけで使う人の意図に沿うのがうまくなるわけではありません。
そこで、事前学習のあとに行うのが、答え方を整えるための学習です。
事前学習のあとの調整
事前学習したモデルを、特定の用途や人の意図に合わせる追加の学習を、事後学習と言います。この記事では、事後学習のうち答え方を整えるものを「調整」と呼びます。
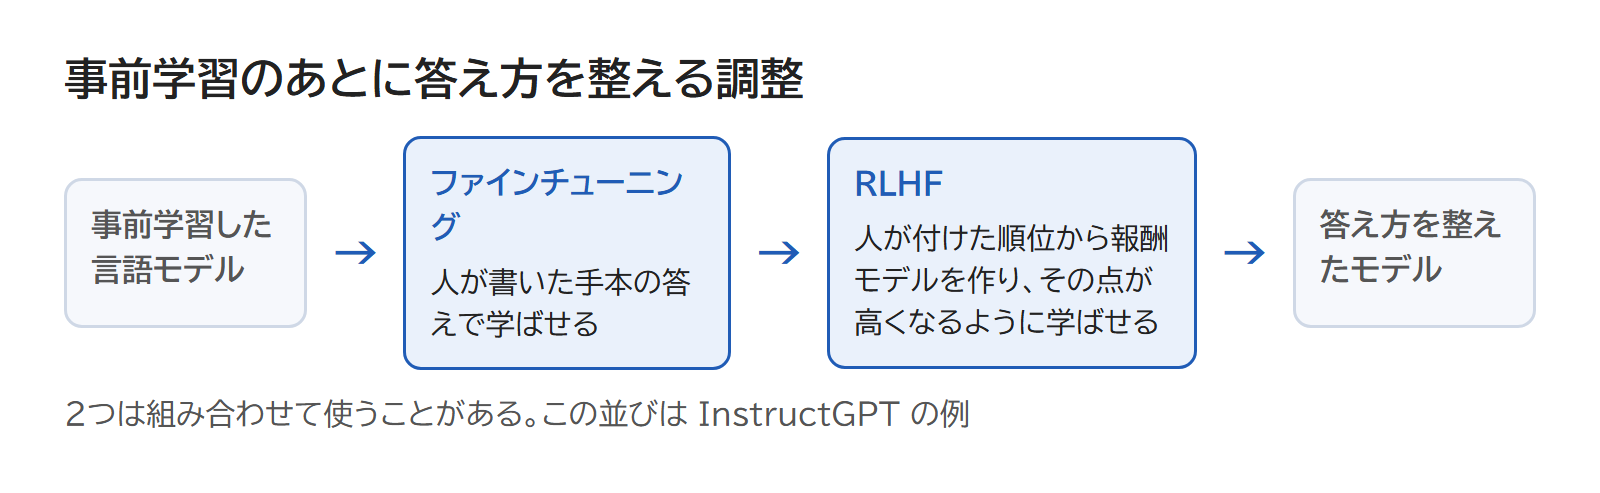
この記事で取り上げる調整の方法は、次の2つです。2つは組み合わせて使うことがあり、後の節の InstructGPT では順に使っています。
- ファインチューニング
- RLHF
ファインチューニング
ファインチューニングとは、学習済みのモデルに追加のデータで学習させ、分野や用途に合わせることです。答え方を整えるときは、たとえば人が書いた望ましい答えを手本にして学ばせます。
手本で学ばせると、モデルは手本の答え方の特徴をまねるようになります。質問に答える手本を学べば、質問に答える形の文章を作りやすくなるわけです。
RLHF
RLHF とは、人の評価を使って強化学習をし、モデルの答えを人の好みに近づける方法です。
RLHF は reinforcement learning from human feedback の頭文字で、「人間のフィードバックによる強化学習」と訳されます。
強化学習は、試行錯誤しながら、得られる報酬(よい結果に与える点)が大きくなるように学ぶ方法です。RLHF では、この報酬を人の評価から作ります。
まず、モデルが出した2つ以上の答えを人が比べ、順位を付けます。その順位から作るのが、答えのよさを点で見積もる別のモデル(報酬モデル)です。
そのうえで、報酬モデルの点が高くなるように言語モデルを学ばせると、順位の上の答えに近い答えを出しやすいモデルになります。
対話型AIが不適切な質問を断るようにしたり、学習データにある差別などの偏りを除いたりするのも、RLHF の使い道です。
手本と順位で調整した InstructGPT
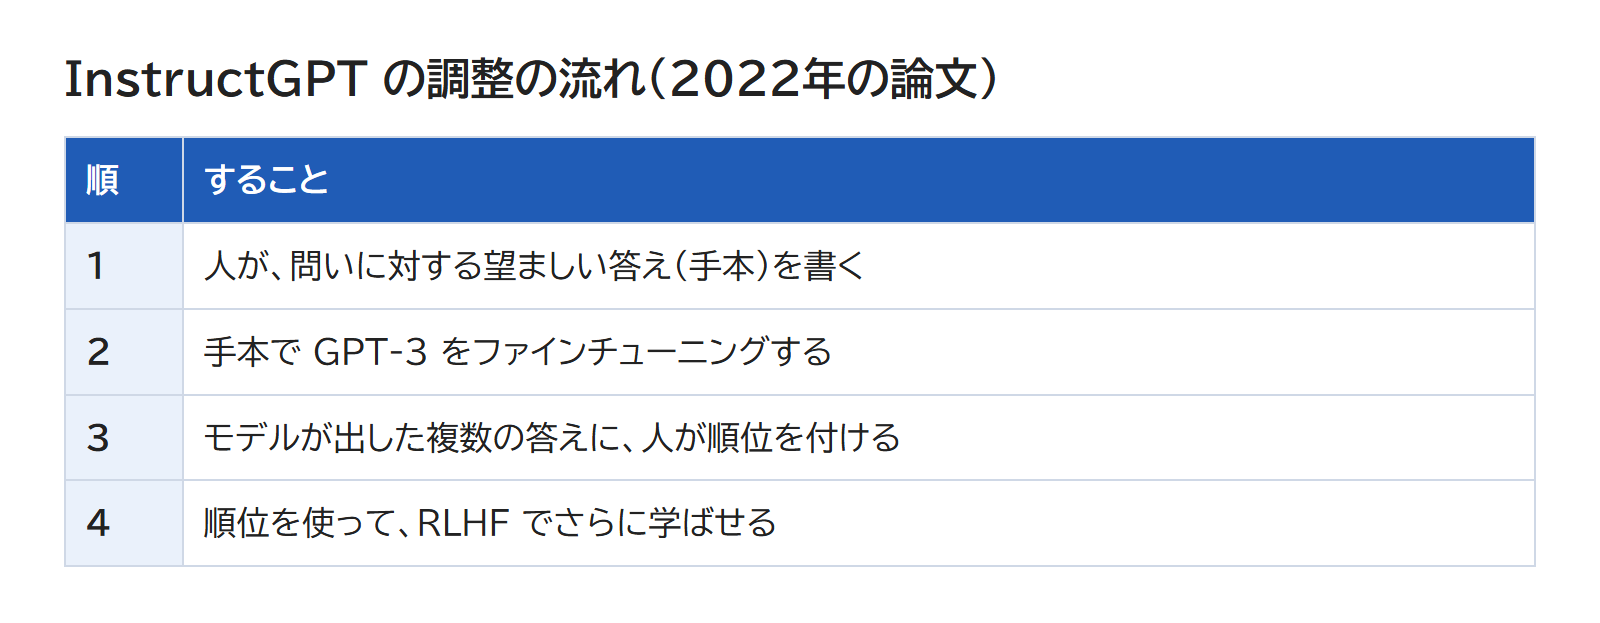
InstructGPT は、ファインチューニングと RLHF を順に使って調整したモデルの例です。
InstructGPT は、ChatGPT を提供する OpenAI が2022年に発表しました。もとにしたのは、GPT-3 という大規模言語モデルです。
まず、人が問いに対する望ましい答えを書き、それを手本に GPT-3 をファインチューニングしました。次に、モデルが出した複数の答えに人が順位を付け、その順位を使って RLHF でさらに学ばせています。
InstructGPT は大きさの違うものがいくつか作られ、人が答えを比べた評価では、GPT-3 の100分の1ほどのパラメータしかない InstructGPT の答えのほうが好まれました。
パラメータの数だけで、答えの好まれ方が決まるわけではないことを示した結果です。
Anthropic の対話型AIの Claude も、もとになる大規模言語モデルを、ファインチューニングと RLHF で学ばせています(2026年10月時点)。
事前学習と調整の違いから AI の答え方をつかもう
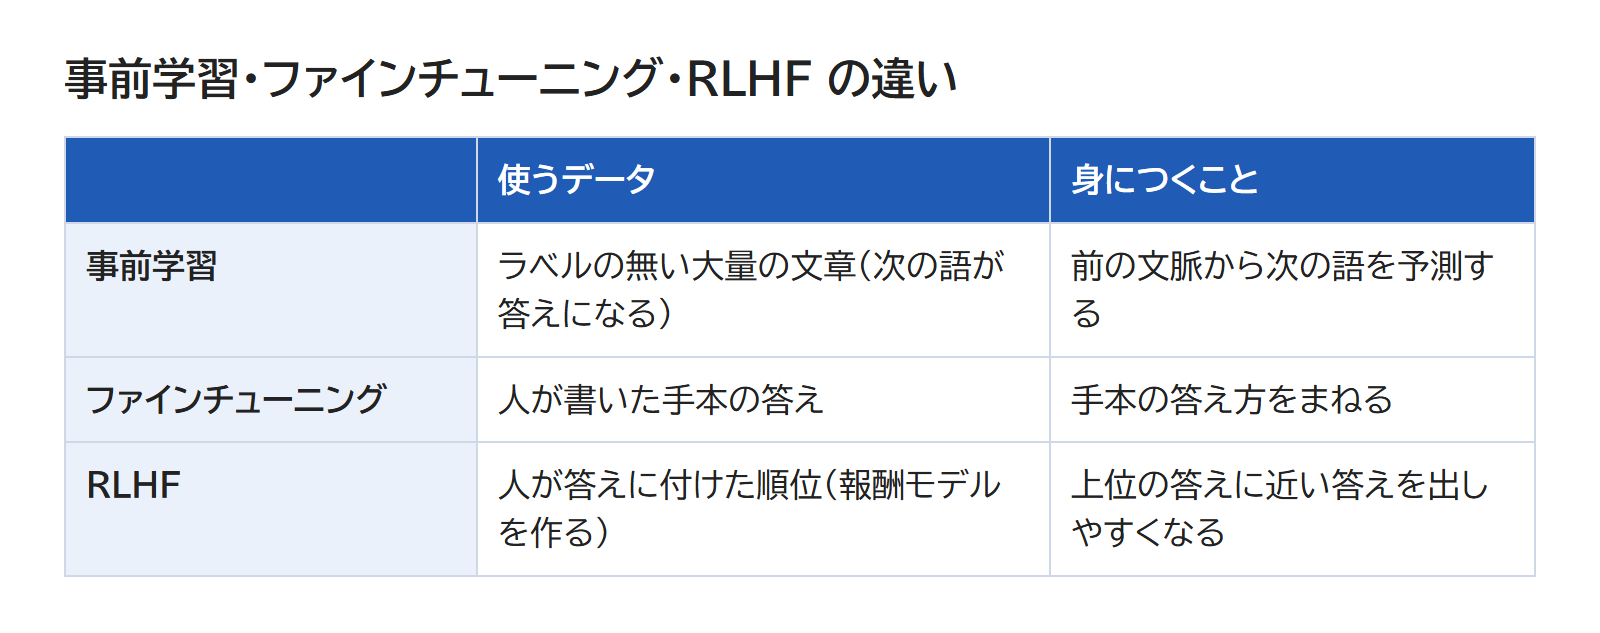
事前学習は、大量の文章で次の語を予測できるように学ばせる最初の学習です。そのあとに答え方を整える調整として、この記事で取り上げた方法は次の2つです。
- ファインチューニング:人が書いた手本で学ばせる
- RLHF:人が付けた順位で学ばせる
AIの答えが質問に沿った形で返ってきても、事実や数は元の資料で確かめてから使ってください。
あわせて読みたい
- 言語モデルと大規模言語モデル|次の語を予測して文章を作る仕組み — 事前学習で身につける、次の語の予測の仕組みを知りたいとき
- Transformer|今の言語モデルの骨組みと注意機構 — 学習させる言語モデルの、中の計算の組み立てを知りたいとき
- 「AIの迎合|相手に合わせすぎる答え」(準備中) — 人の評価で整える学習が、相手に合わせすぎる答えを生む理由を知りたいとき
- 「AIの偏り|バイアス」(準備中) — 学習データなどから答えに偏りが出る理由を知りたいとき
会員登録(無料)
記事やテーマのお気に入り・学習履歴・フォローが使えます。
この記事について
PERSC編集部が、建築の制作に関わる知識を実務目線で整理しています。内容は公開・更新日時点の情報にもとづきます。誤りや古い情報にお気づきの場合はお問い合わせよりご連絡ください。
PERSC では、記事の次の段としてオンライン講座とプラグインを用意しています。