UNetとDiT|モデルの骨組みの違い
- UNet と DiT って何が違うの?
- モデルの説明に出てくる Transformer の意味が分からない
- 画像生成AIのモデルの骨組みの違いを知りたい
画像生成AIのモデルの説明には、UNet・DiT・Transformer といった名前が出てきます。どれもモデルの中の作りを表す語なので、画像を作る側からは違いが見えにくい名前です。
この記事では、拡散モデルの骨組みの U-Net と DiT の作りを解説します。Stable Diffusion や FLUX.1 のモデルが、どちらの作りの骨組みかも分かります。
U-Net は画像を縮めてから広げる作り、DiT は潜在表現を小片に分けて並べる作りの骨組みです。
拡散モデルの骨組みとは
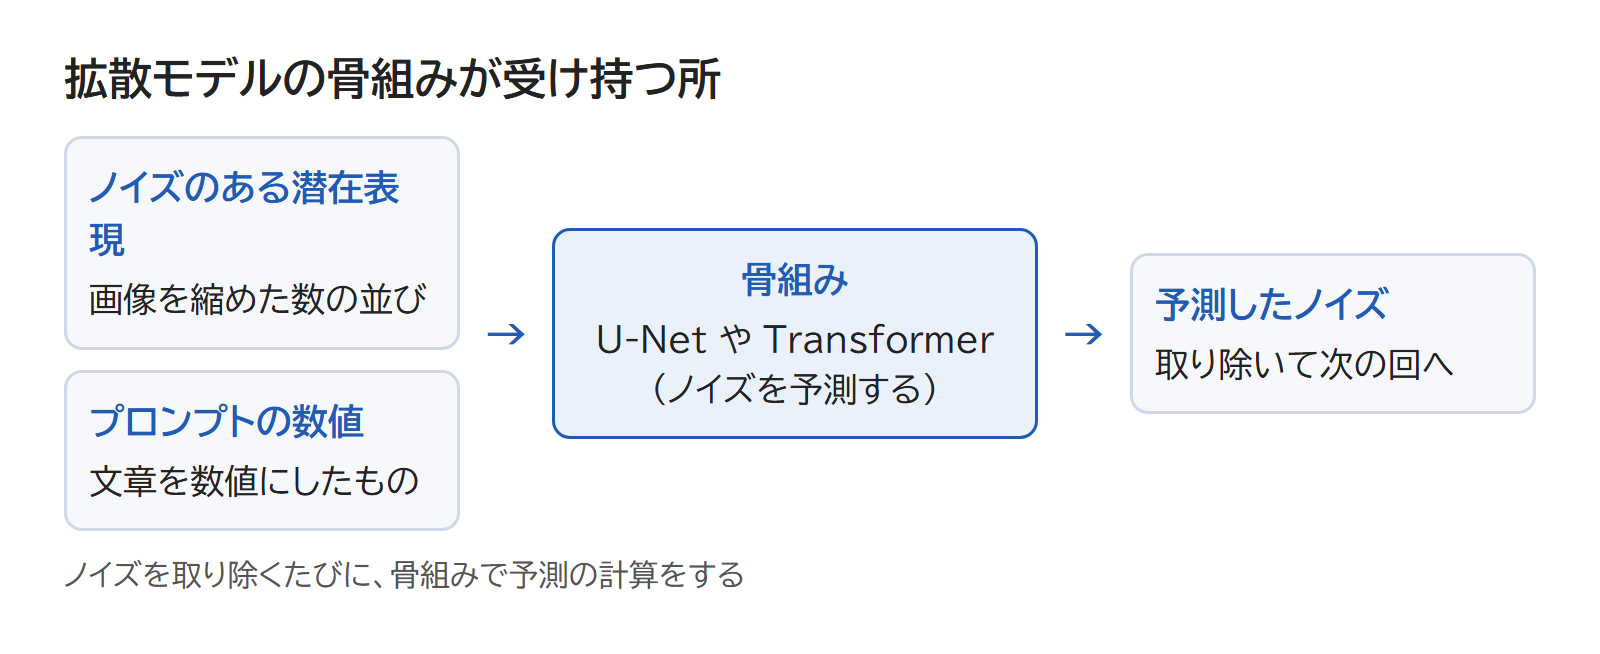
拡散モデルの骨組み(英語で backbone)とは、ノイズを予測する部分のネットワークの作りのことです。
拡散モデルは、ノイズ(でたらめな点のざらつき)だけの状態から、ノイズを予測して取り除くことをくり返して画像を作ります。
この予測を受け持つ骨組みは、ディープラーニング(層の数が多いニューラルネットワークを使う機械学習)のネットワークです。
画像生成AIの Stable Diffusion では、骨組みがノイズのある潜在表現(画像を縮めた数の並び)を受け取ります。そして、プロンプトの数値を手がかりに、その中のノイズを予測します。
拡散モデルの骨組みには、長く U-Net が使われてきました。2022年には、それを Transformer に置き換えた DiT が論文で発表されています。
U-Netの作り
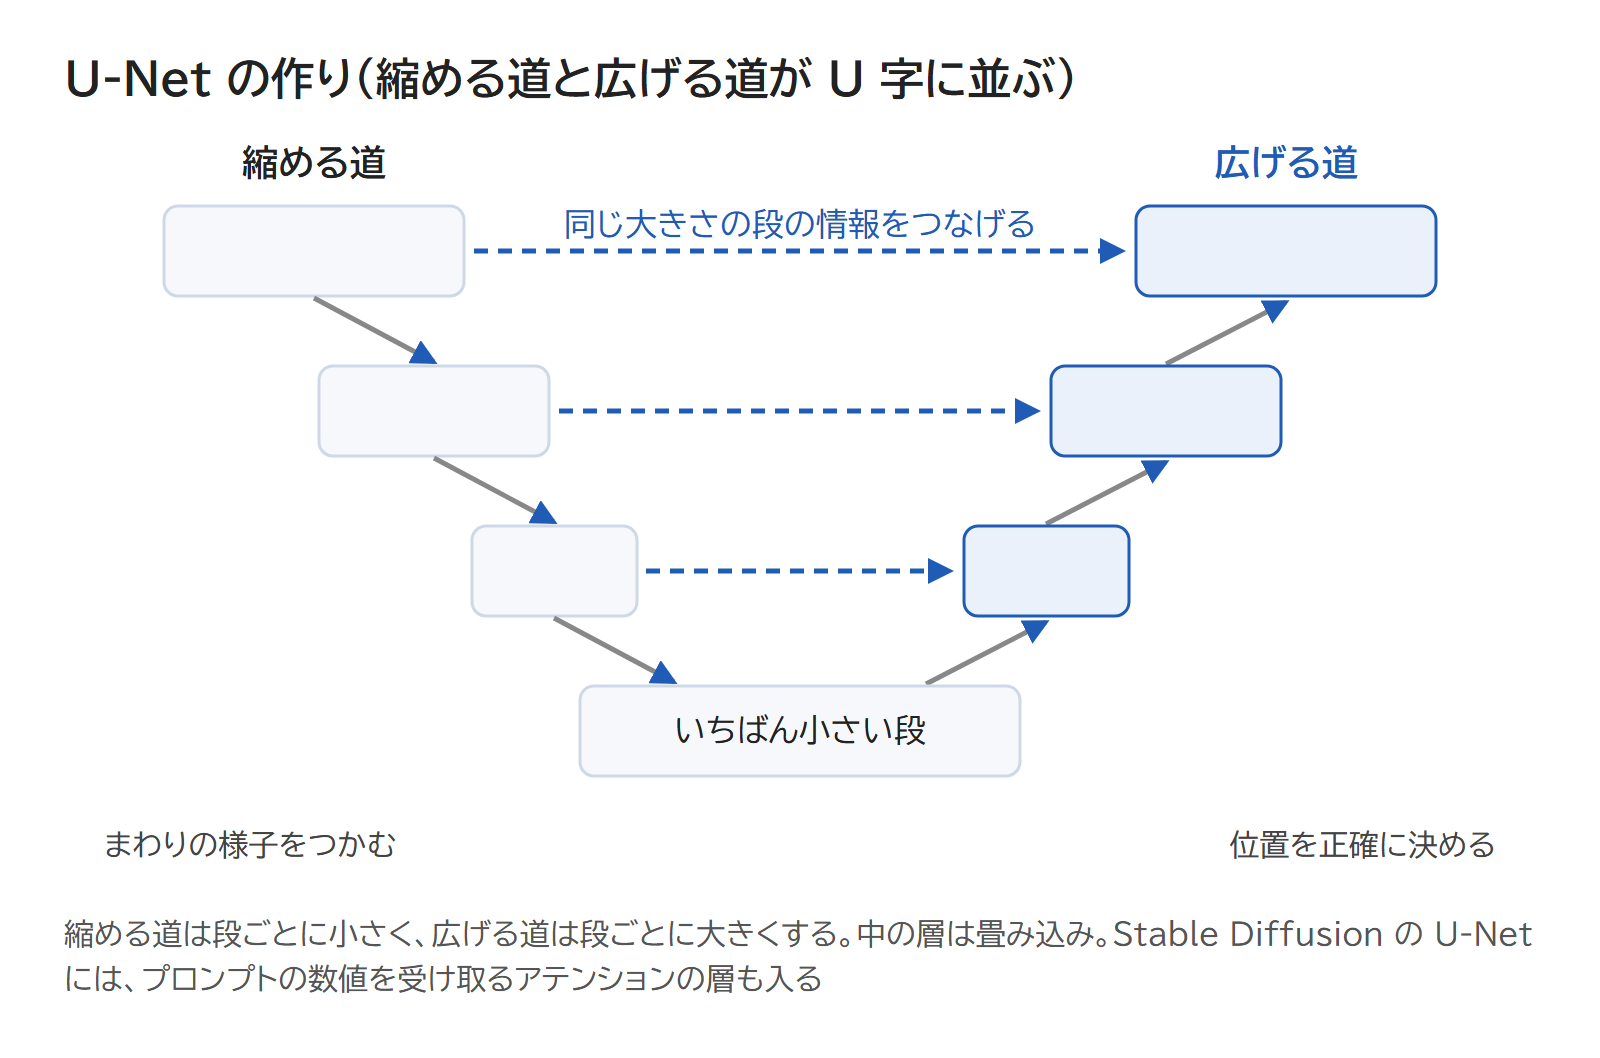
U-Net とは、画像を縮める道と広げる道が U 字に並んだ、畳み込みのネットワークです。2015年に、生物医学の画像の中で領域を分けるために作られました。
畳み込みのネットワーク(畳み込みニューラルネットワーク)は、情報量の圧縮や要約の手続きをくり返すネットワークで、画像の認識で最もよく使われる種類です。
U-Net の縮める道は画像を段ごとに小さくしながらまわりの様子をつかみ、広げる道は段ごとに大きくしながら位置を正確に決めます。
Stable Diffusion では、U-Net が縮めて広げるのは潜在表現です。
位置を決めるために、広げる道の各段は、縮める道の対応する段の情報をつなげて使います。図の横向きの矢印が、このつながりです。
2020年の DDPM という拡散モデルの論文も、ノイズを予測する骨組みに U-Net を使っています。Stable Diffusion 1.5 と SDXL の骨組みも U-Net です。
DiTの作り
DiT(Diffusion Transformer)とは、拡散モデルの骨組みを、U-Net から Transformer に置き換えたものです。2022年に論文で発表されました。
Transformer は、2017年に Google が発表したディープラーニングのモデルです。文章を頭から順に処理していた前のモデルと違い、並列の処理で大量のデータを効率よく学習できます。
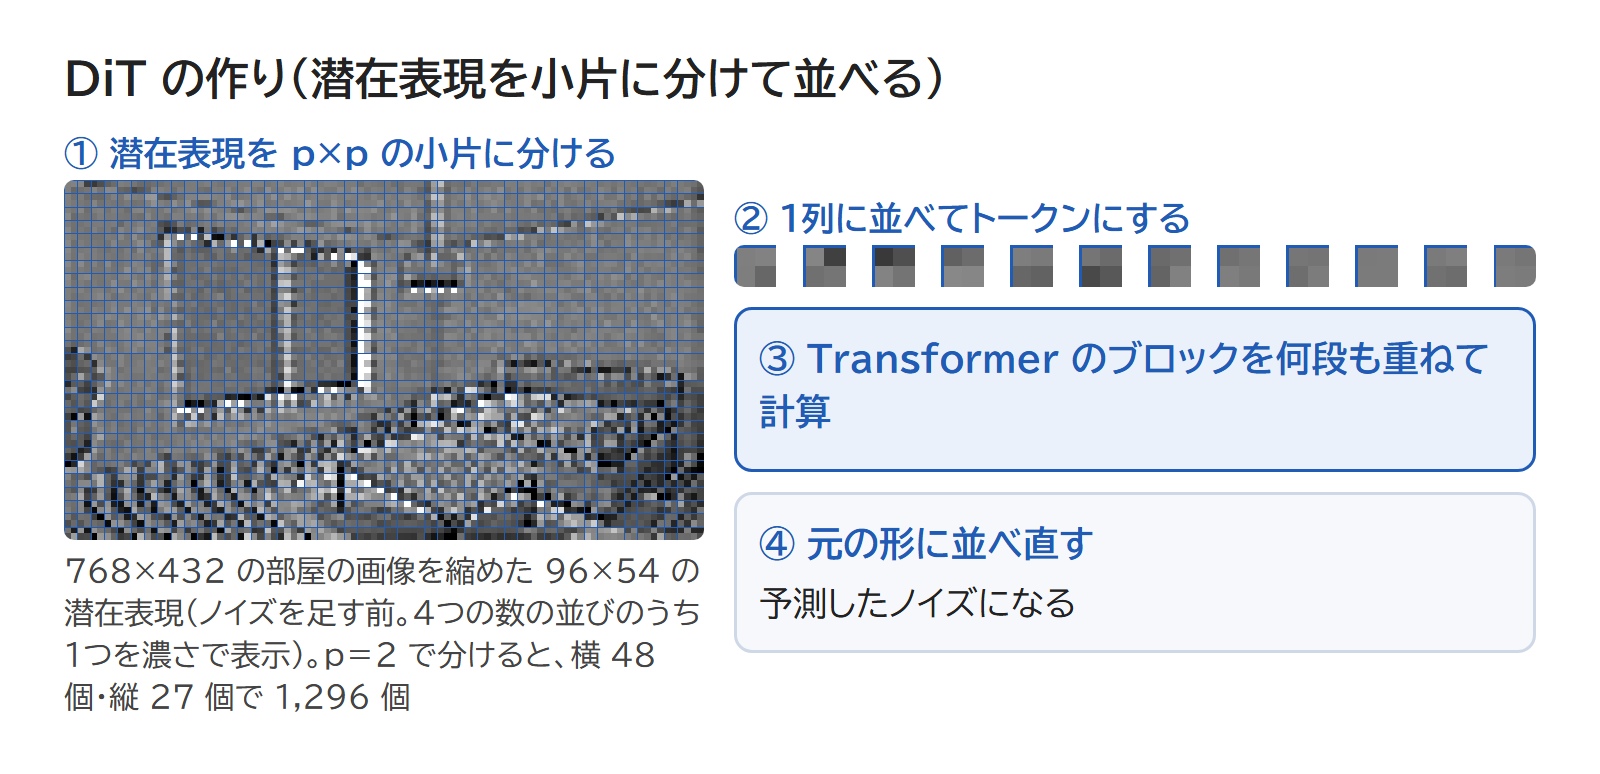
DiT は、ノイズのある潜在表現を p×p の小片(パッチ)に分けて、1列に並べます。小片の1つ1つが、1つのトークン(ひと続きのデータを区切った小さな単位)です。
並べたトークンは、Transformer のブロックを何段も重ねた部分で計算されます。最後に、計算したトークンを元の形に並べ直して、予測したノイズにします。
上の図は、部屋の画像(768×432)を縮めた 96×54 の潜在表現に、小片の線を引いたものです(ノイズを足す前)。p=2 の小片に分けると、横に 48 個・縦に 27 個並び、トークンは 1,296 個です。
DiT の論文が試した p は 2・4・8 で、p を半分にするとトークンは4倍に増えます。
その試しでは、Transformer を深く・広くしたり、トークンを増やしたりして計算を増やすほど、作った画像の質の指標がよくなりました。
試したのは、ImageNet という画像の集まりの、分類の名前から画像を作るモデルです。
U-NetとTransformerの骨組みを使うモデル
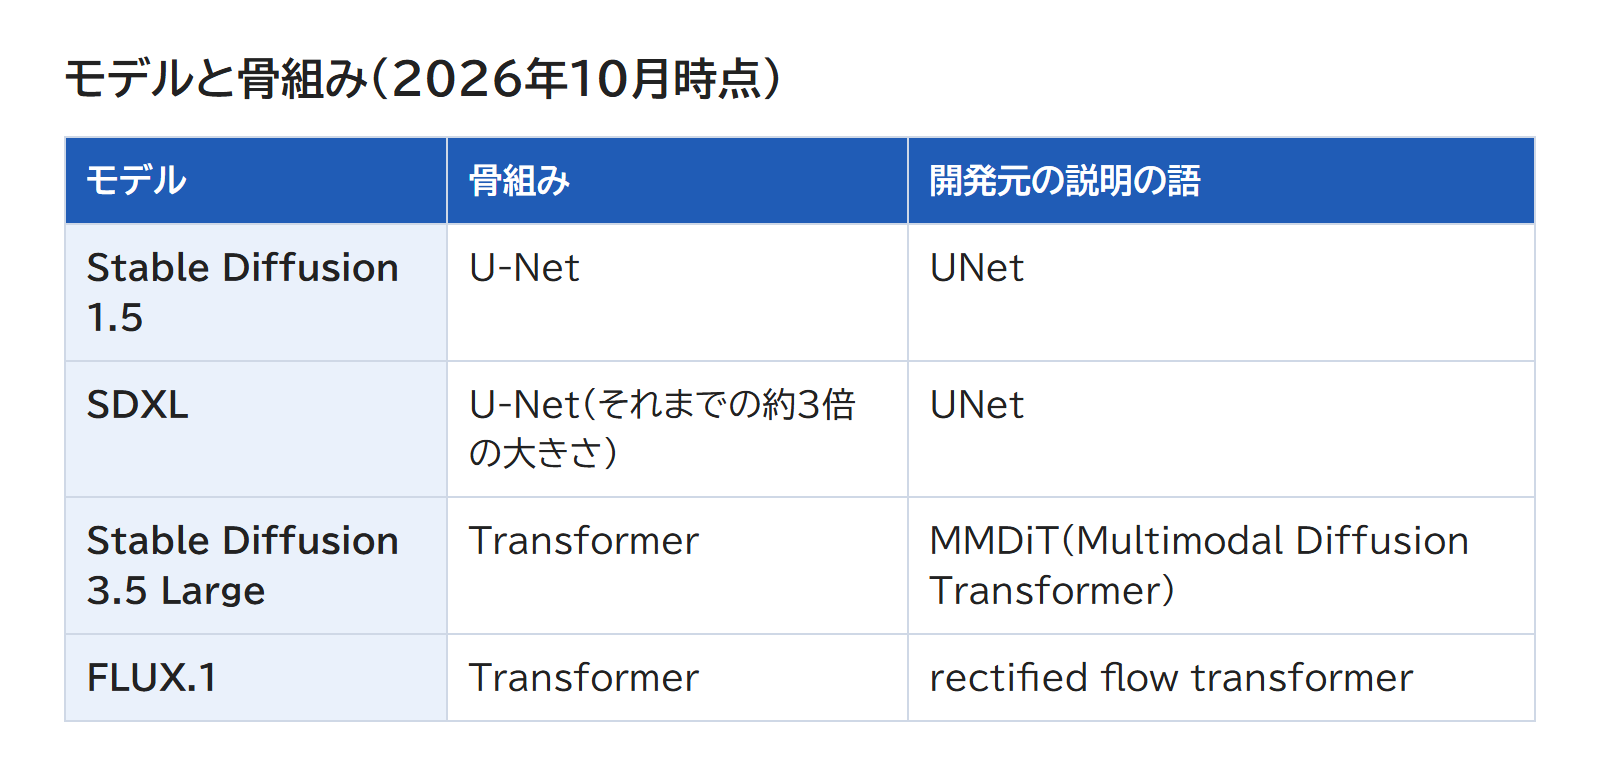
Stable Diffusion 1.5 と SDXL は、U-Net の骨組みです(2026年10月時点)。
Stable Diffusion 3.5 と FLUX.1 は、論文の DiT そのものではありませんが、DiT と同じく Transformer を骨組みにしたモデルです。
開発元の Stability AI は、Stable Diffusion 3.5 Large を MMDiT(Multimodal Diffusion Transformer)の画像生成モデルと説明しています。
FLUX.1 は、開発元の Black Forest Labs の説明では rectified flow transformer です。
rectified flow(整流)は、骨組みではなく、ノイズから画像を作る方法の名前です。
骨組みの種類は、モデルの説明で骨組み(backbone)を何と書いているかで分かります。Stable Diffusion 1.5 の説明には、UNet backbone と書かれています。
骨組みの名前でモデルの作りを見分けよう
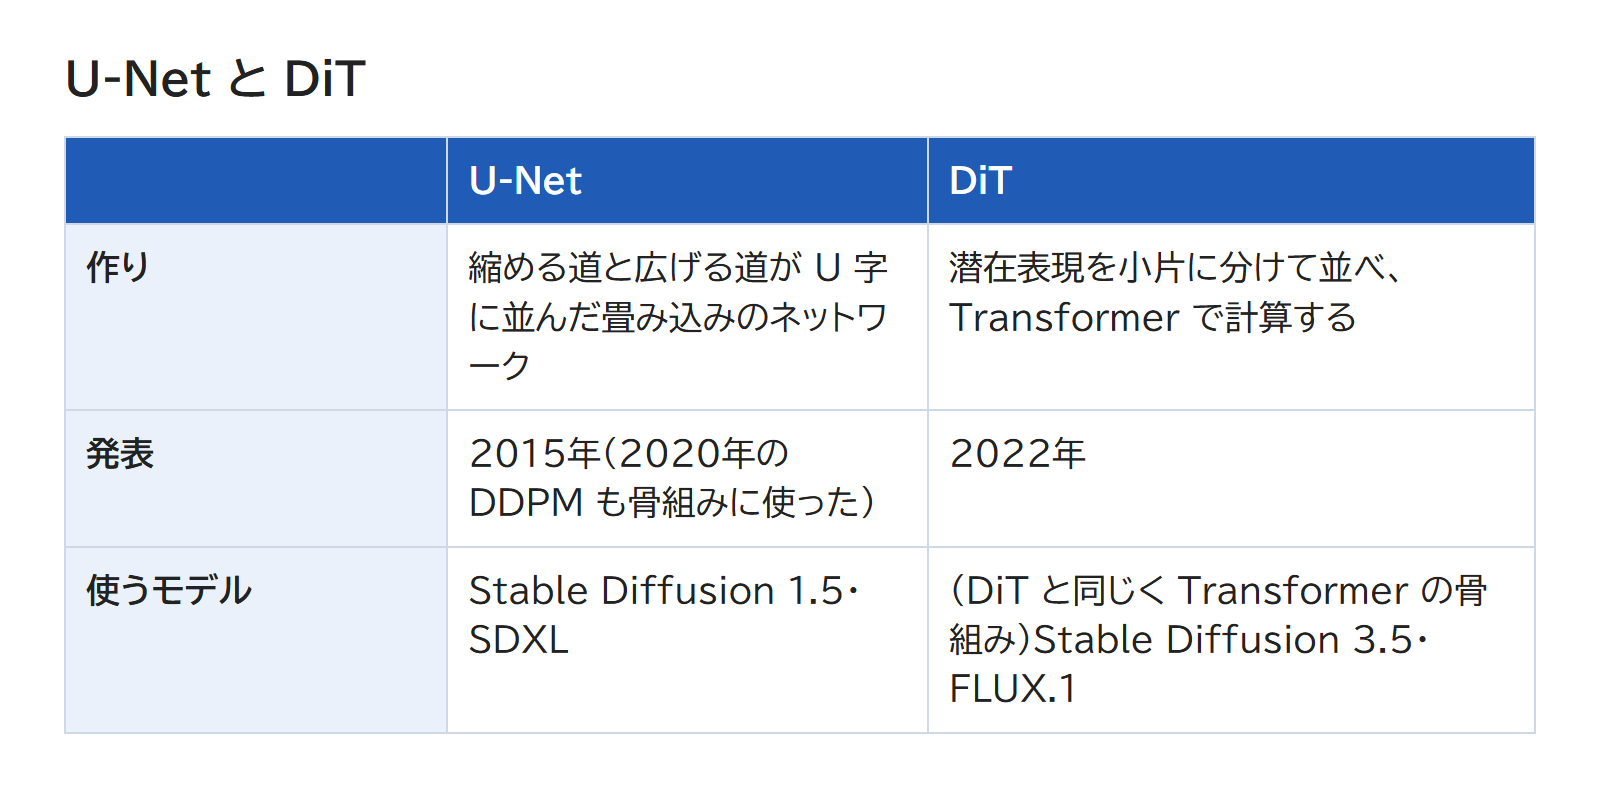
拡散モデルの骨組みは、拡散モデルの中で予測の計算を受け持つネットワークです。この記事で解説した2つの骨組みは、次のとおりです。
- U-Net:画像を縮める道と広げる道が U 字に並んだ畳み込みのネットワーク(Stable Diffusion 1.5・SDXL)
- DiT:潜在表現を小片に分けて並べ、Transformer で計算する骨組み(Stable Diffusion 3.5・FLUX.1 も Transformer の骨組み)
使うモデルの説明で、骨組みが UNet か Transformer かを確かめてみてください。
あわせて読みたい
- 「拡散モデル|ノイズを少しずつ取り除いて作る画像」(準備中) — 骨組みが受け持つ、ノイズを予測して取り除く流れを知りたいとき
- 「潜在空間とVAE|画像を小さく縮めた計算」(準備中) — 骨組みが受け取る、画像を縮めた潜在表現を知りたいとき
- 「フローマッチング|ノイズから画像へまっすぐ進む作り方」(準備中) — Stable Diffusion 3.5 や FLUX.1 の、ノイズから画像を作る方法を知りたいとき
- 「ComfyUIの画像モデルとは|系統ごとのワークフロー」(準備中) — 骨組みの違うモデルを ComfyUI で使い分ける方法を知りたいとき
会員登録(無料)
記事やテーマのお気に入り・学習履歴・フォローが使えます。
この記事について
PERSC編集部が、建築の制作に関わる知識を実務目線で整理しています。内容は公開・更新日時点の情報にもとづきます。誤りや古い情報にお気づきの場合はお問い合わせよりご連絡ください。