言語モデルと大規模言語モデル|次の語を予測して文章を作る仕組み
- 大規模言語モデル(LLM)って何?
- ChatGPT と大規模言語モデルの違いが分からない
- AIが文章を作る仕組みを知りたい
ChatGPT・Claude・Gemini などに質問すると、人が書いたような文章で答えが返ってきます。しかし、その文章をAIの中でどう作っているのかは、画面からは見えないままです。
この記事では、言語モデルと大規模言語モデルの意味と、次の語の予測をくり返して文章を作る仕組みを解説します。ChatGPT などのテキスト生成AIとの関係も分かります。
大規模言語モデルとは、膨大な文章で学習し、次に来る語を予測して文章を作る言語モデルのことです。
言語モデルとは
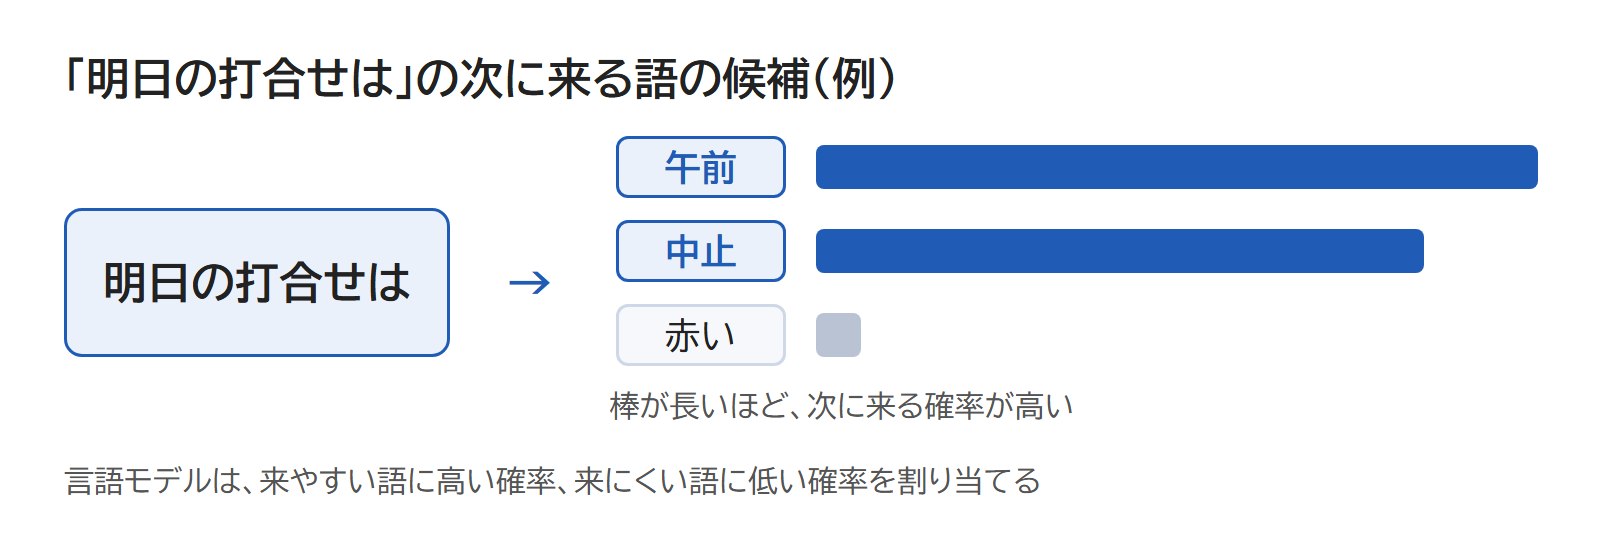
言語モデルとは、ある語の後に別の語が出てくる確率を表したものです。文章や話し言葉で、どの語の並びがどれくらい出やすいかを数で表します。
たとえば「明日の打合せは」の後には、「午前」や「中止」のような語が来やすく、「赤い」はまず来ません。言語モデルが割り当てるのは、来やすい語には高い確率、来にくい語には低い確率です。
どの語が来やすいかは、大量の文章で学ばせて決めます。
大規模言語モデル(LLM)とは
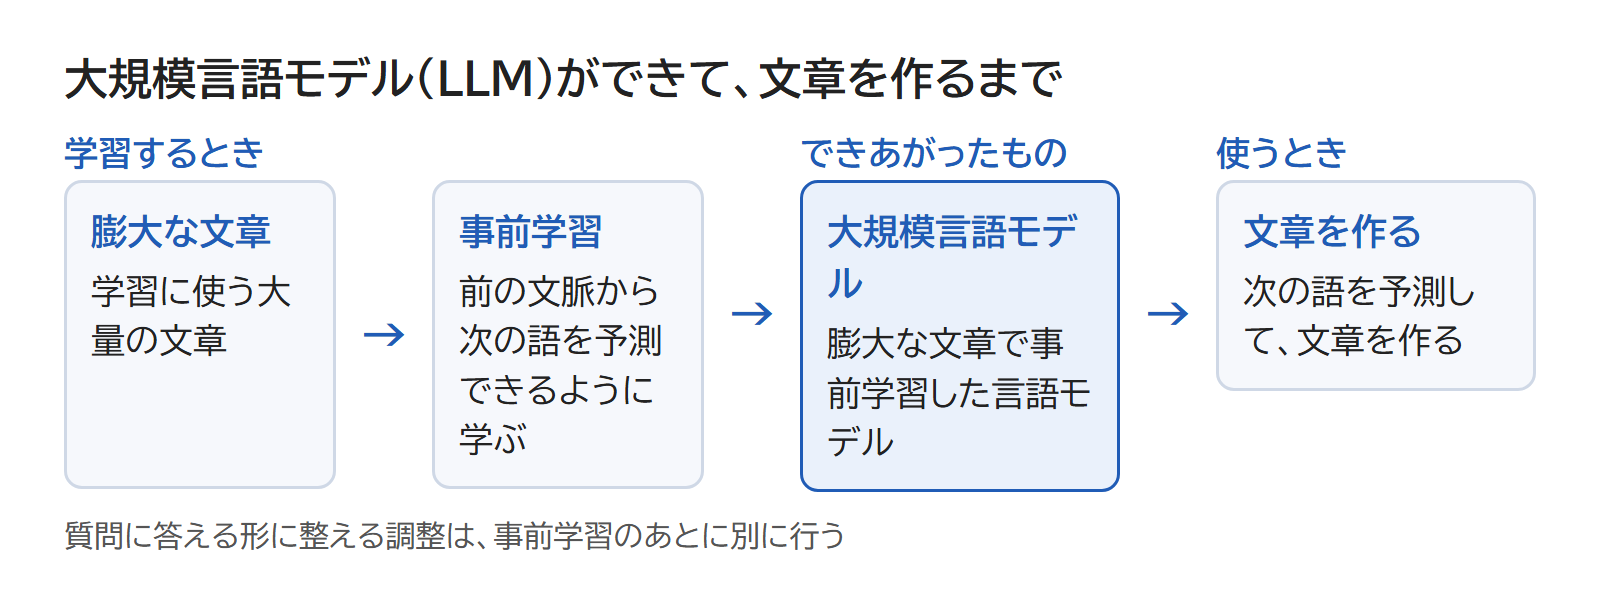
大規模言語モデル(LLM:large language model)とは、膨大な文章で事前学習した言語モデルです。
事前学習は、言語モデルが最初に受ける学習です。大量の文章を使い、前の文脈から次の語を予測できるように学ばせます。
学習で決まるのは、モデルの中で確率の計算に使う係数の値です。この係数をパラメータと言い、予測が実際の文章の次の語に当たるように、学習の中でくり返し直します。
次の語の予測をくり返して文章を作る仕組み
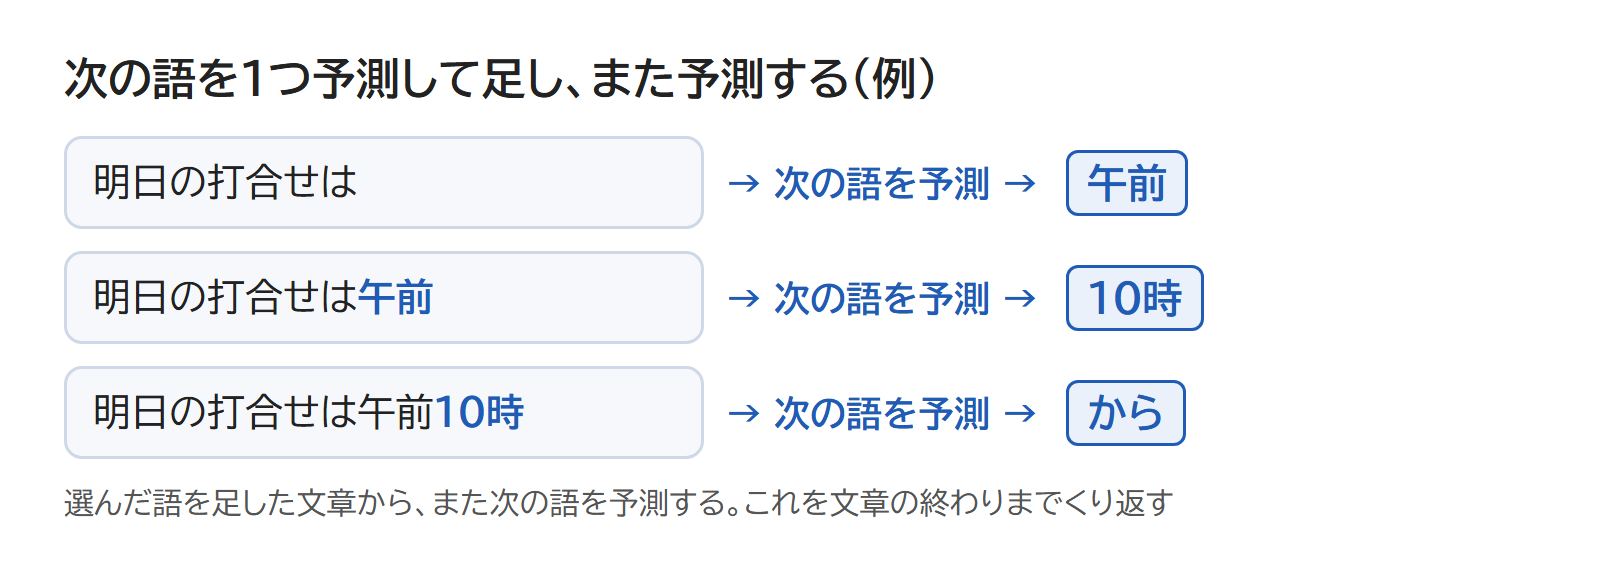
事前学習を終えた大規模言語モデルは、次の語を1つ予測して文章の後ろに足し、足した文章からまた次の語を予測します。これを答えの終わりまでくり返したものが、できあがる文章です。
たとえば「明日の打合せは」に続けるときは、まず次の語の候補ごとに確率を計算し、1語を選びます。「午前」を選んだら、次に予測するのは「明日の打合せは午前」の次の語です。
ChatGPT などに質問したときも、同じ流れで答えが作られます。質問の文章を前の文脈として、答えの語を1つずつ予測してつないでいきます。
質問の続きを書くのでなく、質問に答える形の文章になるのは、事前学習のあとに答え方を整える学習をしているためです。また、どの語を選ぶかには決め方があり、同じ質問でも答えが変わることがあります。
大規模言語モデルが実際に予測する単位は、語ではなくトークンです。トークンは文章を扱う最小の単位で、語のことも、語の一部や1文字のこともあります(この記事では分かりやすく「語」と書きます)。
大規模言語モデルの「大規模」が指す3つ
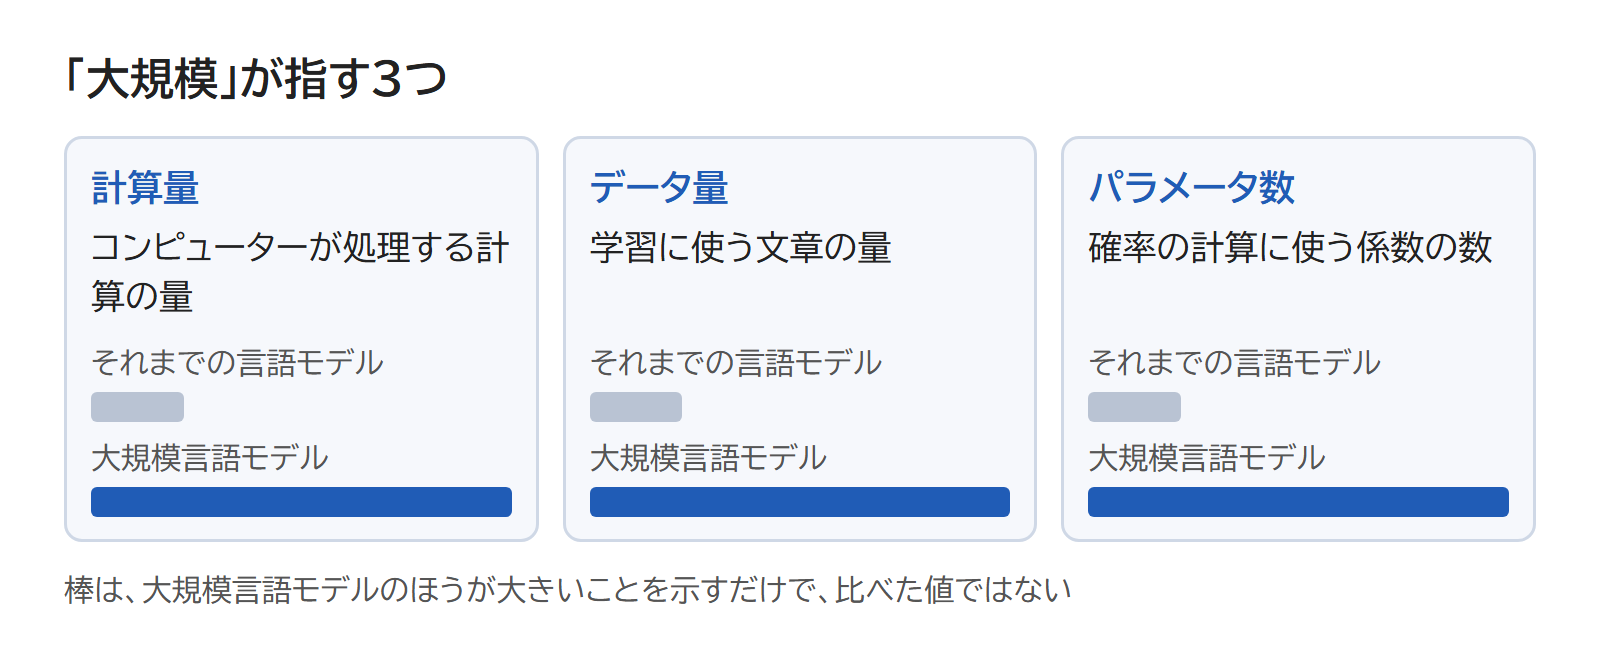
大規模言語モデルが自然な文章を作れるのは、それまでの言語モデルより大幅に大きくしたものが3つあるからです。3つを大きくしたことで、言語モデルの精度は大きく上がりました。
「大規模」が指すものは、次の3つです。
- 計算量
- データ量
- パラメータ数
計算量
計算量は、コンピューターが処理する計算の仕事量です。大規模言語モデルでは、この量がそれまでの言語モデルより大幅に増えています。
データ量
データ量は、モデルに入力して学ばせる文章の量です。事前学習には、膨大な量の文章を使います。
パラメータ数
パラメータ数は、確率の計算に使う係数がいくつあるかを表す数です。大規模言語モデルでは、この数が非常に多くなっています。
大規模言語モデルとテキスト生成AIの関係
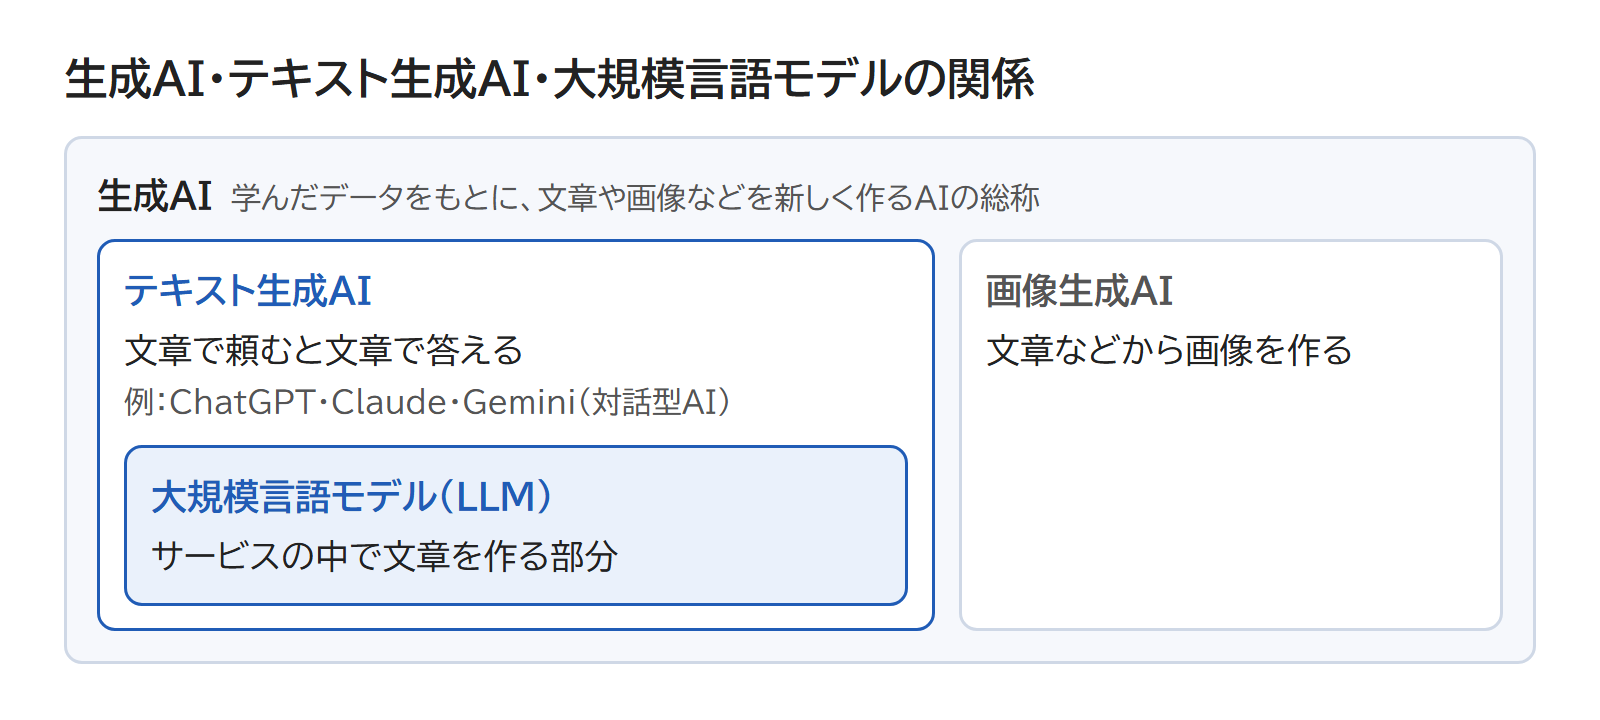
生成AIは、学んだデータをもとに文章や画像などを新しく作るAIの総称です。そのうち、文章を作るものがテキスト生成AIで、中で大規模言語モデルを使って文章を作ります。
ChatGPT・Claude・Gemini は、人と自然な対話ができる対話型AIで、テキスト生成AIのよく知られた例です。
大規模言語モデルを使った対話型AIは、2022年ごろから公開され、広く使われるようになりました。
次の語の予測から大規模言語モデルの仕組みをつかもう
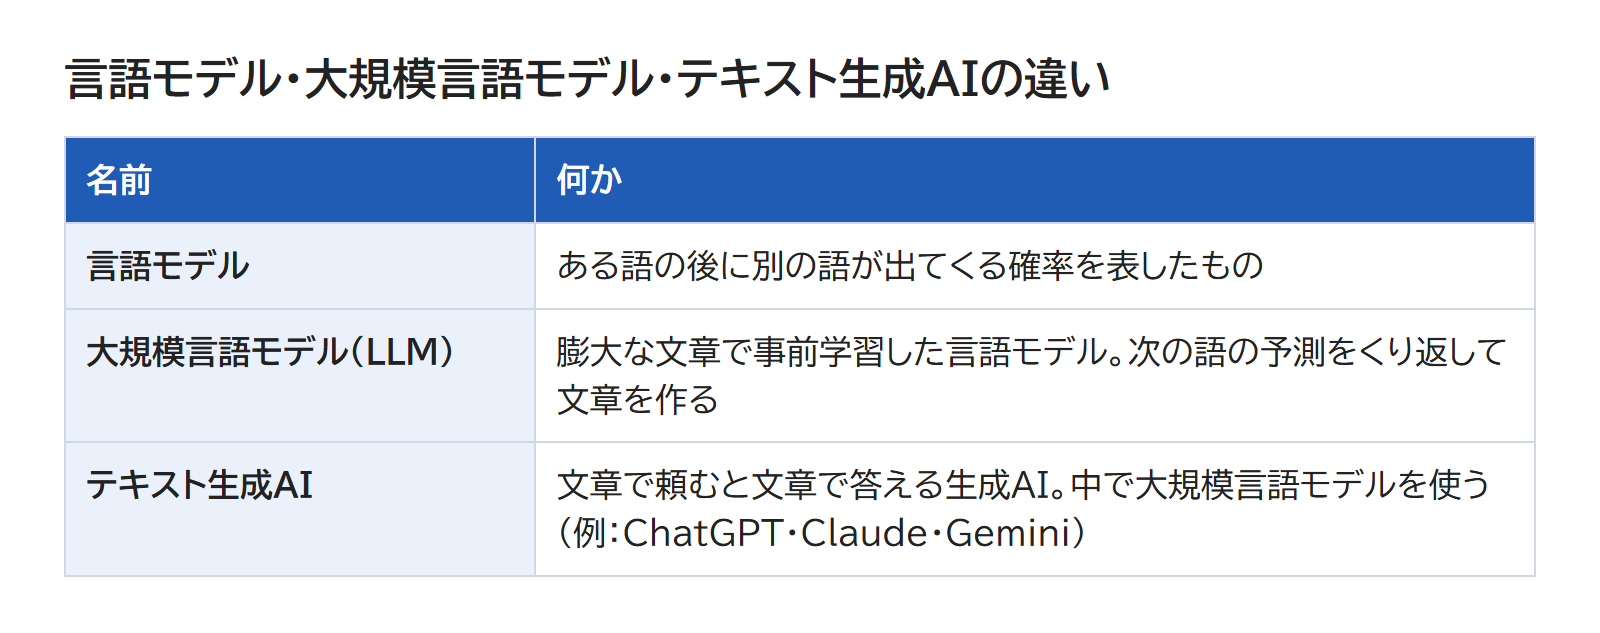
大規模言語モデルは、膨大な文章で事前学習した言語モデルで、次の語の予測をくり返して文章を作ります。「大規模」が指すのは、次の3つを大きくしたことです。
- 計算量:コンピューターが処理する計算の量
- データ量:学ばせる文章の量
- パラメータ数:確率の計算に使う係数の数
答えの文章は、確率をもとに選んだ語のつながりで、誤りが入ることもあります。仕事に使う答えは、元の資料で確かめてから使ってください。
あわせて読みたい
- 「建築CAD・3DCGのテキスト生成AIとは|文章で頼み、文章で答えるAI」(準備中) — テキスト生成AIの使い道と、気をつけることの全体を知りたいとき
- 「テキスト生成AIの答えが毎回変わる理由|確率で語を選ぶ仕組みと温度」(準備中) — 次の語の選び方で、同じ質問でも答えが変わる理由を知りたいとき
- Transformer|今の言語モデルの骨組みと注意機構 — 大規模言語モデルの中で、語どうしの関係を計算する仕組みを知りたいとき
- 事前学習と調整|人の評価で答え方を整える仕組み — 質問に答える形の答え方を、どう身につけるのかを知りたいとき
- 「トークン|文章を数える単位」(準備中) — 大規模言語モデルが実際に予測する単位を知りたいとき
会員登録(無料)
記事やテーマのお気に入り・学習履歴・フォローが使えます。
この記事について
PERSC編集部が、建築の制作に関わる知識を実務目線で整理しています。内容は公開・更新日時点の情報にもとづきます。誤りや古い情報にお気づきの場合はお問い合わせよりご連絡ください。
PERSC では、記事の次の段としてオンライン講座とプラグインを用意しています。