動画生成AI|時間の方向にそろった画像の生成
- 動画生成AIって、どういう仕組みなの?
- パースの静止画を、AIで動画にできると聞いた
- 画像生成AIと動画生成AIの違いを知りたい
文章や1枚の画像から短い動画を作れる動画生成AIは、建築の道具にも入っています。しかし、画像生成AIとの違いを知らないと、動画のどこを確かめればよいかが分かりません。
この記事では、動画生成AIが画像生成AIを時間の方向に広げて動画を作る仕組みを解説します。文章から作る方法と画像から作る方法の違い、長い動画や物の動きで起きる崩れ、建築での使われ方も分かります。
動画生成AIは、コマ(動画を作る1枚1枚の画像)どうしがつながるように動画を作るAIです。
動画生成AIとは
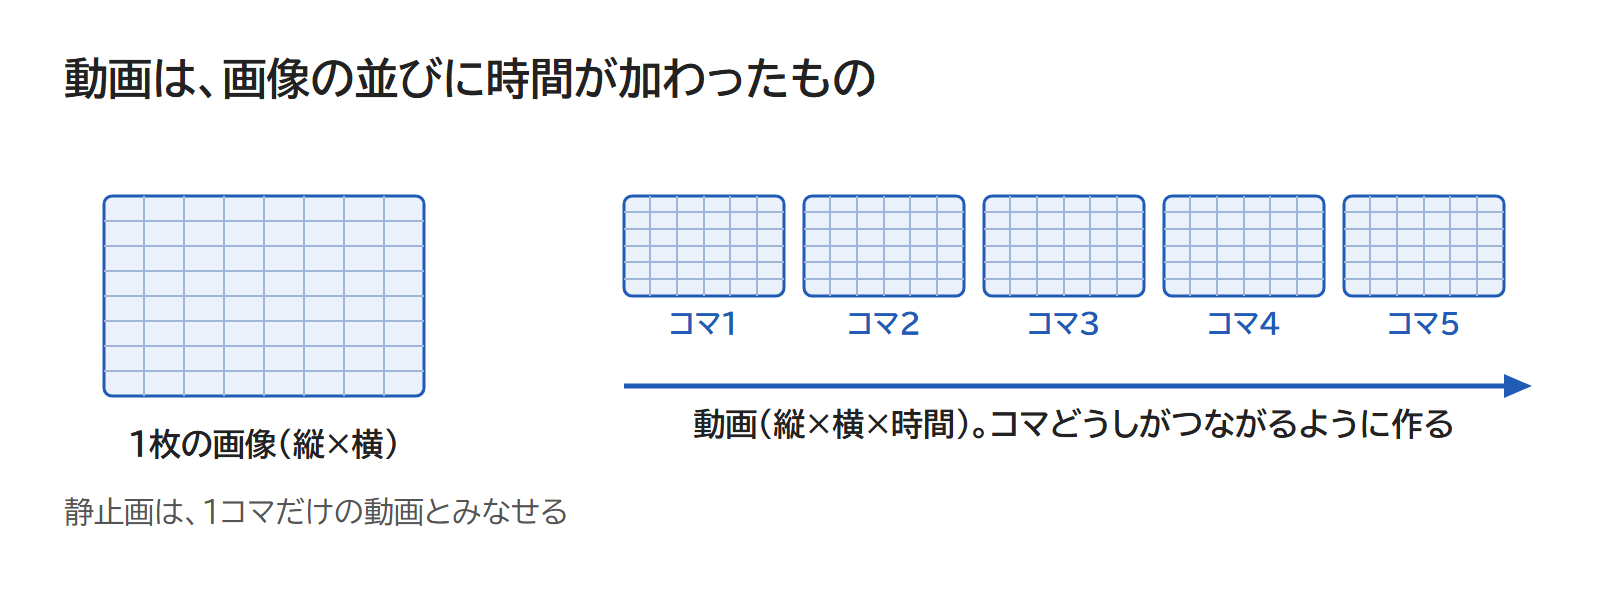
動画生成AIとは、画像の拡散モデルを時間の方向に広げ、コマどうしがつながった動画を作るAIです。
拡散モデルは、画像を作る仕組みの1つです。ノイズ(画像のざらつきのような、でたらめな値)だけの状態から、文章などを手がかりに、ノイズを少しずつ取り除いて画像を作ります。
1枚の画像では画素が縦と横に並び、動画ではそこに時間が加わって、縦×横×時間の並びになります。
この見方で言えば、静止画は1コマだけの動画です。OpenAI の動画生成AI、Sora の技術報告にも、画像は1コマだけの動画として扱えると書かれています。
動画生成AIがねらうのは、時間の方向にそろった動画です。コマをまたいでも、同じ物が同じ物として見えることを、時間的整合性と呼びます。
画像の拡散モデルを時間の方向に広げる仕組み
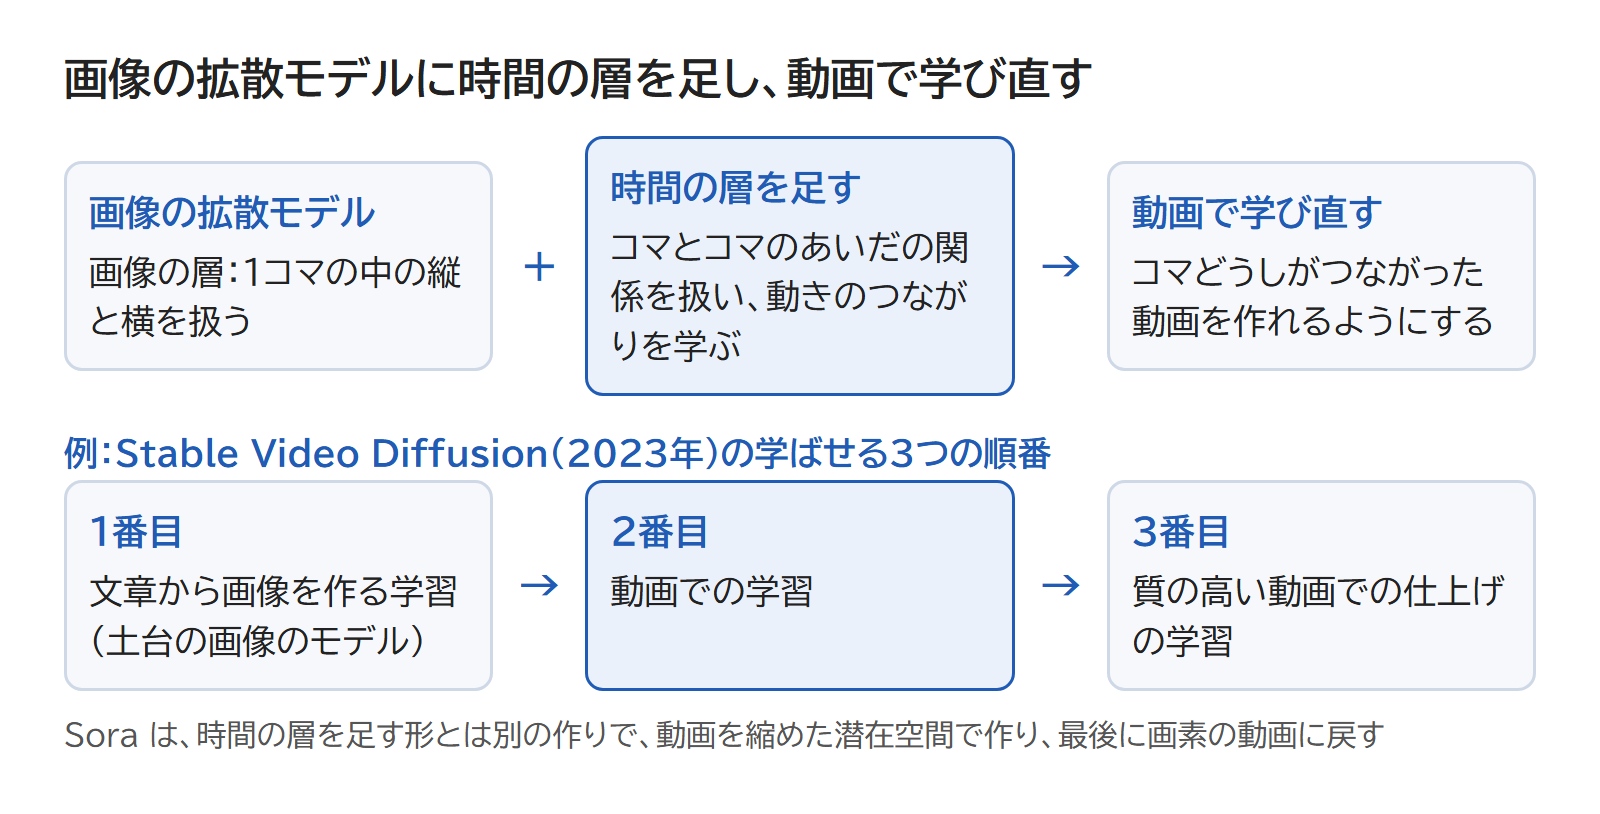
動画生成AIの作り方の1つは、画像を作る拡散モデルに時間の層を足し、動画で学び直す方法です。
モデルは、大量の画像や動画から作り方を学んだ計算の仕組みで、層はその中の計算の段にあたります。
もとの画像の層が扱うのは、1コマの中の縦と横です。足した時間の層は、コマとコマのあいだの関係を扱い、動きのつながりを学びます。
画像の拡散モデルを動画へ広げる考え方は、2022年に Google の研究者が示しました。動画の拡散モデルを、画像の拡散モデルの作りをそのまま広げたものとしています。
2023年に Stability AI が出した Stable Video Diffusion も、画像の拡散モデルに時間の層を入れる作り方を土台にしています。
学ばせる順番は3つで、文章から画像を作る学習、動画での学習、質の高い動画での仕上げの順です。
Sora も拡散モデルですが、時間の層を足す形とは別の作りで、画像を1コマの動画として、画像と動画をまとめて扱います。
動画を、時間と縦横の両方で縮めた潜在空間(小さく縮めた数の並び)に置いて作り、最後に画素の動画に戻します。
文章から作る動画と画像から作る動画
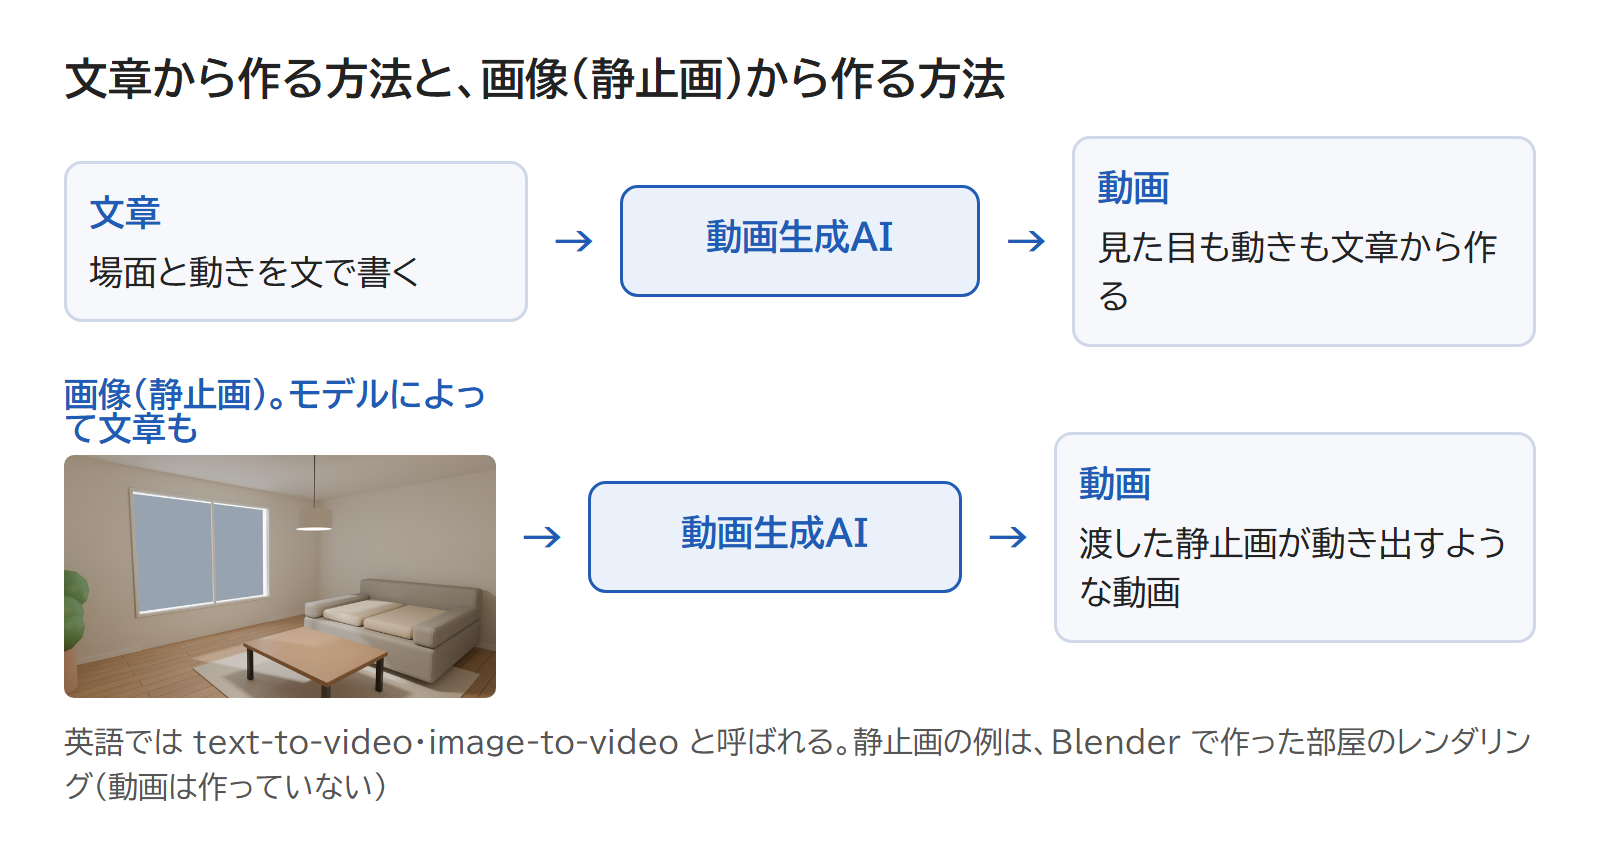
動画生成AIには、文章から作る方法と、画像(静止画)から作る方法があります。2つの方法を、入力と報告にある例で比べると、次の表のとおりです。
| 文章から作る | 画像から作る | |
|---|---|---|
| 入力 | 文章 | 静止画(モデルによって文章も一緒に) |
| 英語の呼び名 | text-to-video | image-to-video |
| 報告にある例 | Sora・Stable Video Diffusion | Sora(画像と文章)・Stable Video Diffusion(画像) |
画像から作る方法で作るのは、渡した静止画が動き出すような動画です。Sora の報告でも、画像生成AIで作った静止画と文章から、その画像を動かした例が示されています。
パースの静止画を動かしたいときは、パースを渡す、画像から作る方法を選びます。
動画生成AIで起きる崩れ
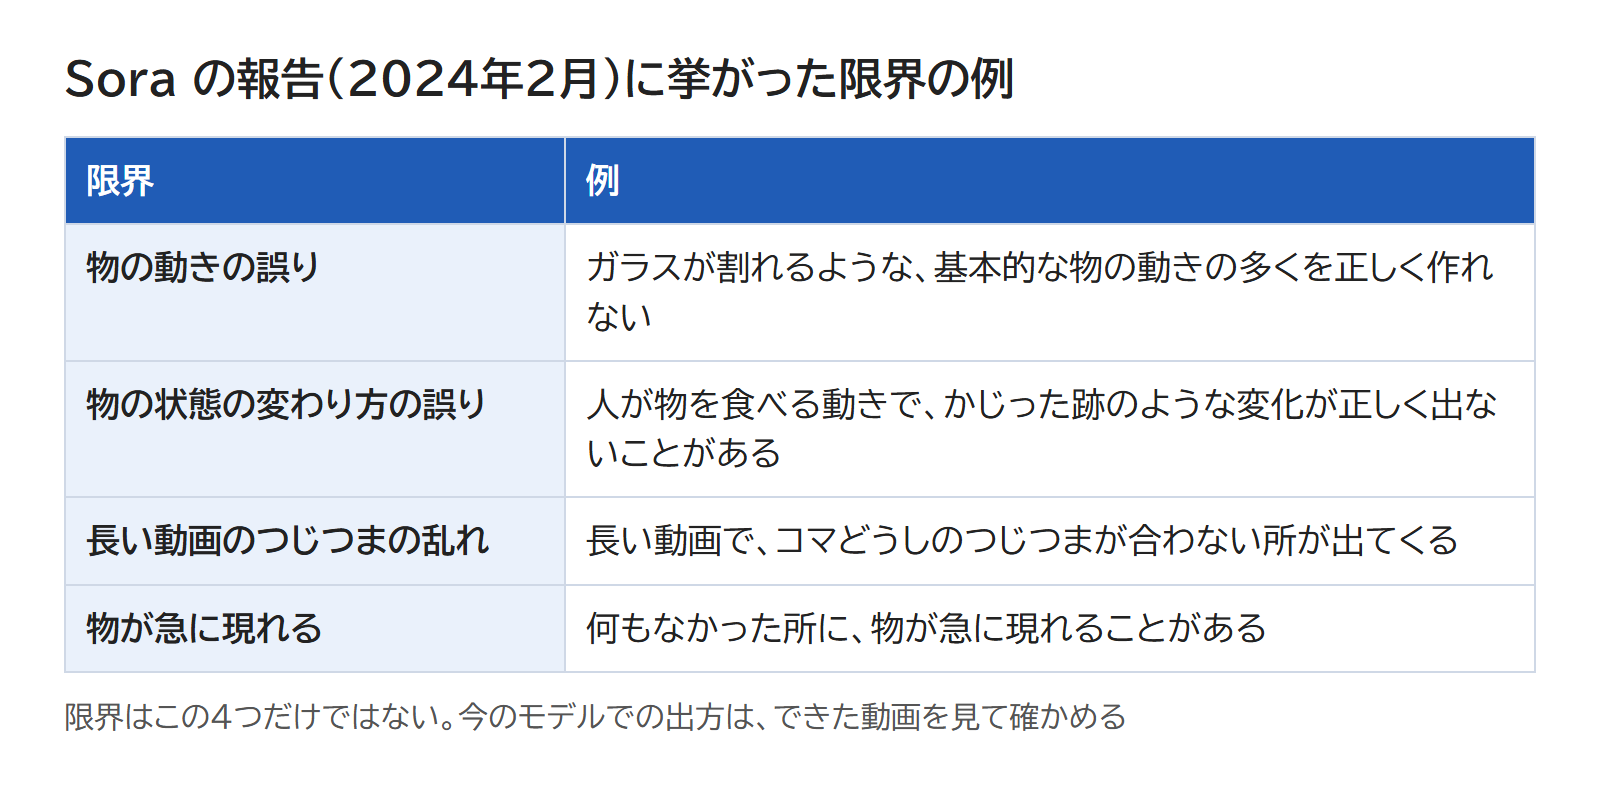
動画生成AIの作る動画では、長い動画でコマどうしのつじつまが合わなくなることがあります。Sora の報告が動画生成の大きな課題に挙げるのも、長い動画での時間的整合性です。
ただし、長い動画がいつも崩れるわけではありません。同じ報告によると、つながりは、いつもではないが多くの場合に保てます。
同じ報告に挙がった限界の例は、次のようなものです。
- ガラスが割れるような、基本的な物の動きの多くを正しく作れない
- 人が物を食べる動きで、かじった跡のような物の変化が正しく出ないことがある
- 長い動画で、つじつまの合わない所が出てくる
- 何もなかった所に、物が急に現れることがある
パースの静止画を動かしたときも、建物や家具の形が途中で変わっていないか、物が増えていないかを、動画を少しずつ止めて見ておくと安心です。
建築での動画生成AIの使われ方
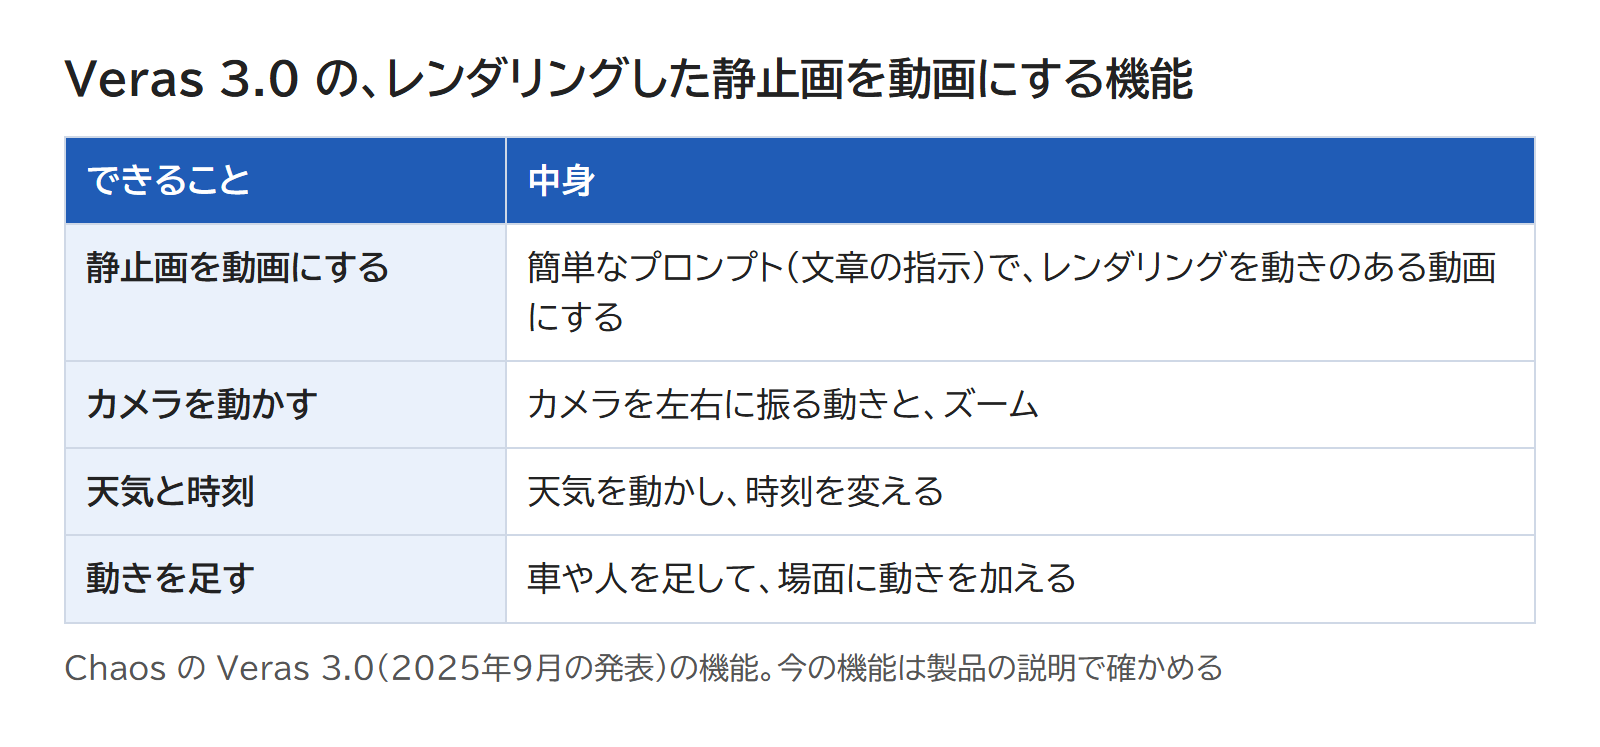
建築の道具にも、レンダリングした静止画から動画を作る機能を持つものがあります。レンダリングとは、3DCG のデータから計算して画像を作ることを指します。
その1つが、Chaos(レンダラーの V-Ray などを作る会社)の Veras です。Veras は、Revit・Rhino・SketchUp などの設計ソフトと組み合わせて使う、AI で画像を作る道具です。
Veras は 2025年9月の Veras 3.0 で、静止画を動画にする機能を加えました。発表では、簡単なプロンプト(文章の指示)で、レンダリングを動きのある動画にできるとしています。
発表で挙がった機能は、カメラを左右に振る動きとズーム、天気の動き、時刻の変更です。車や人を足して、場面に動きを加えることもできます。
製品の機能は変わるので、使うときは、その時点の製品の説明で確かめてください。
動画生成AIの仕組みを知って、パースの動画を確かめよう
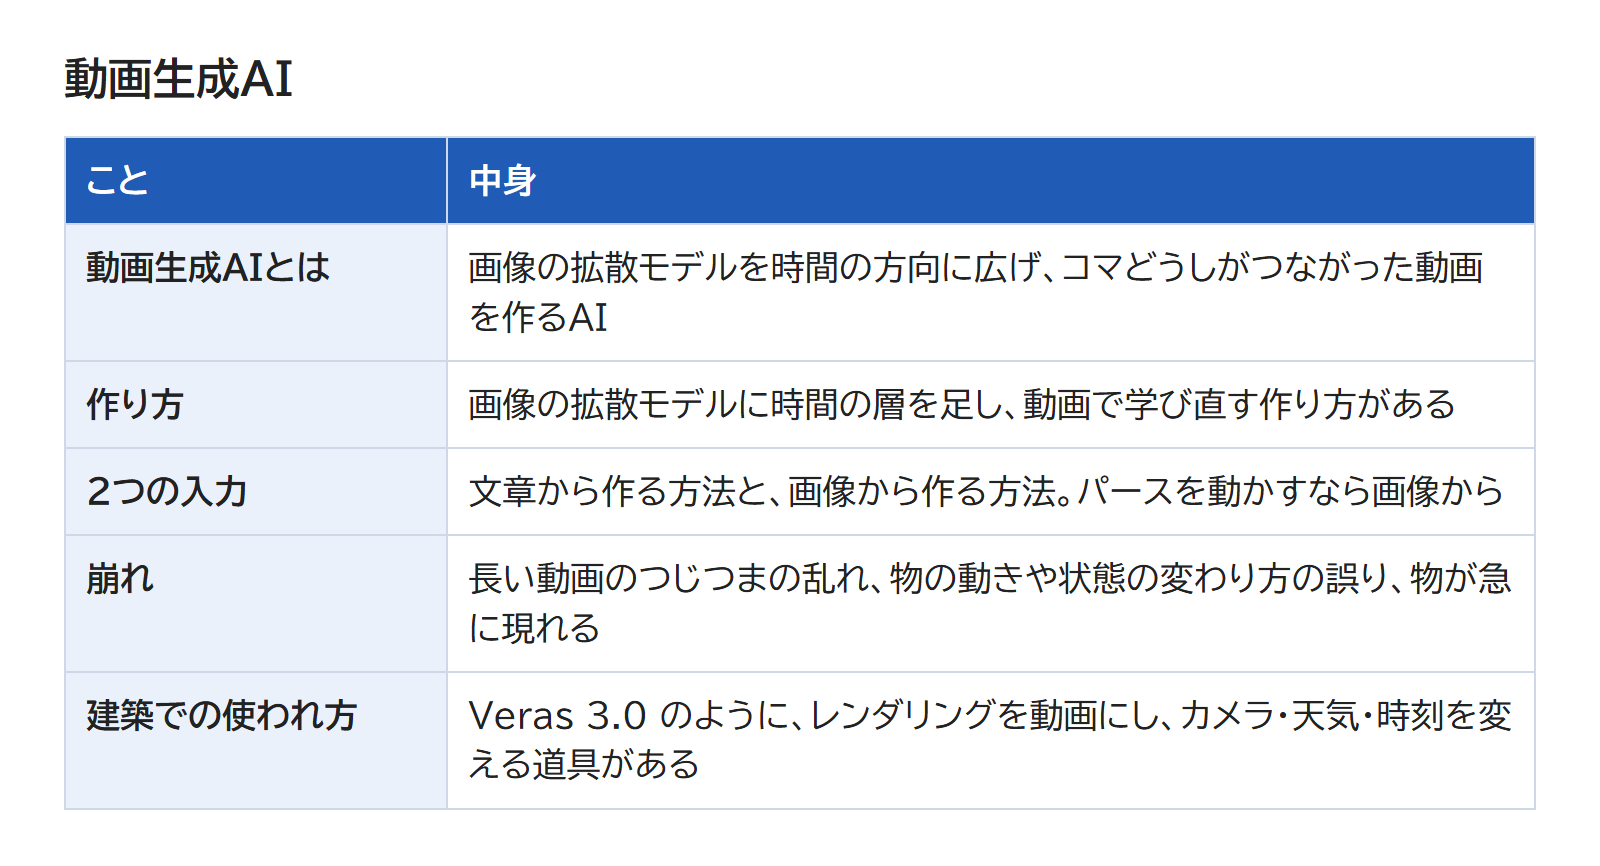
動画生成AIは、画像の拡散モデルを時間の方向に広げて、コマのつながった動画を作るAIです。この記事で解説したことは、次の5つです。
- 動画は縦×横×時間の並びで、静止画は1コマだけの動画とみなせる
- 画像の拡散モデルに時間の層を足し、動画で学び直す作り方がある
- 文章から作る方法と画像から作る方法があり、パースを動かすなら画像から作る
- 長い動画ではつじつまが合わなくなることがあり、物の動きの誤りや、物が急に現れることもある
- 建築では、Veras 3.0 のように、レンダリングした静止画を動画にし、カメラや時刻を変える道具がある
パースの静止画を動画にしたら、少しずつ止めて、形や物の数が途中で変わっていないかを確かめてみてください。
あわせて読みたい
- 拡散モデル|ノイズを少しずつ取り除いて作る画像 — 動画生成AIの土台になる、画像を作る仕組みを知りたいとき
- 建築3DCGパースの動画とは|ウォークスルー・フライスルー — 3DCG のソフトでカメラを動かして作るパースの動画を知りたいとき
- ComfyUIの動画生成とは|テキスト・画像から動画 — ComfyUI で文章や画像から動画を作る操作を知りたいとき
- 「3D生成AI|画像や文章から3Dモデルを作る仕組み」(準備中) — 画像や文章から3Dモデルを作るAIの仕組みを知りたいとき
会員登録(無料)
記事やテーマのお気に入り・学習履歴・フォローが使えます。
この記事について
PERSC編集部が、建築の制作に関わる知識を実務目線で整理しています。内容は公開・更新日時点の情報にもとづきます。誤りや古い情報にお気づきの場合はお問い合わせよりご連絡ください。