拡散モデル|ノイズを少しずつ取り除いて作る画像
- 拡散モデルって何?
- 画像生成AIの説明に出てくるが、仕組みが分からない
- ノイズから画像ができる流れを知りたい
Stable Diffusion や FLUX.1 など、仕組みを公表している画像生成AIは、拡散モデルかその発展の方法で作られています。ただ、どう画像を作るのかは名前から想像しにくいものです。
この記事では、拡散モデルが学習で身につけることと、ノイズを少しずつ取り除いて画像を作る流れを解説します。一緒に働くテキストエンコーダ・サンプラー・VAE の役目も分かります。
拡散モデルは、ノイズ(でたらめな点のざらつき)だけの状態から、少しずつノイズを取り除いて画像を作る生成AIの作り方です。
拡散モデルとは
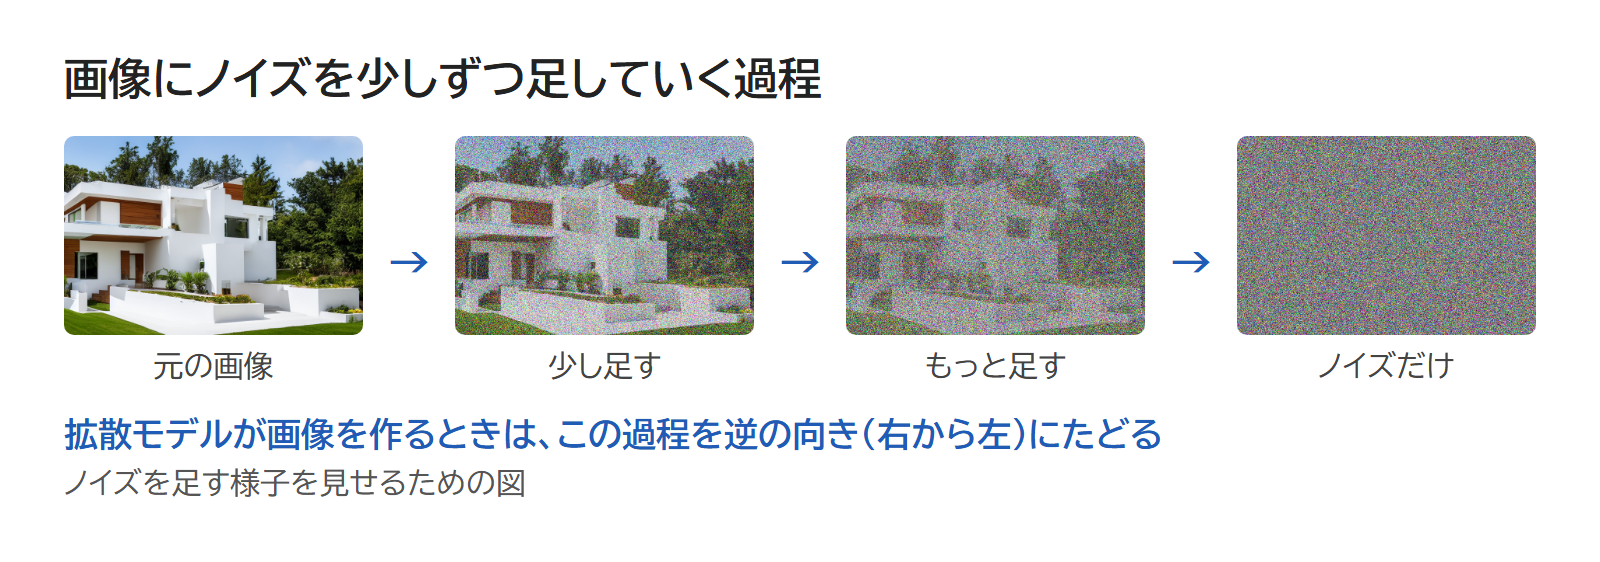
拡散モデルとは、データに少しずつノイズを加えてノイズだけにする過程を逆にたどることを学び、ノイズだけの状態から画像などを作る生成モデルです。
生成モデルは、学んだデータをもとに新しいデータを作るAIのモデルのことです。
上の図のように、画像にノイズを足していくと、足すほど元の画像は見えなくなり、最後はノイズだけになります。拡散モデルが画像を作るときにたどるのは、この過程の逆の向き(図の右から左)です。
拡散モデルが学習で身につけること
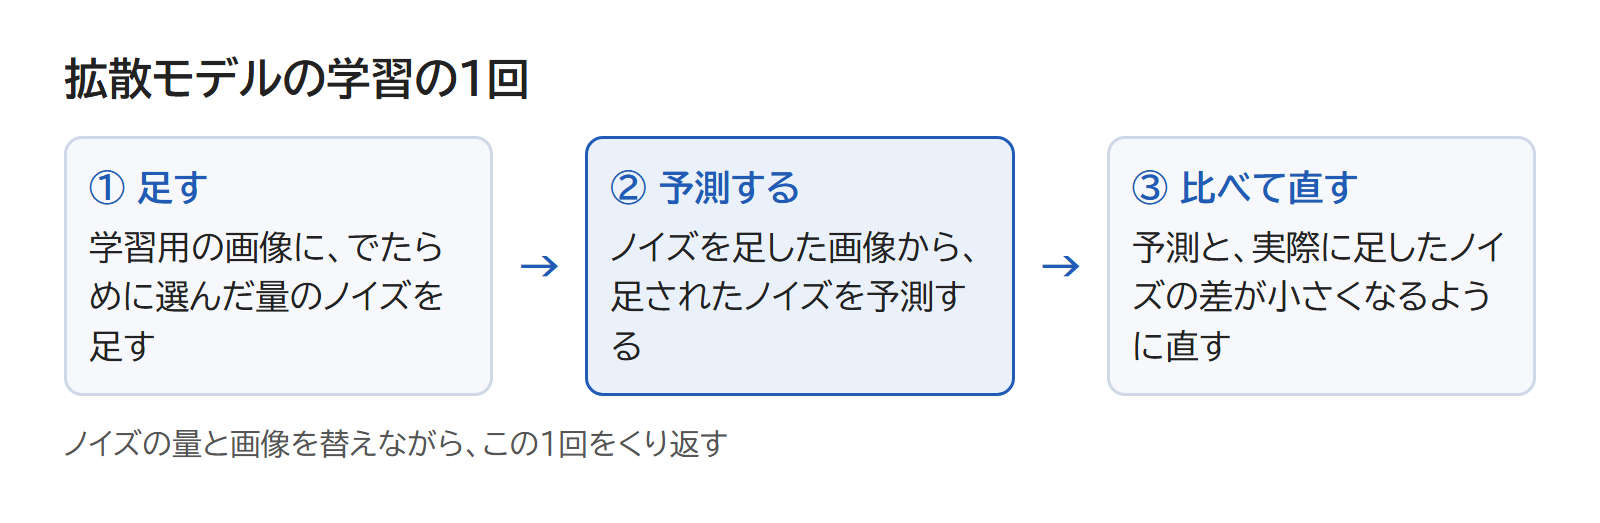
拡散モデルは学習で、ノイズを足した画像から、足されたノイズを予測することを身につけます。
まず学習用の画像を1枚選び、足すノイズの量をでたらめに選んで足します。そのうえでノイズを予測させ、実際に足したノイズとの差が小さくなるように直すのが、学習の1回です。
これを、ノイズの量と画像を替えながらくり返します。そのため、ノイズが多い画像からも少ない画像からも、ノイズを予測できるようになるのです。
Stable Diffusion の学習に使われるのは、大量の画像と説明文の組です。説明文を数値にしたものも手がかりにしてノイズを予測するので、文に合う画像のノイズの当て方も身につきます。
予測したノイズを取り除けば、ノイズの少ない画像に近づきます。画像を作るときに使うのは、この予測です。
ノイズを少しずつ取り除いて画像を作る流れ
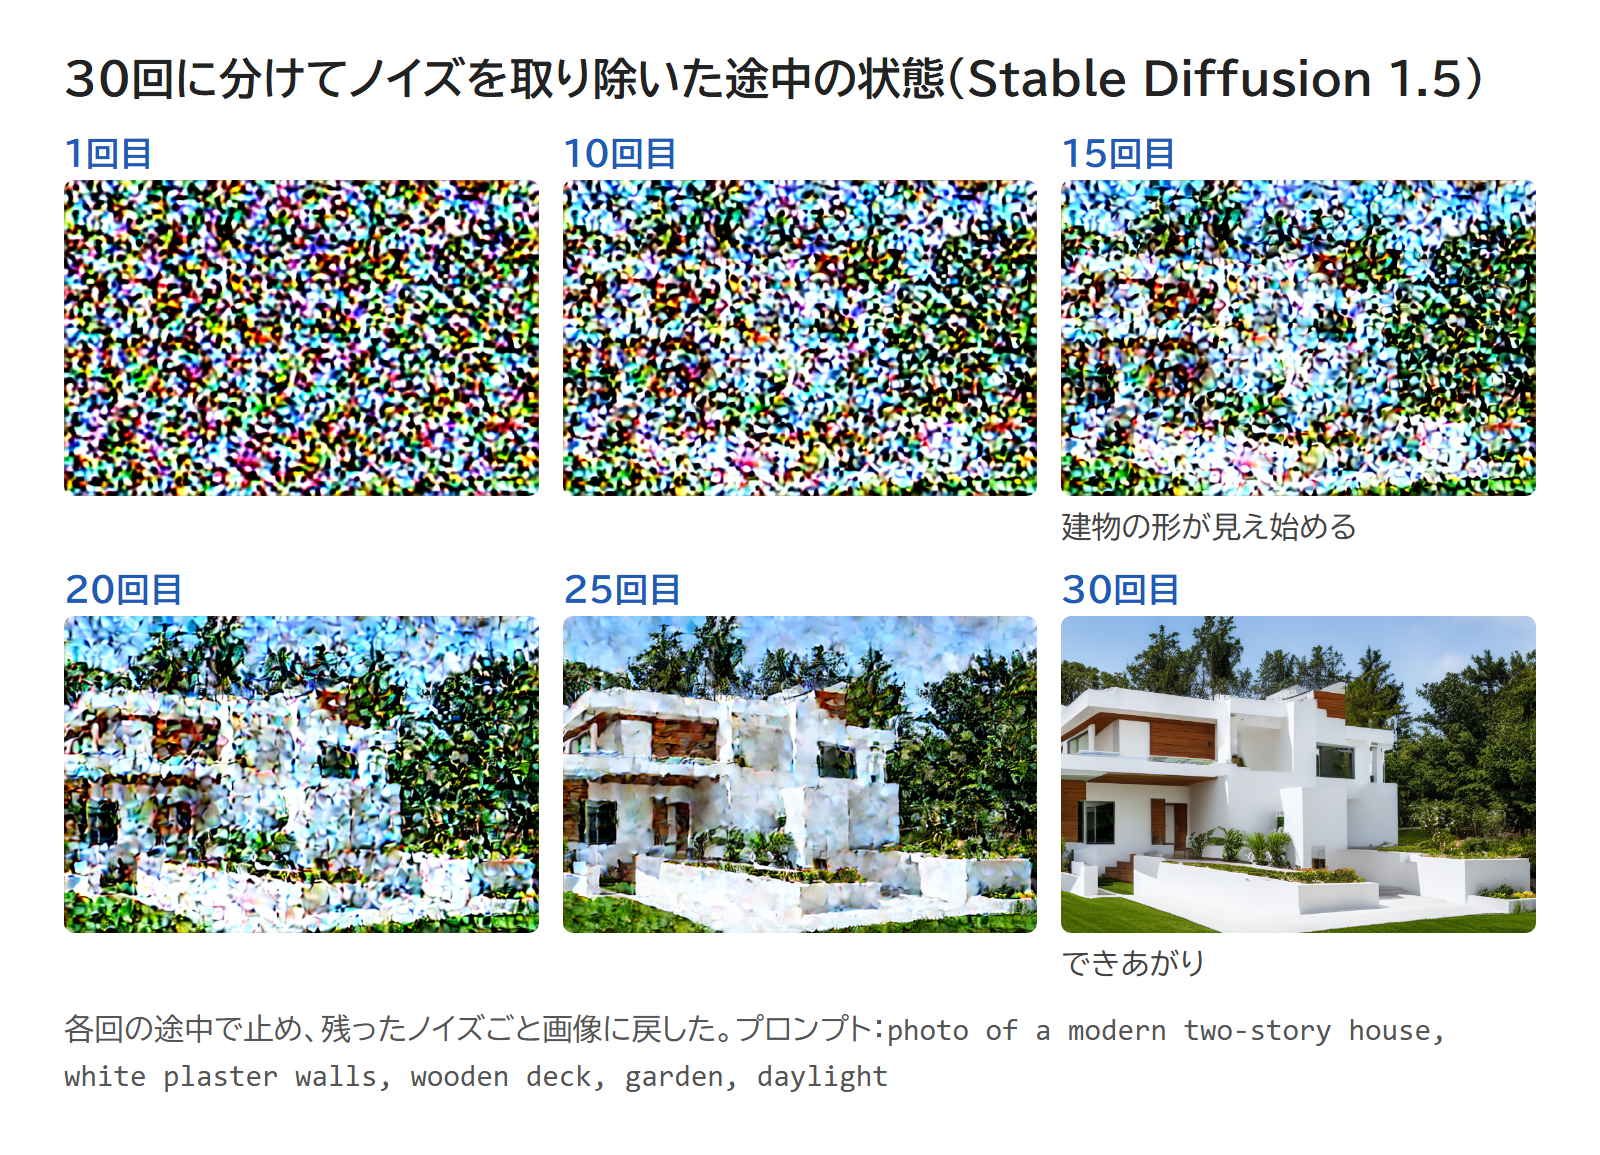
画像を作るときは、ノイズだけの状態から始めて、予測したノイズを一度でなく何回かに分けて取り除きます。1回ごとに、今の状態のノイズを予測して一部を取り除き、その結果からまた次の予測をする流れです。
上の画像は、Stable Diffusion 1.5 で30回に分けて取り除く途中で止め、残ったノイズごと画像に戻したもので、ソフトの画面に出る途中の絵とは別物です。
Stable Diffusion は、画像を小さく縮めた形(潜在表現)の中でノイズを取り除くので、途中を画像に戻すとノイズが色のまだらに見えます。最初の図の点のざらつきとは、見え方が違いました。
この試しでは、10回目まではまだらだけで、15回目に白い建物の形がぼんやり見え始めました。20回目と25回目で家と庭が分かるようになり、30回目でできあがりの画像になっています。
取り除く回数の目安は、1.5 を含む Stable Diffusion の最初の版で50回ほどです。回数は、ComfyUI などの画像生成AIを動かすソフトの「ステップ数」という設定で決めます。
拡散モデルと一緒に働く部品
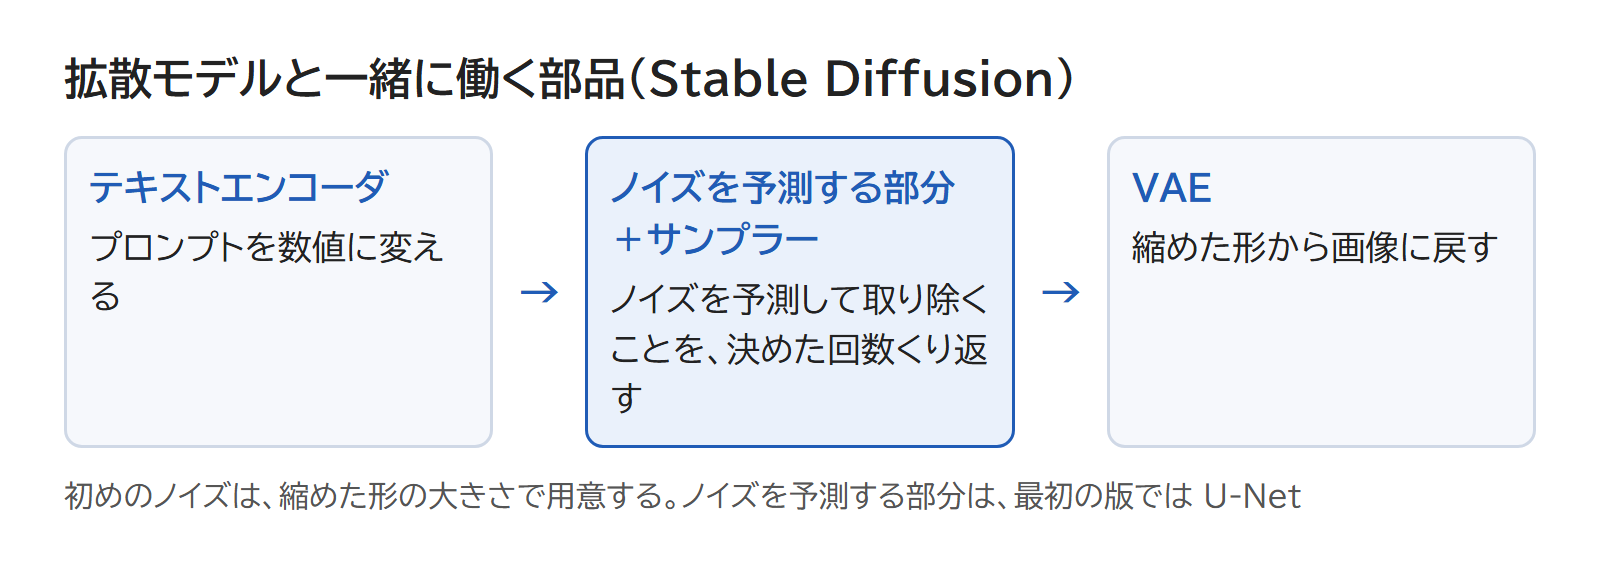
ノイズを予測する部分が拡散モデルの中心で、Stable Diffusion の最初の版では U-Net というネットワークが受け持ちます。画像を作るときは、ほかに次の3つの部品が一緒に働きます。
- テキストエンコーダ
- サンプラー
- VAE
テキストエンコーダ
テキストエンコーダは、プロンプト(作ってほしい画像を伝える文)を数値に変える部品です。ノイズを予測する部分は、取り除くたびにこの数値を手がかりにします。
そのため、ノイズから始めても、プロンプトに沿った画像ができあがります。
サンプラー
サンプラーは、予測したノイズを、各回でどう取り除くかを計算する方式です。予測とサンプラーの計算を、ステップ数で決めた回数だけくり返します。
VAE
VAE(変分オートエンコーダ)は、画像を小さな数の並び(潜在表現)に縮め、潜在表現から画像に戻す部品です。
Stable Diffusion では、初めのノイズもこの縮めた大きさで用意し、その中でノイズを取り除きます。そのため最後に、VAE で目に見える画像へ戻します。
ノイズを取り除く流れから画像生成AIの仕組みをつかもう
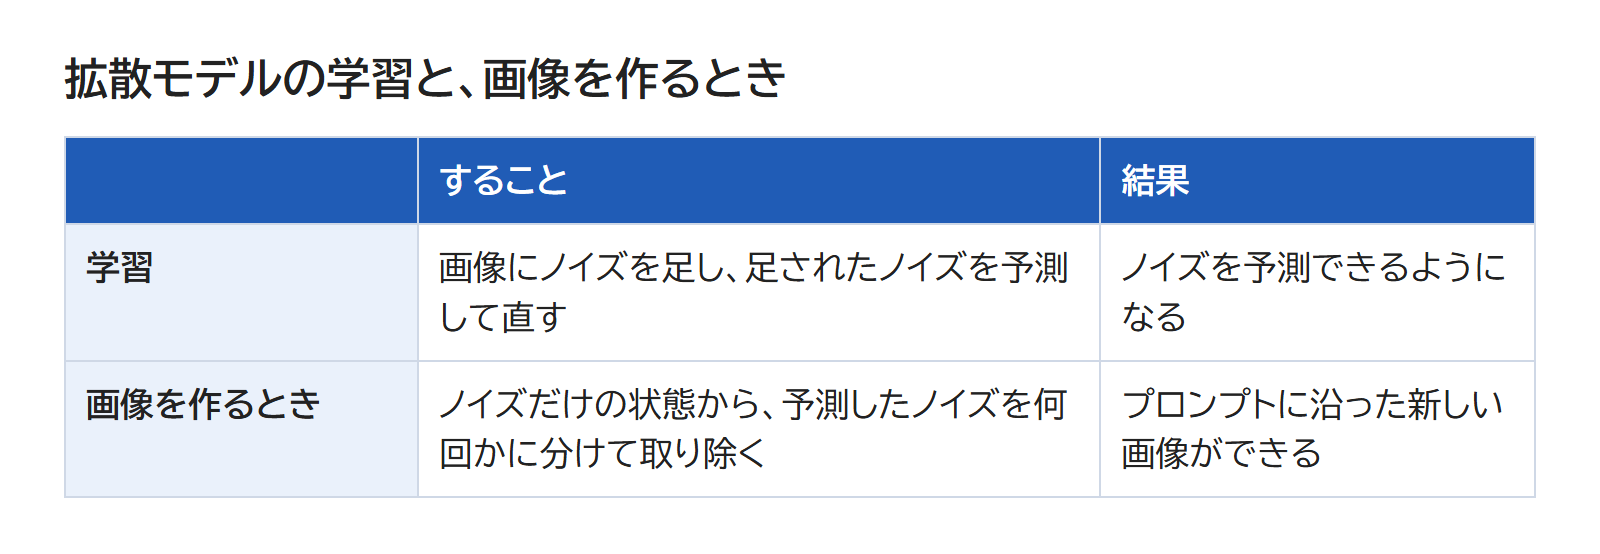
拡散モデルは、ノイズを足す過程を逆にたどることを学び、ノイズだけの状態から少しずつノイズを取り除いて画像を作る生成モデルです。画像を作るときに一緒に働く部品は、次の3つです。
- テキストエンコーダ:プロンプトを数値に変える
- サンプラー:各回のノイズの取り除き方を計算する
- VAE:縮めた形から画像に戻す
画像生成AIのソフトでステップ数やサンプラーの欄を見かけたら、ノイズを取り除く流れのどこにかかわる設定かを考えてみてください。
あわせて読みたい
- 「画像生成AIの歴史|GAN・VAE・拡散モデル」(準備中) — 拡散モデルが出てくるまでの流れを知りたいとき
- 「潜在空間とVAE|画像を小さく縮めた計算」(準備中) — 画像を縮めて計算する仕組みと理由を知りたいとき
- 「AI建築パースのプロンプトの書き方|建物・素材・光・視点とテキストエンコーダの仕組み」(準備中) — プロンプトが数値になって絵に伝わる仕組みを知りたいとき
- 「サンプラーとステップ数|ノイズの取り方と回数」(準備中) — ノイズの取り除き方と回数の設定を知りたいとき
会員登録(無料)
記事やテーマのお気に入り・学習履歴・フォローが使えます。
この記事について
PERSC編集部が、建築の制作に関わる知識を実務目線で整理しています。内容は公開・更新日時点の情報にもとづきます。誤りや古い情報にお気づきの場合はお問い合わせよりご連絡ください。