Textual Inversion(Embedding)|新しい言葉の数値だけを学ぶ仕組み
- Textual Inversion って何?
- Embedding のファイルを見かけたが、何に使うものか分からない
- Textual Inversion と LoRA の違いを知りたい
Textual Inversion で学んだ結果は、Embedding と呼ばれる KB 単位の小さなファイルになります。ただ、何を学んだファイルなのかが分からないと、どう使えばよいかがつかめません。
この記事では、Textual Inversion の仕組みと Embedding の使い方を解説します。ネガティブプロンプトでの作り比べと、LoRA(モデルに差分を加える追加学習)との違いも分かります。
Textual Inversion は、画像生成AIのモデル(学習でできた、画像を作る仕組み)を変えずに、新しい言葉に当たる数値だけを学ぶ方法です。
Textual Inversionとは
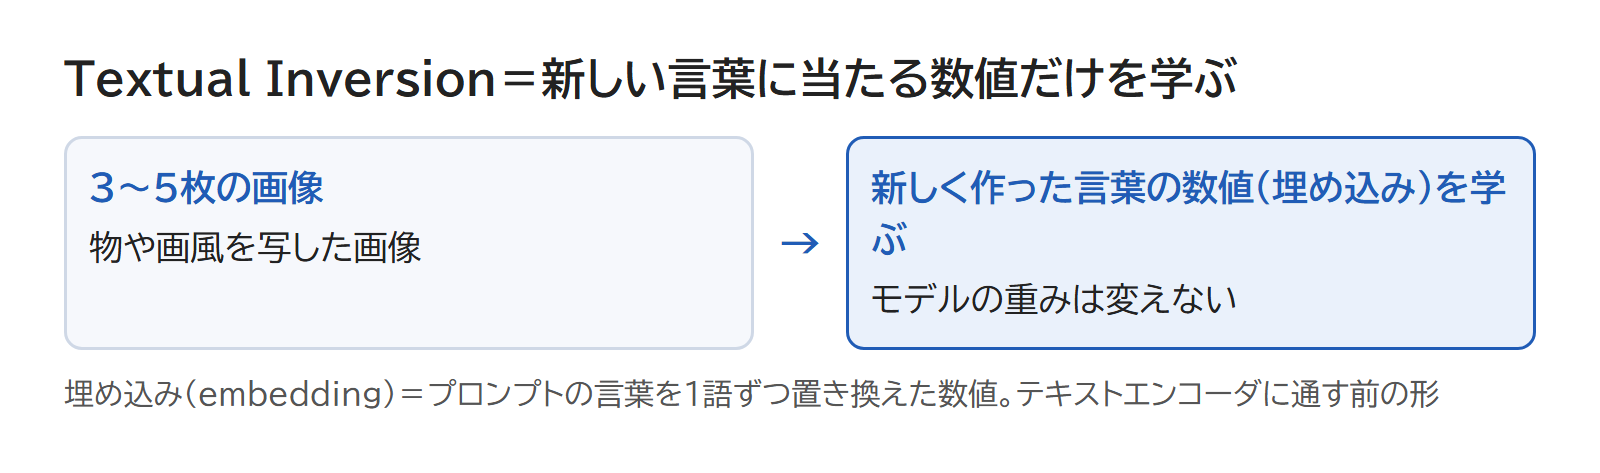
Textual Inversion(Embedding)とは、モデルを固定したまま、新しい言葉に当たる数値だけを学習する方法です。2022年に論文で発表されました。
プロンプトの言葉は、1語ずつ数値に置き換えられてから、テキストエンコーダ(言葉を画像の計算に使える形にする部品)に通されます。この、1語ずつに当たる数値が埋め込みで、英語では embedding です。
Textual Inversion は、物や画風を写した3〜5枚の画像から、それを表す新しく作った言葉の埋め込みを学びます。このとき、モデルの重み(モデルの中で計算に使う数値)は変えません。
日本語では「テキスト反転」とも訳されます。Embedding の語は、この方法の別名にも、学んだ数値を入れたファイルの名前にも使われます。
Embeddingのファイルとプロンプトでの呼び出し
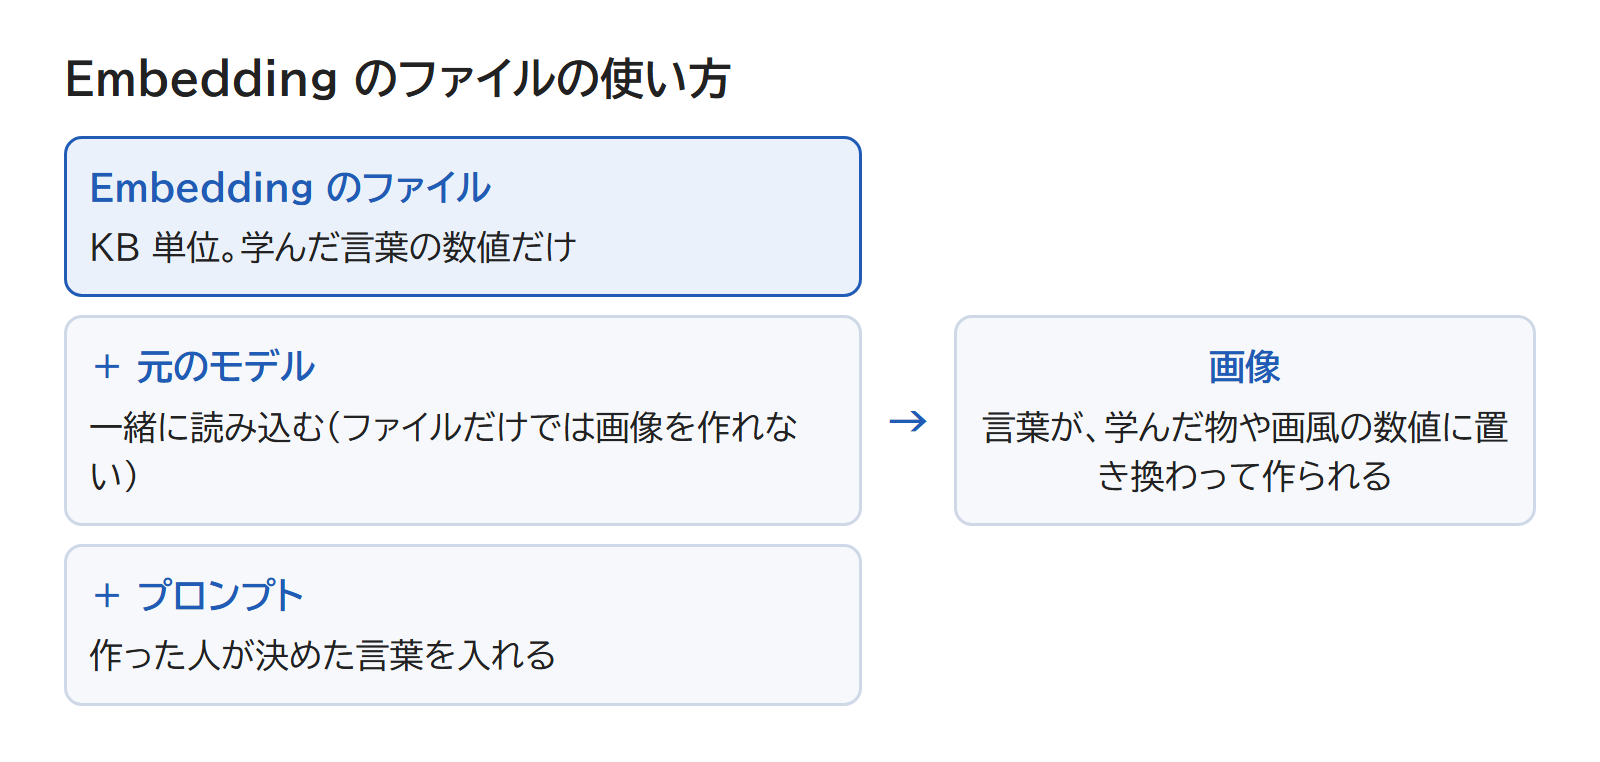
学んだ埋め込みは、KB 単位の小さなファイルになります。Diffusers(画像生成AIを動かす道具)の説明では、数KB です。
ファイルの中身は言葉の数値だけなので、Embedding はそれだけでは画像を作れません。使うときは、元のモデルと一緒に読み込みます。
読み込んだあとの呼び出しには、作った人が決めた言葉を使い、プロンプトに入れます。プロンプトの中のその言葉が、学んだ物や画風を表す数値に置き換わる仕組みです。
ネガティブに入れて使うEmbedding
物や画風を呼び出すほかに、望まないものを学ばせた Embedding を、ネガティブプロンプトに入れて使うこともできます。ネガティブプロンプトは、画像に出したくないものを書く欄です。
たとえば、ぼやけた画像や、手の指が多すぎる画像を出にくくするための Embedding があります。
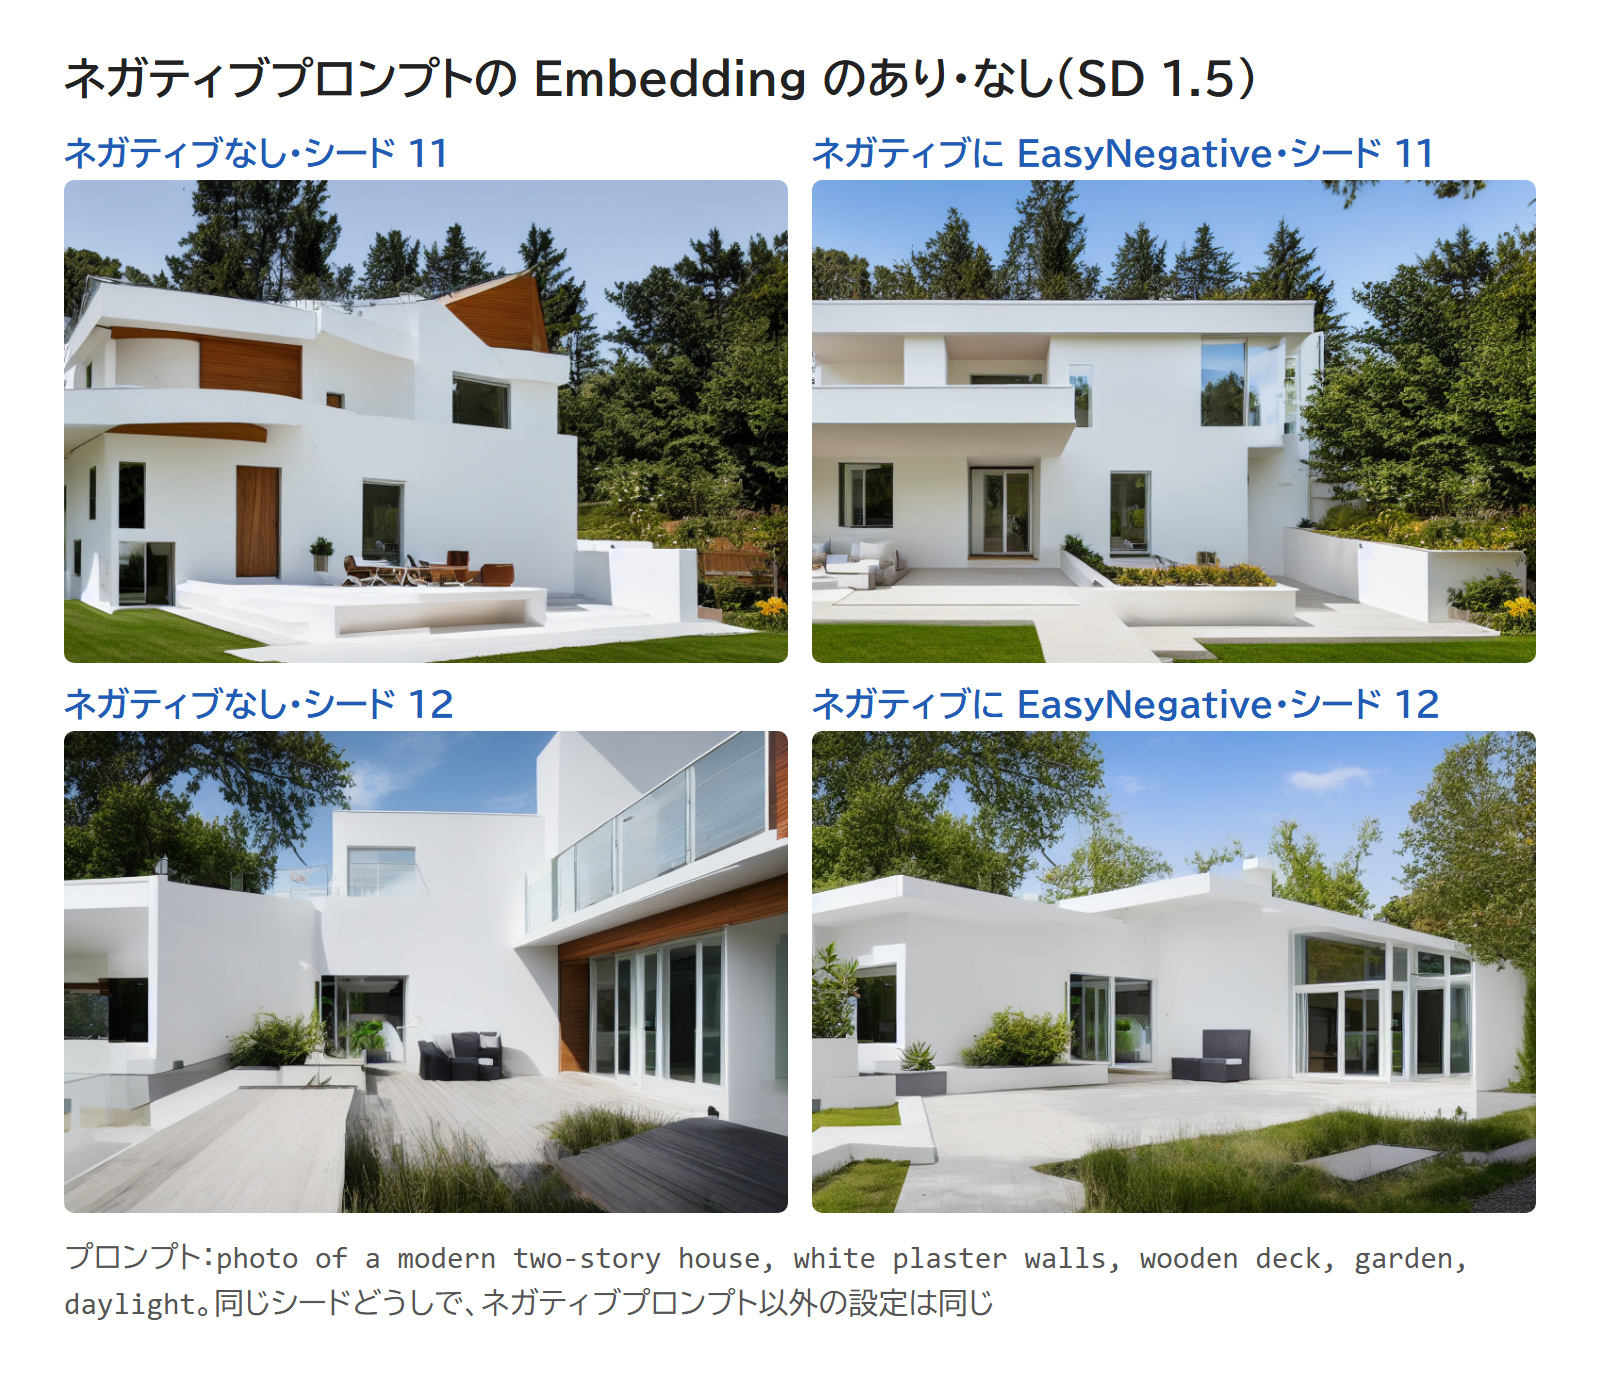
上の画像は、Stable Diffusion 1.5(画像生成AIのモデルの1つ)で作った4枚です。
ネガティブプロンプトを空にしたものと、ネガティブプロンプトに EasyNegative という Embedding だけを入れたものを比べました。
プロンプトは同じで、同じシード(シード値。初めのノイズを決める数)どうしで比べています。作例の EasyNegative のファイルは約24KB で、これも KB 単位です。
この試しでは、Embedding を入れると、家の形と構図が変わりました。モデルを替えなくても、小さなファイルを1つ足すだけで画像が変わったわけです。
どちらがよい画像か、崩れが減ったかまでは、この試しでは判定していません。
Textual InversionとLoRAの違い
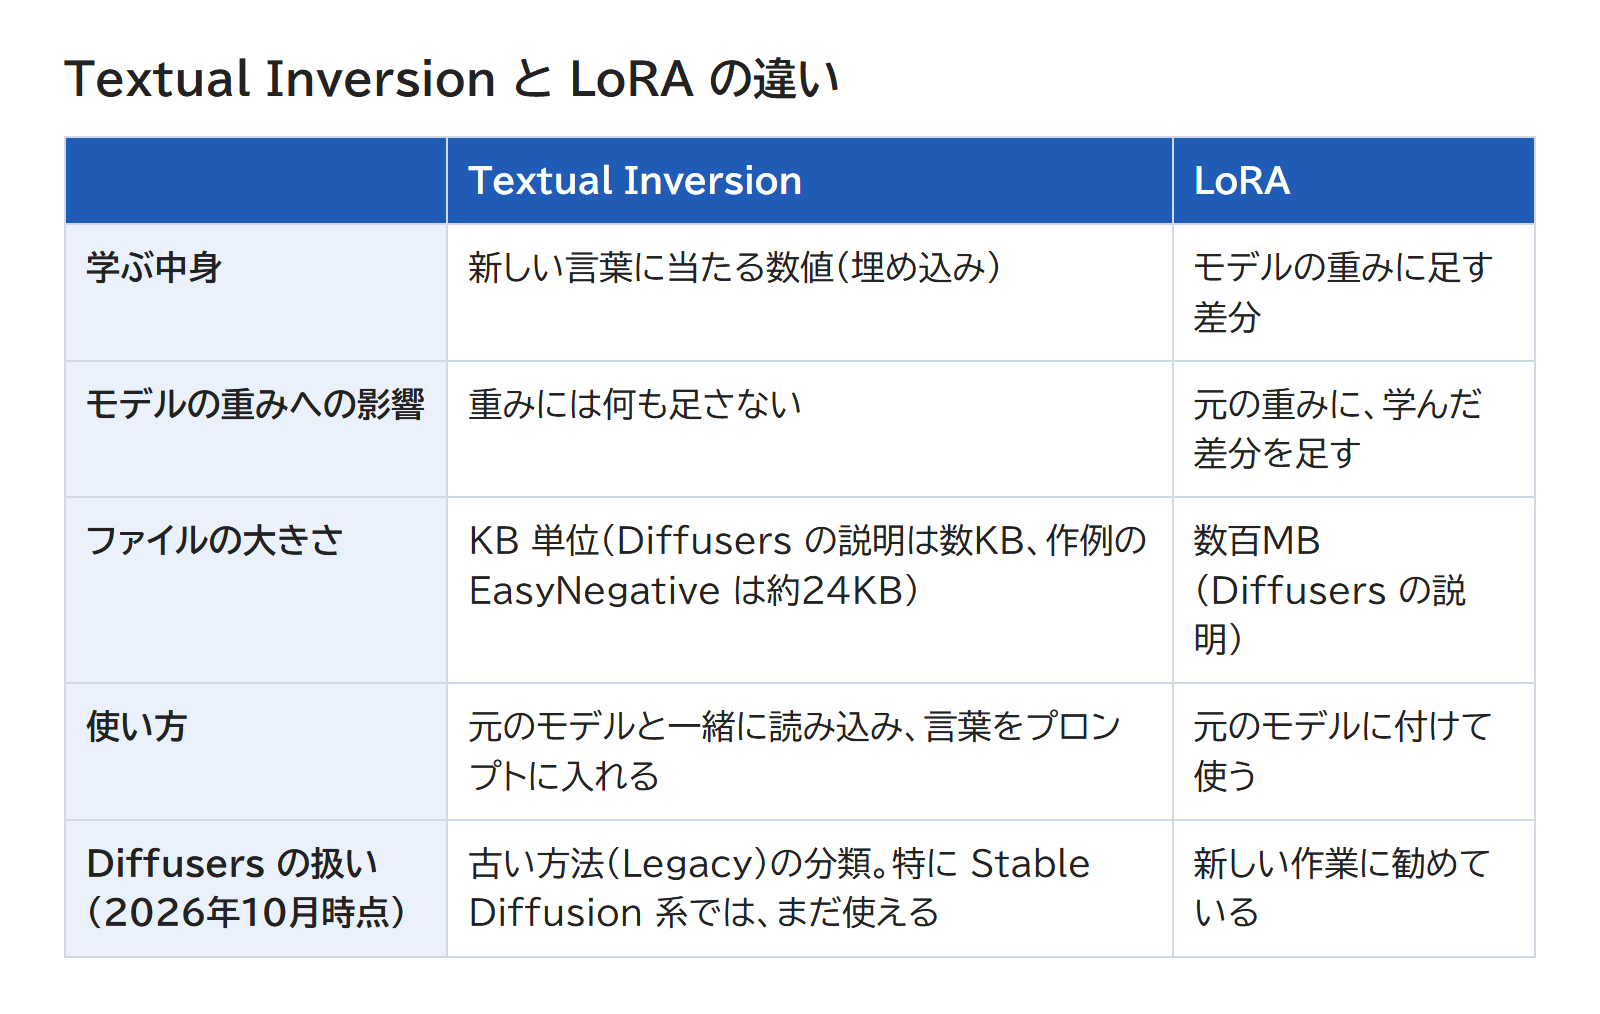
Embedding と同じく、あとから足して使う方法に LoRA があります。2つの違いは何を学ぶかで、Embedding は言葉の数値を、LoRA は元の重みに足す差分を学びます。
この違いが表れるのが、ファイルの大きさです。Embedding は KB 単位で、LoRA は Diffusers の説明で数百MB です。
道具での扱いにも、違いがあります。
Diffusers は、2026年10月時点で Textual Inversion を古い方法(Legacy)の分類に入れました。
そのうえで Diffusers は、特に Stable Diffusion 系のモデルではまだ使えるとし、新しい作業には LoRA などを勧めています。
新しく画風や物を加えるなら、この勧めにならって LoRA を選ぶとよいでしょう。ただし、Stable Diffusion 系のモデル用に作られた Embedding は、今も使えます。
Textual Inversionの仕組みを知ってEmbeddingを使い分けよう
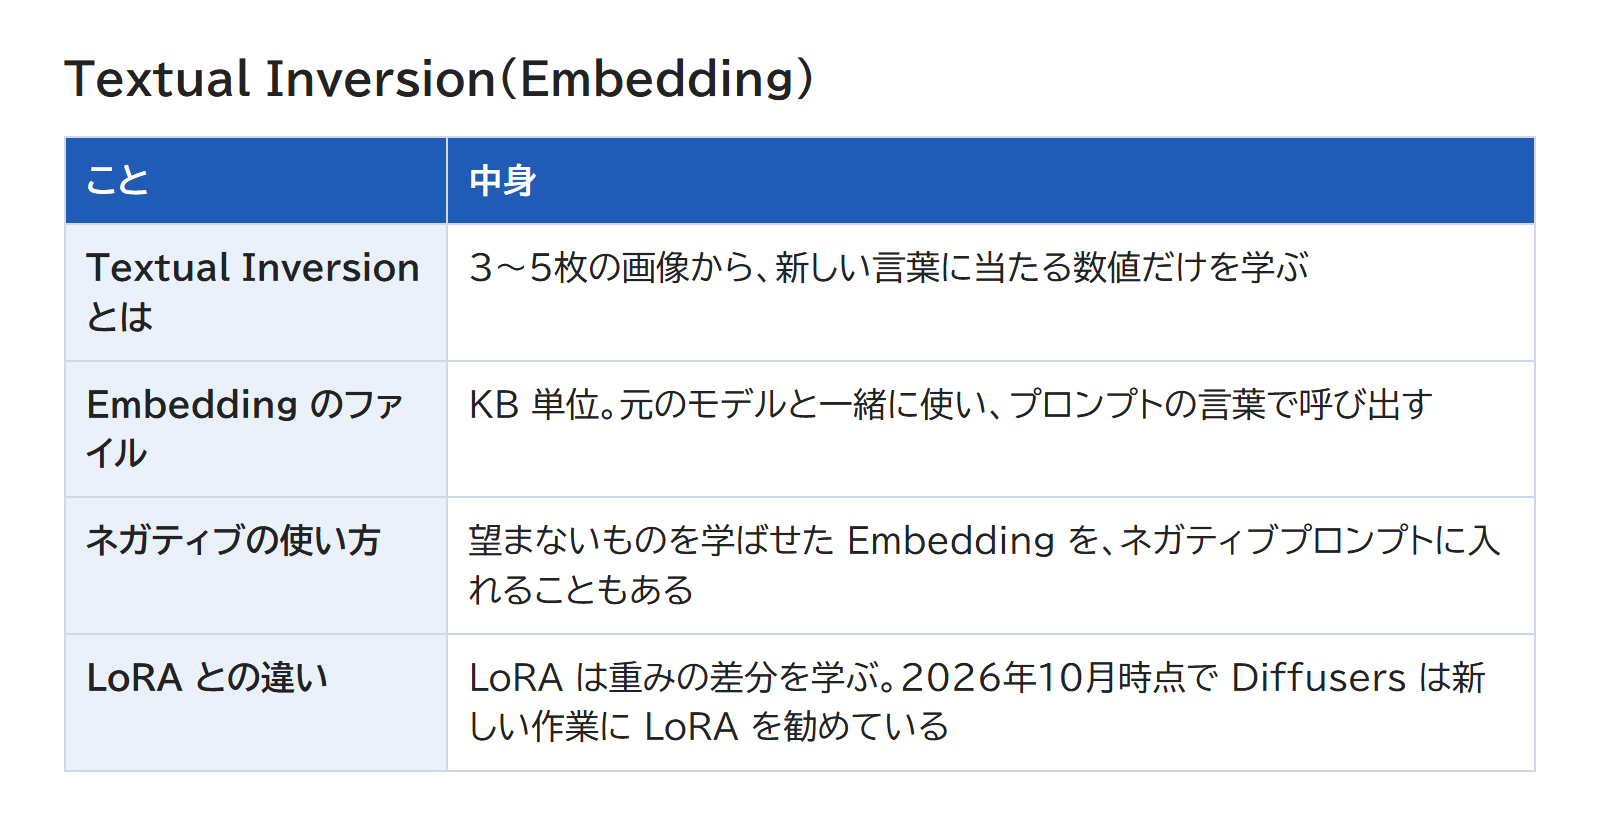
Embedding のファイルの中身は、新しく作った言葉の数値です。この記事で解説したことは、次の4つです。
- Textual Inversion は、3〜5枚の画像から、新しい言葉に当たる数値だけを学ぶ
- 学んだ数値は KB 単位の Embedding のファイルになり、元のモデルと一緒に使う
- 望まないものを学ばせた Embedding は、ネガティブプロンプトに入れて使うこともある
- LoRA は重みの差分を学ぶ点が違い、2026年10月時点で Diffusers は新しい作業に LoRA を勧めている
Embedding を使うときは、元のモデルと一緒に読み込み、作った人が決めた言葉をプロンプトに入れてみてください。
あわせて読みたい
- 「LoRA|小さなファイルでの追加学習」(準備中) — モデルの重みに差分を足す、もう1つの追加学習の方法を知りたいとき
- 「AI建築パースのプロンプトの書き方|建物・素材・光・視点とテキストエンコーダの仕組み」(準備中) — プロンプトの言葉が数値に変わる仕組みを、くわしく知りたいとき
- ComfyUIのEmbeddingの使い方|テキスト反転 — ComfyUI で Embedding のファイルを置き、プロンプトで呼び出す操作を知りたいとき
- 「img2imgとノイズ除去強度|元の画像にどれだけ似せるか」(準備中) — プロンプトだけでなく、元の画像から画像を作る方法を知りたいとき
会員登録(無料)
記事やテーマのお気に入り・学習履歴・フォローが使えます。
この記事について
PERSC編集部が、建築の制作に関わる知識を実務目線で整理しています。内容は公開・更新日時点の情報にもとづきます。誤りや古い情報にお気づきの場合はお問い合わせよりご連絡ください。