ComfyUIのセグメント|SAM 3.1・しきい値・個別のマスク・動画
- SAM3 は、ComfyUI でどう使うの?
- 「sofa」のように言葉で物を指して、マスクを自動で作りたい
- segment anything のワークフローを、動画の場合まで知りたい
ComfyUI(コンフィユーアイ)で画像の一部を直すときは、直す範囲をマスク(白黒で範囲を示す画像)で決めます。しかし、家具の形に沿ってマスクを手で描くのは手間がかかります。
SAM 3.1 は、画像や動画の中から、英語の言葉で指した物の形を切り分けるモデルです。この記事では、SAM 3.1 で物を見つけてマスクにする方法を解説します。
見つける数と確からしさの設定、動画の中の物をフレーム(動画の1コマ)をまたいで追いかける方法も分かります。
画面:ComfyUI v0.37.0 ポータブル版(Windows・2026年9月)SAM 3.1を使う前に
SAM 3.1 は、画像や動画の中から、言葉で指した物の形を切り分けるモデルです。Meta が作ったモデルで、ノードの名前は「SAM3」で始まります。
画像を物ごとに切り分けることを、セグメンテーション(セグメント)と呼びます。
SAM 3.1 を使うのは、ComfyUI に初めから入っている組み込みのノードです。始める前に知っておくことは、次の4つです。
- モデルのファイルは
sam3.1_multiplex_fp16.safetensorsの1つ。Hugging Face(AI のモデルを配るサイト)の Comfy-Org/sam3.1 で配られていて、ライセンスは Meta の SAM License - 落としたファイルは
ComfyUI/models/checkpointsに置く。ポータブル版ではComfyUI_windows_portable\ComfyUI\models\checkpointsにあたる。ComfyUI を開いたまま置いたときは、キャンバスの上でRキーを押すとモデルの一覧が読み直される - ノード(処理を1つずつ受け持つ部品)は、キャンバス(ノードを並べる真ん中の広い所)の何も無い所をダブルクリックして開く「ノード検索」に、名前を打って置く。初めからあるノードは、そのまま残しておいてかまわない
- マスクの形は、マスクを白黒で見せるノード「MaskPreview」で見る。日本語の表示でも、名前は英語のまま
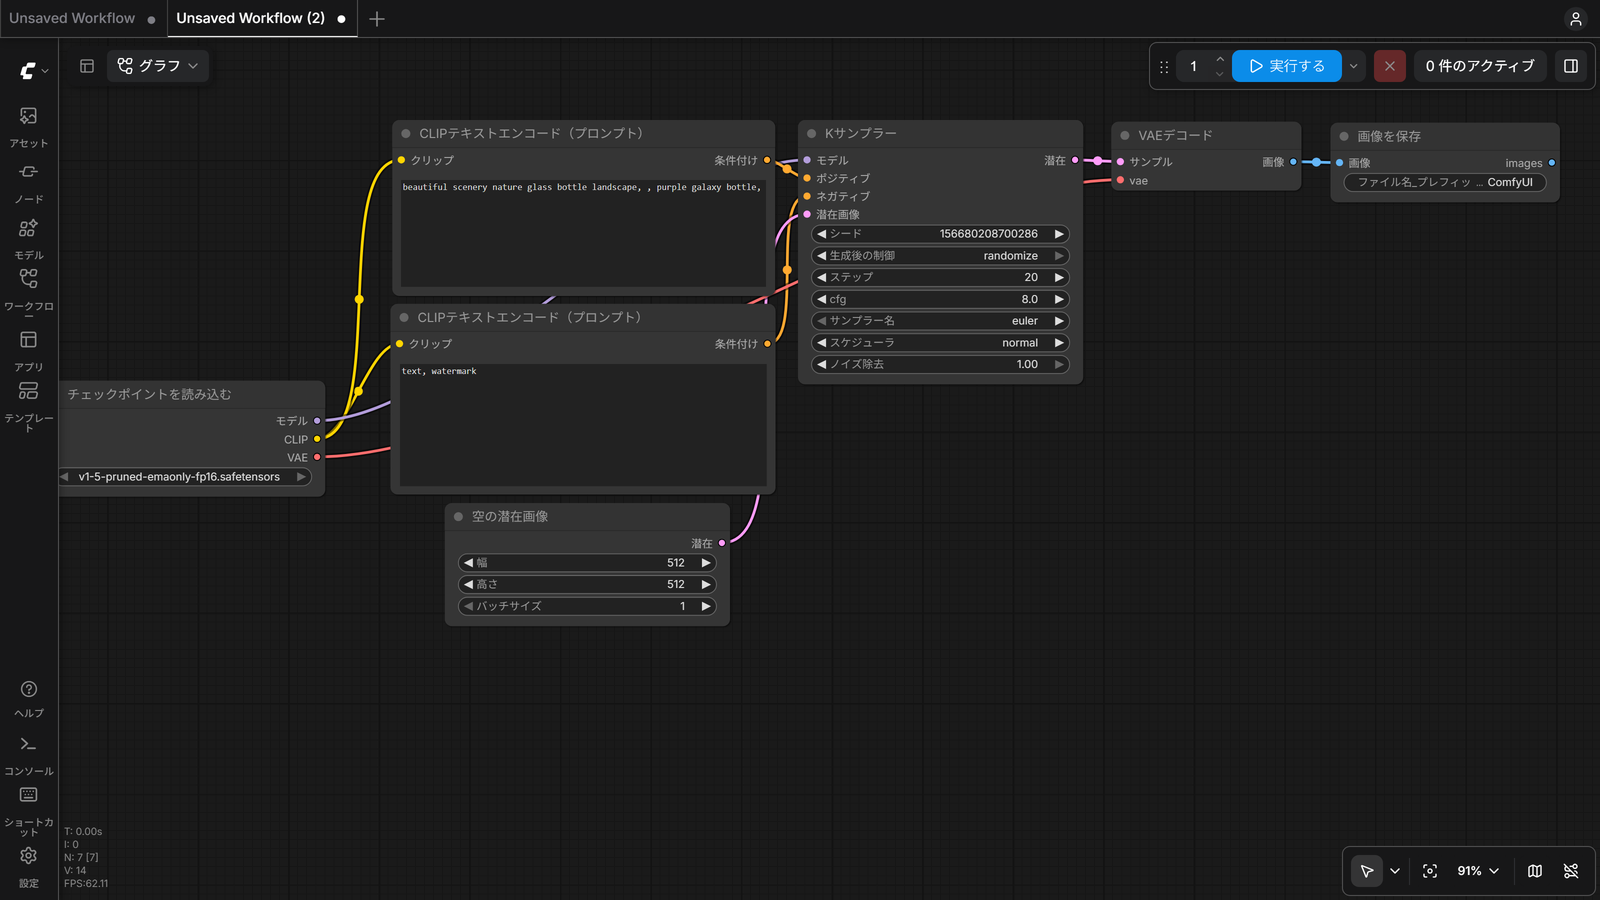
この記事では、ノードの名前を日本語の表示で書きました。画面が英語なら、左の列の設定(歯車)を押し、Language を日本語にします。
SAM3検出で画像の中の物をマスクにする
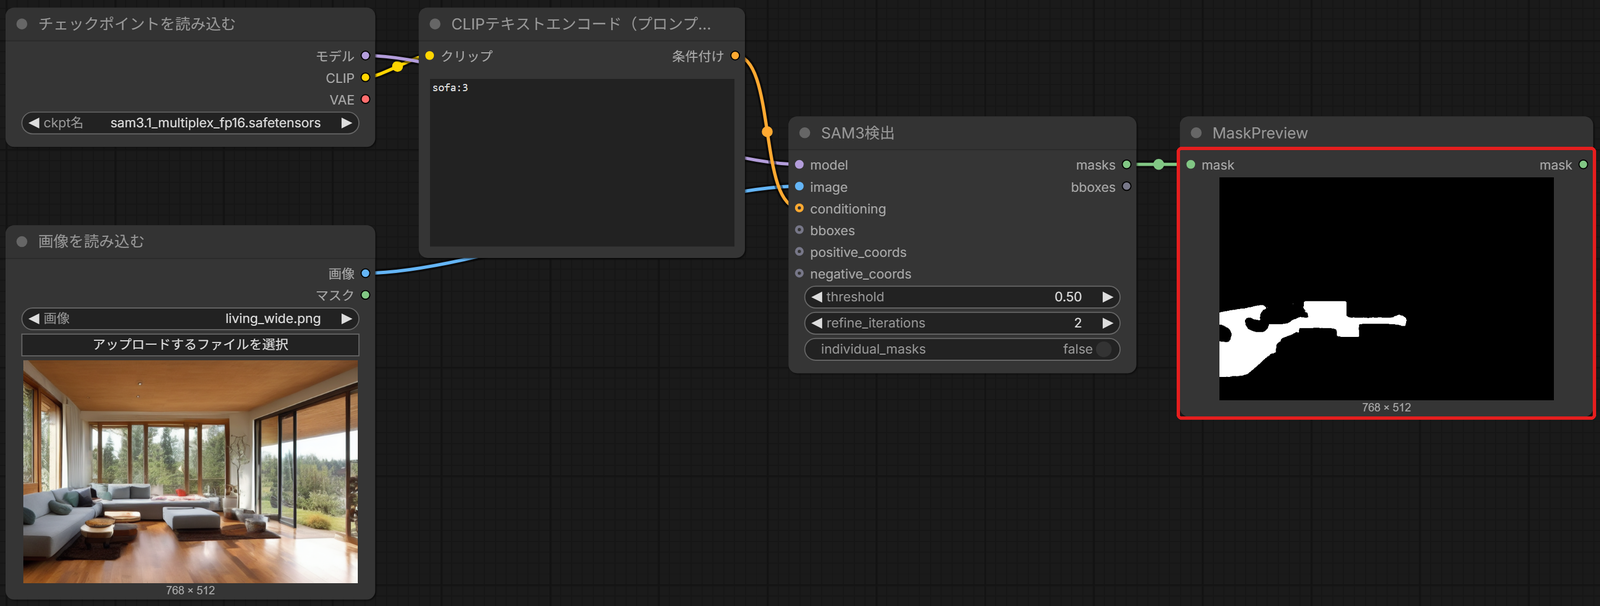
「SAM3検出」(SAM3_Detect)は、画像と言葉を受け取り、言葉で指した物のマスクを出すノードです。SAM3検出の使い方は、次の2つです。
- ソファのマスクを作る
- 見つける数を指定する
ソファのマスクを作る
居間の画像から、ソファの形のマスクを作ります(手元の部屋の画像でもかまいません)。
使うのは、チェックポイントを読み込む・CLIPテキストエンコード・画像を読み込む・SAM3検出・MaskPreview の5つのノードです。
SAM 3.1の
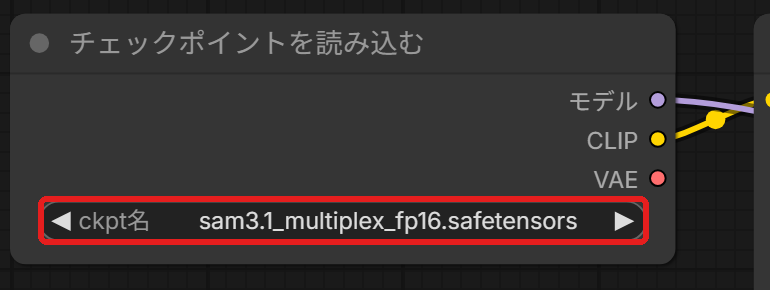
ノード検索でチェックポイントを読み込むを置き、ckpt名の欄を押して sam3.1_multiplex_fp16.safetensors を選びます。
ckpt名の欄に sam3.1_multiplex_fp16.safetensors が入りました。使う出力は、モデルとCLIP(打った言葉を読み取る部品)の2つです。
指す言葉を
ノード検索でCLIPテキストエンコード(プロンプト)を置き、チェックポイントのCLIPの出力からクリップの入力へドラッグします。テキストの欄に sofa:3 と打ってください。
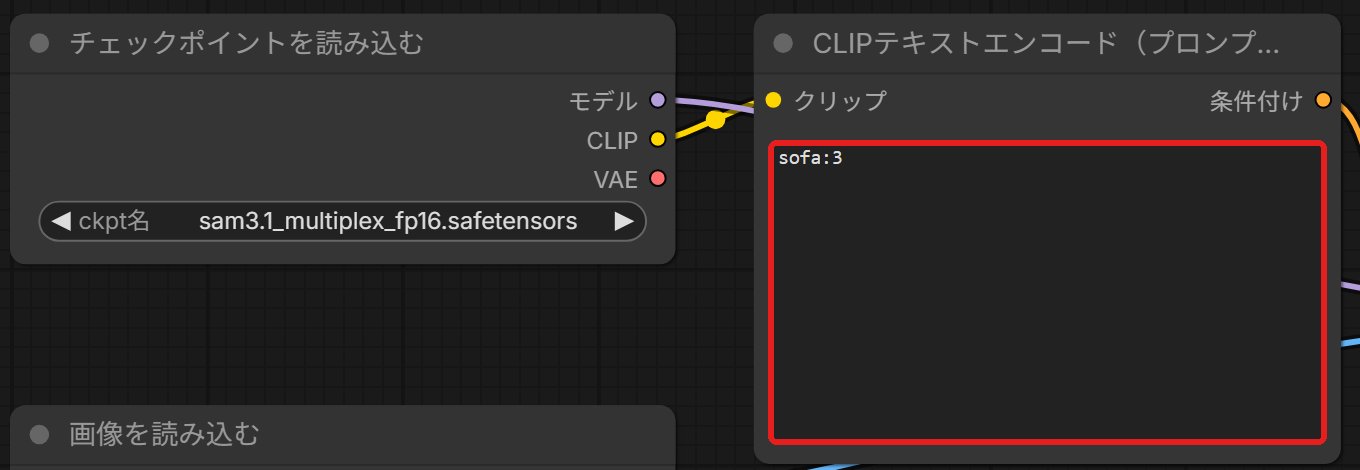
欄に sofa:3 が入りました。右の条件付けから、この言葉がモデルの読める形になって出ます。
物を
ノード検索で画像を読み込むを置き、アップロードするファイルを選択を押して、ソファの写る画像を選びます。
ノードの中に、選んだ画像が出ました。
「SAM3検出」
ノード検索でSAM3検出を置き、チェックポイントのモデルをmodelへ、画像の画像をimageへ、CLIPテキストエンコードの条件付けをconditioningへドラッグします。
SAM3検出のmodel・image・conditioningの3つが、つながりました。
MaskPreviewにつないで
SAM3検出のmasksの出力から線を引き出し、何も無い所で離して開くノード検索でMaskPreviewを選びます。右上の実行するを押してください。
MaskPreview に、ソファの形の白いマスクが出ました。
これで、言葉で指したソファの形のマスクができました。masksの出力は、マスクを受け取るほかのノードにもつなげます。
見つける数を指定する
SAM3検出では、言葉のあとに「:数」を付けないと、見つかるのは1つだけです。テキストの欄を sofa と sofa:3 にして比べると、見つかる数が変わります。
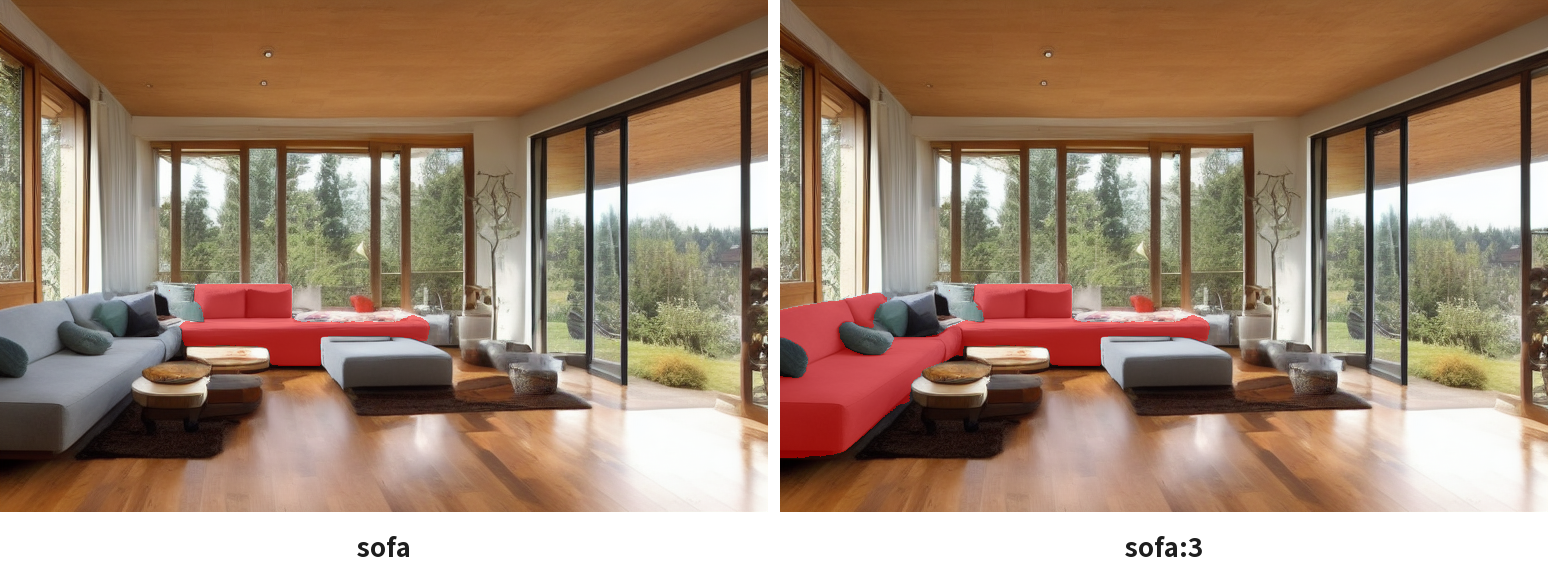
いくつかの物を指すときは、sofa:3, window:2 のようにカンマで区切り、物ごとに数を付けます。指す言葉は、sofa や window のような短い英語の名前です。
SAM3検出のthresholdとindividual_masks
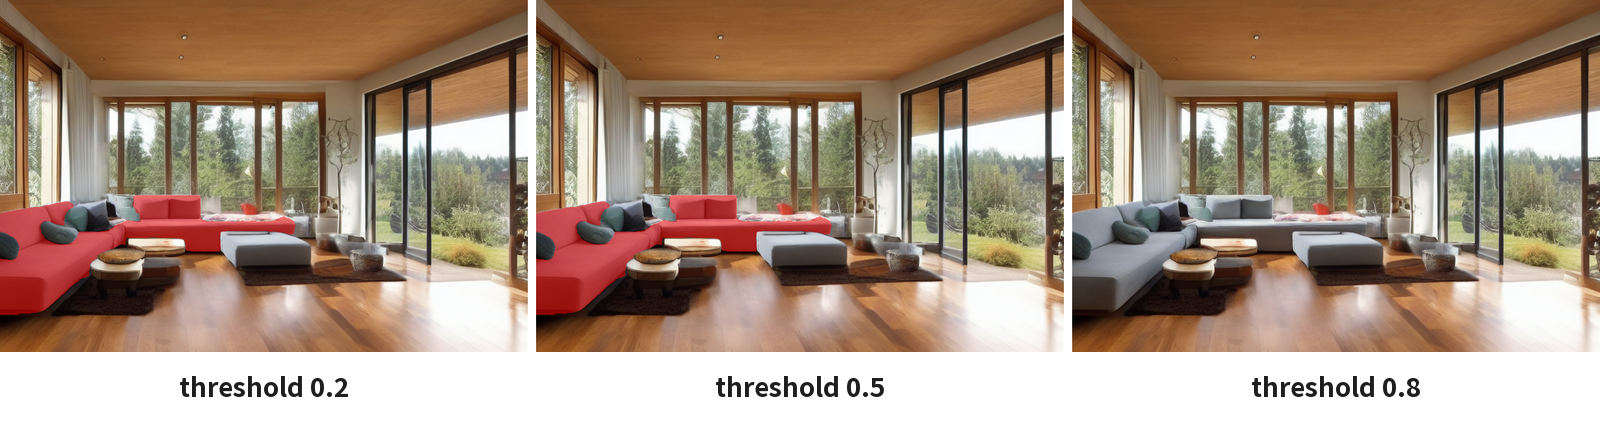
SAM3検出の見つけ方は、ノードの下の3つの欄で変えます。3つの欄と初めの値を、次の表にまとめました。
| 欄 | 初めの値 | 働き |
|---|---|---|
| threshold | 0.50 | 見つけたと見なす確からしさの下限(0〜1)。大きいほど、確かな物だけが残る |
| refine_iterations | 2 | マスクの形を整え直す回数(0〜5)。0 は整え直さない |
| individual_masks | false | true にすると、見つけた物を1つずつ別のマスクで出す |
threshold と individual_masks の使い方は、次の2つです。
- thresholdを変える
- 物ごとにマスクを分ける
thresholdを変える
見つからないときは threshold を下げ、ほかの物まで入るときは上げます。
「threshold」
SAM3検出のノードのthresholdの欄を押し、試す数(たとえば 0.8)を打ってEnterキーを押します。
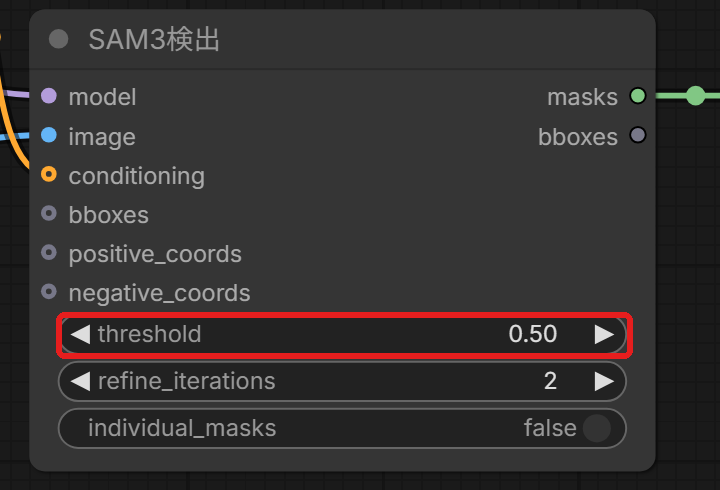
欄に、打った数が入りました。
実行して比べる
右上の実行するを押し、MaskPreview のマスクを見ます。
MaskPreview の白い所が、threshold に合わせて変わりました。試したあとは、thresholdを 0.50 に戻しておきます。
物ごとにマスクを分ける
individual_masks を false のままにすると、見つけた物はすべて1つのマスクにまとまります。true にすると、見つけた物ごとに別のマスクが出ます。
「individual_masks」
SAM3検出のノードの一番下のindividual_masksの欄を押します。
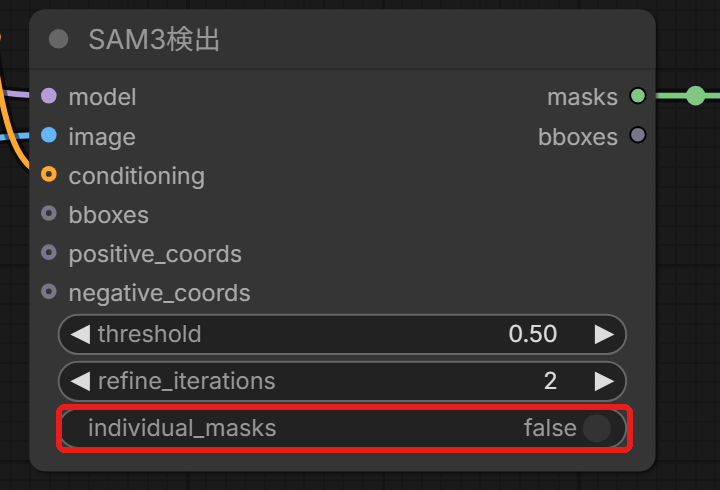
欄が false から true に変わりました。
実行して確かめる
sofa:3 のまま、右上の実行するを押します。
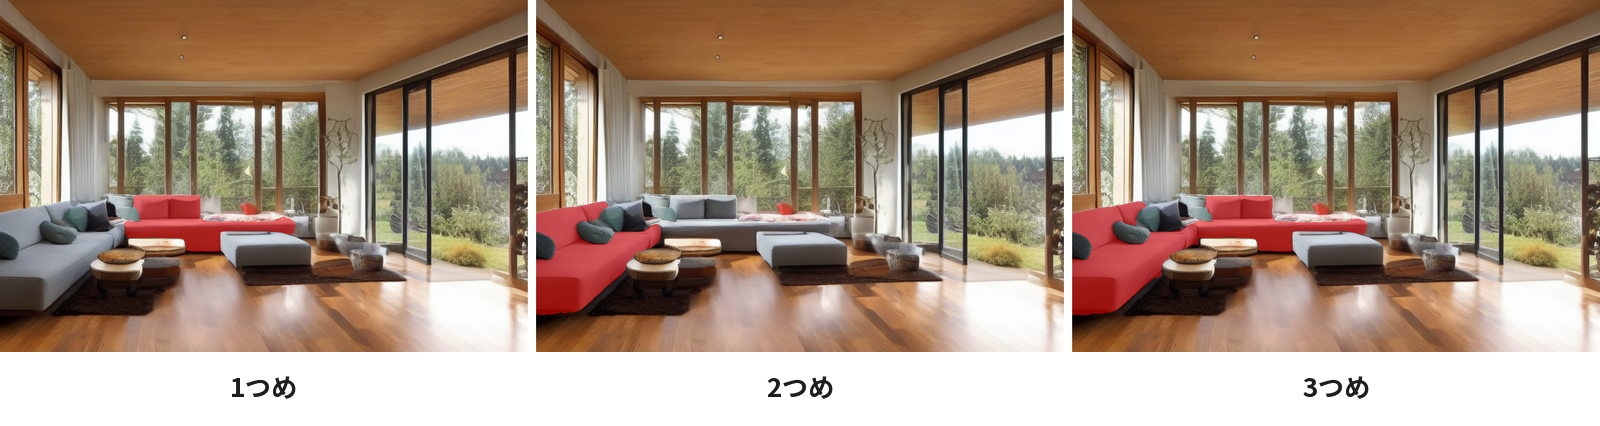
MaskPreview に、見つけた物ごとに分かれた3枚の白黒のマスクが並びました。
SAM3ビデオトラックで動画の中の物を追いかける
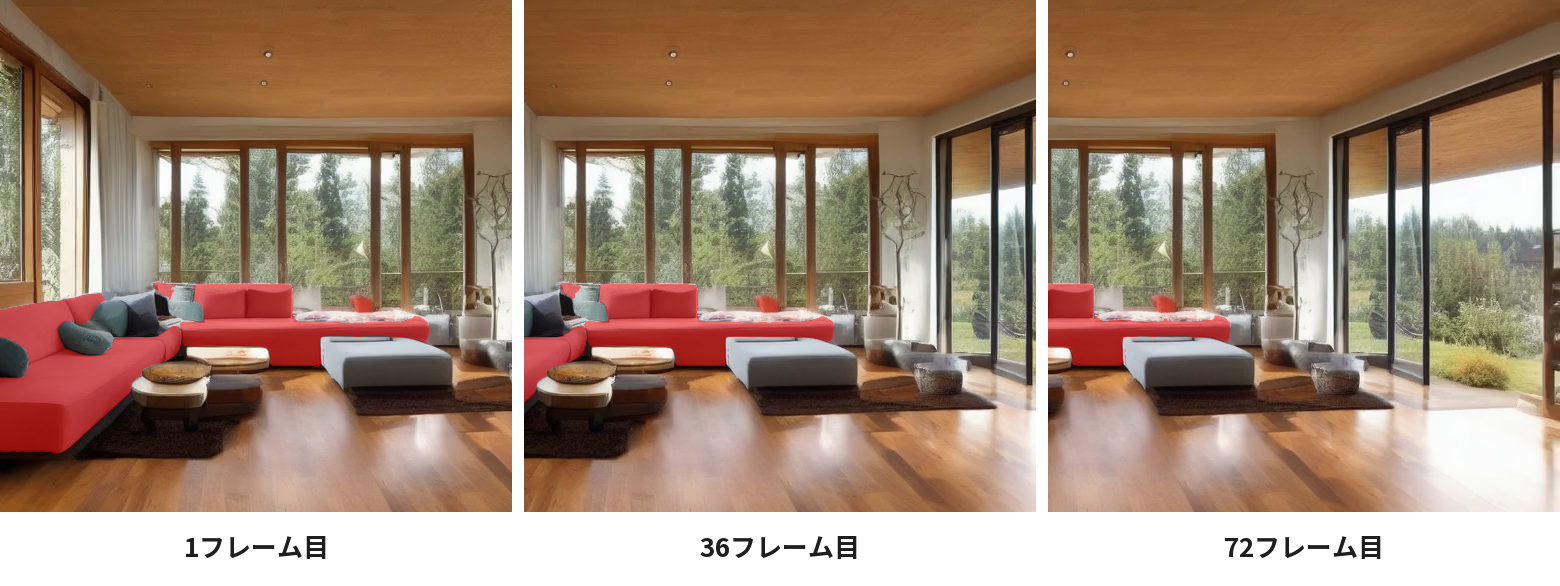
「SAM3ビデオトラック」(SAM3_VideoTrack)は、動画の中の物を、フレームをまたいで追いかけるノードです。
動画では「:数」は使われず、追いかける数の上限はmax_objectsの欄で決まります。
動画を読み込むノードは、「ComfyUIの動画の読み込みと書き出し|Load Video・Save Video・VideoHelperSuite」(準備中)の記事で解説します。
SAM3ビデオトラックの使い方は、次の2つです。
- ソファを追いかける
- 動画のノードの設定
ソファを追いかける
始める前に、チェックポイントを読み込むで sam3.1_multiplex_fp16.safetensors を選び、そのCLIPにつないだCLIPテキストエンコード(プロンプト)に sofa と打っておきます。
動画を
ノード検索でビデオを読み込むを置き、アップロードするファイルを選択を押して、動画を選びます。
ノードに、選んだ動画が読み込まれました。
動画を
ノード検索でビデオコンポーネントの取得を置き、ビデオを読み込むのビデオの出力を、置いたノードのビデオの入力へドラッグします。
このノードの画像の出力から、フレームが1枚ずつの画像として出るようになりました。
「SAM3ビデオトラック」
ノード検索でSAM3ビデオトラックを置きます。
ビデオコンポーネントの取得の画像をimagesへ、チェックポイントのモデルをmodelへ、CLIPテキストエンコードの条件付けをconditioningへドラッグしてください。
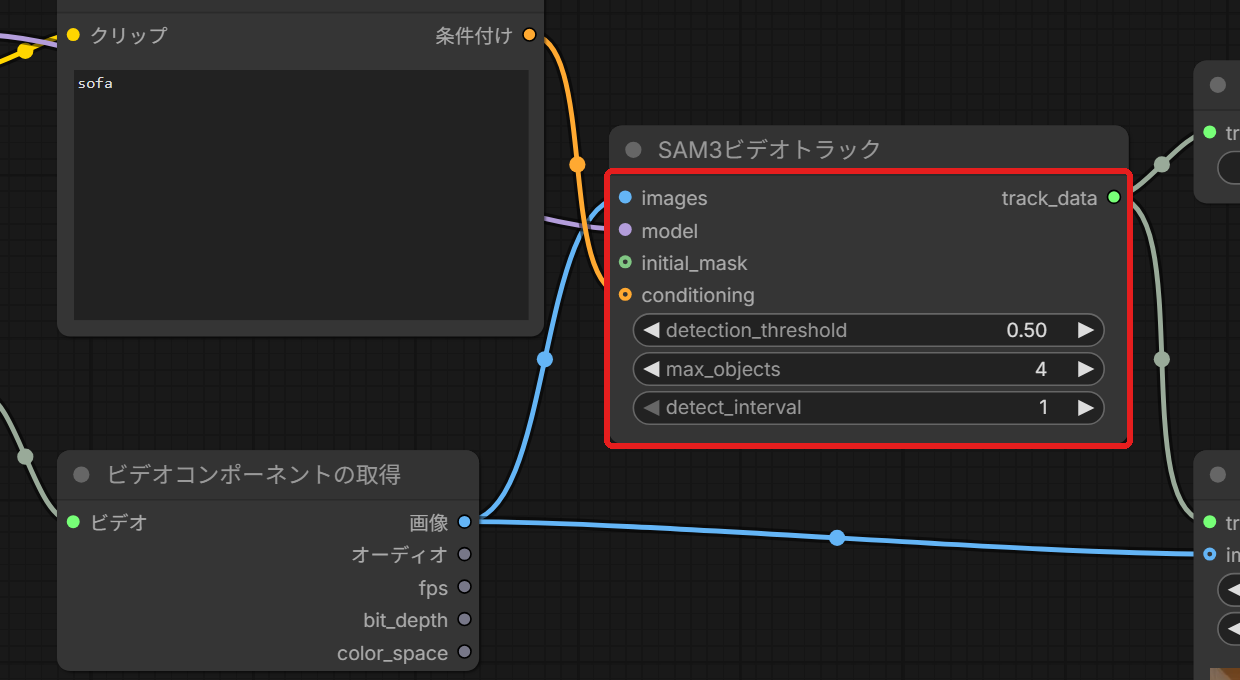
SAM3ビデオトラックのimages・model・conditioningの3つが、つながりました。
マスクと
ノード検索でSAM3トラックからマスクとSAM3トラックプレビューを置き、SAM3ビデオトラックのtrack_dataを2つにつなぎます。
SAM3トラックからマスクの出力にはノード検索でMaskPreviewを置いてつなぎ、SAM3トラックプレビューのimagesにはビデオコンポーネントの取得の画像をつないでください。
追いかけた結果を、マスクと色を重ねた動画の両方で見られるようになりました。
実行する
右上の実行するを押します。
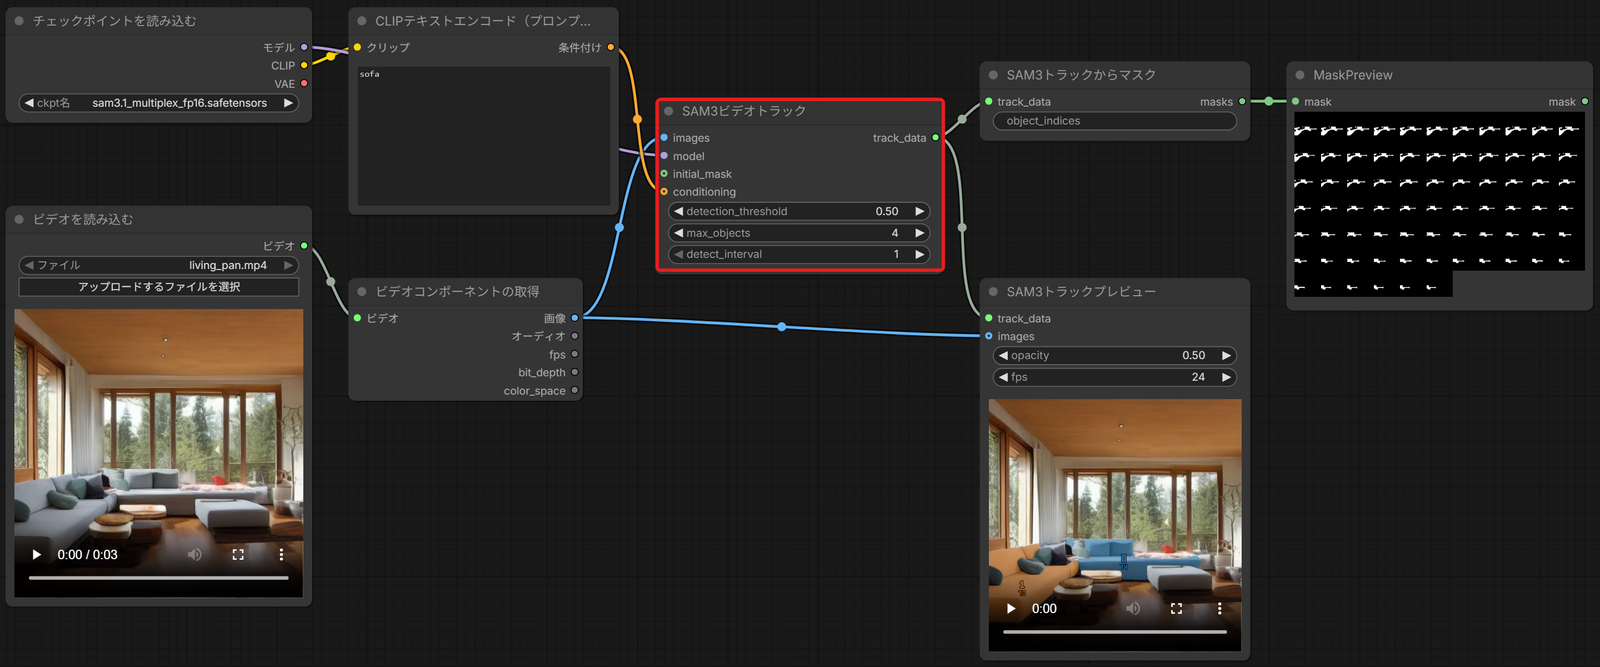
SAM3トラックプレビューに、ソファに色を重ねた動画が出ました。
これで、動画のフレームのそれぞれに、ソファのマスクができました。
動画のノードの設定
動画で使う3つのノードには、追いかけ方と見せ方を決める欄があります。欄と初めの値は、次の表のとおりです。
| ノード | 欄 | 初めの値 | 働き |
|---|---|---|---|
| SAM3ビデオトラック | detection_threshold | 0.50 | 見つけたと見なす確からしさの下限 |
| SAM3ビデオトラック | max_objects | 4 | 追いかける物の数の上限。0 にすると上限は 64 |
| SAM3ビデオトラック | detect_interval | 1 | 何フレームごとに見つけ直すか。大きくすると処理が軽くなる |
| SAM3トラックからマスク | object_indices | 空 | マスクにする物の番号(0 から数える)を「0,2」のようにカンマで指定する。空なら全部 |
| SAM3トラックプレビュー | opacity・fps | 0.50・24 | 重ねる色の濃さと、プレビューの動画のコマの速さ |
SAM3ビデオトラックのinitial_maskの入力には、1フレーム目のマスクをつなげます。つないだマスクの物を、フレームをまたいで追いかけます。
SAM 3.1でうまくいかないとき
SAM 3.1 でうまくいかないときの症状は、次の3つです。
- 何も見つからない
- 1つしか見つからない
- 動画で同じ物を追いかけられない
何も見つからない
原因の1つは、SAM3検出のthresholdが高いことです。作例では、0.8 にすると何も見つかりませんでした。
thresholdを初めの値の 0.50 に戻すか、それより下げて実行し直します。
1つしか見つからない
原因は、言葉に見つける数を付けていないことです。数を付けない言葉で見つかるのは、1つまでです。
sofa:3 のように、言葉のあとに「:数」を付けて実行し直します。
動画で同じ物を追いかけられない
原因は、動画のフレームに SAM3検出をかけていることです。SAM3検出は、フレームをまたいで同じ物を追いかける情報(track_data)を出しません。
動画では、SAM3ビデオトラックを使います。
公式のテンプレート「動画セグメンテーション: SAM3」も SAM3検出を全フレームにかける組み方なので、追いかけたいときは SAM3ビデオトラックに組み替えます。
SAM 3.1で、部屋の家具を言葉で選んでマスクにしよう
SAM 3.1 は、言葉で指した物の形を切り分けるモデルです。この記事の要点は、次の4つです。
- 画像では、チェックポイントを読み込む(SAM 3.1)・CLIPテキストエンコード・画像を読み込むを SAM3検出につなぐ
- 見つける数は「sofa:3」のように言葉のあとに付け、付けないと1つだけ
- threshold で見つけ方の厳しさを、individual_masks で物ごとに分けるかを決める
- 動画では SAM3ビデオトラックで追いかけ、SAM3トラックからマスクでマスクにする
まずは部屋の画像を読み込んで、sofa:3 でソファのマスクを作ってみてください。
あわせて読みたい
- ComfyUIのインペイント|マスクした部分の作り直し — 作ったマスクの所だけを作り直したいとき
- ComfyUIの画像を加工するノード|大きさ・切り抜き・色・合成・フィルタ — マスクと組み合わせる画像の加工のノードを知りたいとき
- ComfyUIのimg2img|Load Image・VAE Encode・デノイズ — 画像の全体を、元の画像をもとに作り直したいとき
会員登録(無料)
記事やテーマのお気に入り・学習履歴・フォローが使えます。
この記事について
PERSC編集部が、建築の制作に関わる知識を実務目線で整理しています。内容は公開・更新日時点の情報にもとづきます。誤りや古い情報にお気づきの場合はお問い合わせよりご連絡ください。