潜在空間とVAE|画像を小さく縮めた計算
- 画像生成AIの VAE って何をしているの?
- 潜在空間という言葉が分からない
- 潜在拡散モデルの仕組みを知りたい
ComfyUI のような画像生成AIのソフトには、VAE という部品が出てきます。しかし、画像を作る中心は拡散モデル(ノイズを取り除いて画像を作る仕組み)なので、VAE の役目は見えにくいものです。
この記事では、潜在空間と VAE の意味と、画像を縮めて計算する潜在拡散モデルの流れを解説します。縮めて計算する理由と、縮めることで画像に起きる変化も分かります。
潜在空間は画像を小さく縮めた数の並びが置かれる所で、VAE はそこへ画像を縮めて、また画像へ戻す部品です。
潜在空間とVAEとは
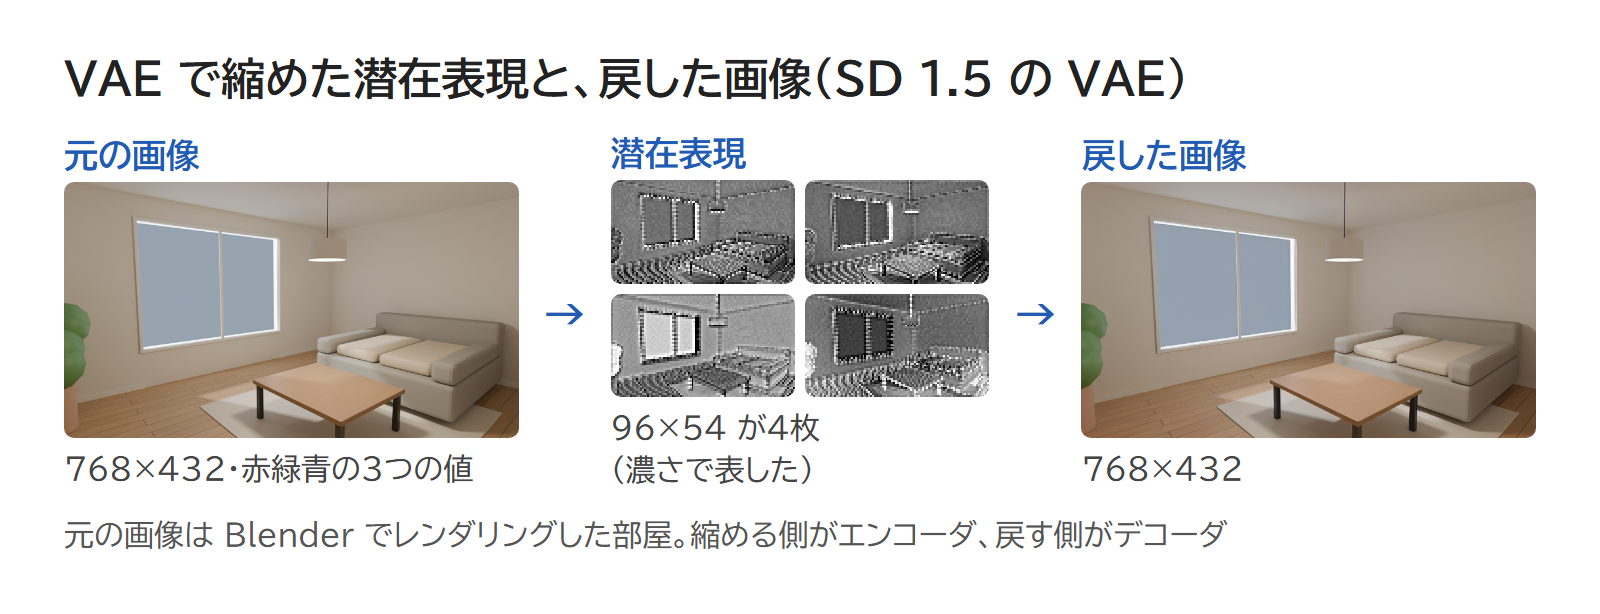
潜在空間とは、画像を縮めた数の並び(潜在表現)が置かれる空間のことです。画像は、画素ごとに赤・緑・青の3つの値を持つ数の集まりで、それを小さな数の並びに縮めたものが潜在表現にあたります。
VAE(変分オートエンコーダ)は、画像を潜在表現に縮め、潜在表現から画像に戻す部品です。縮める側をエンコーダ、戻す側をデコーダと呼びます。
画像生成AIのモデルの Stable Diffusion 1.5 では、VAE が画像の縦と横をそれぞれ8分の1にし、色の3つの並びを4つの並びにします。4つの並びは、色そのものではなく計算のための値です。
上の図では、768×432 の部屋の画像が、96×54 の数の並び4枚になりました。この試しで4枚を1つずつ灰色の濃さで表すと、どれにも窓やソファの形が残っていました。
Stable Diffusion は、ノイズを取り除く拡散の計算を、画像のままでなくこの潜在空間の中で行います。この作り方が、潜在拡散モデルです。
潜在拡散モデルでVAEを使う場面
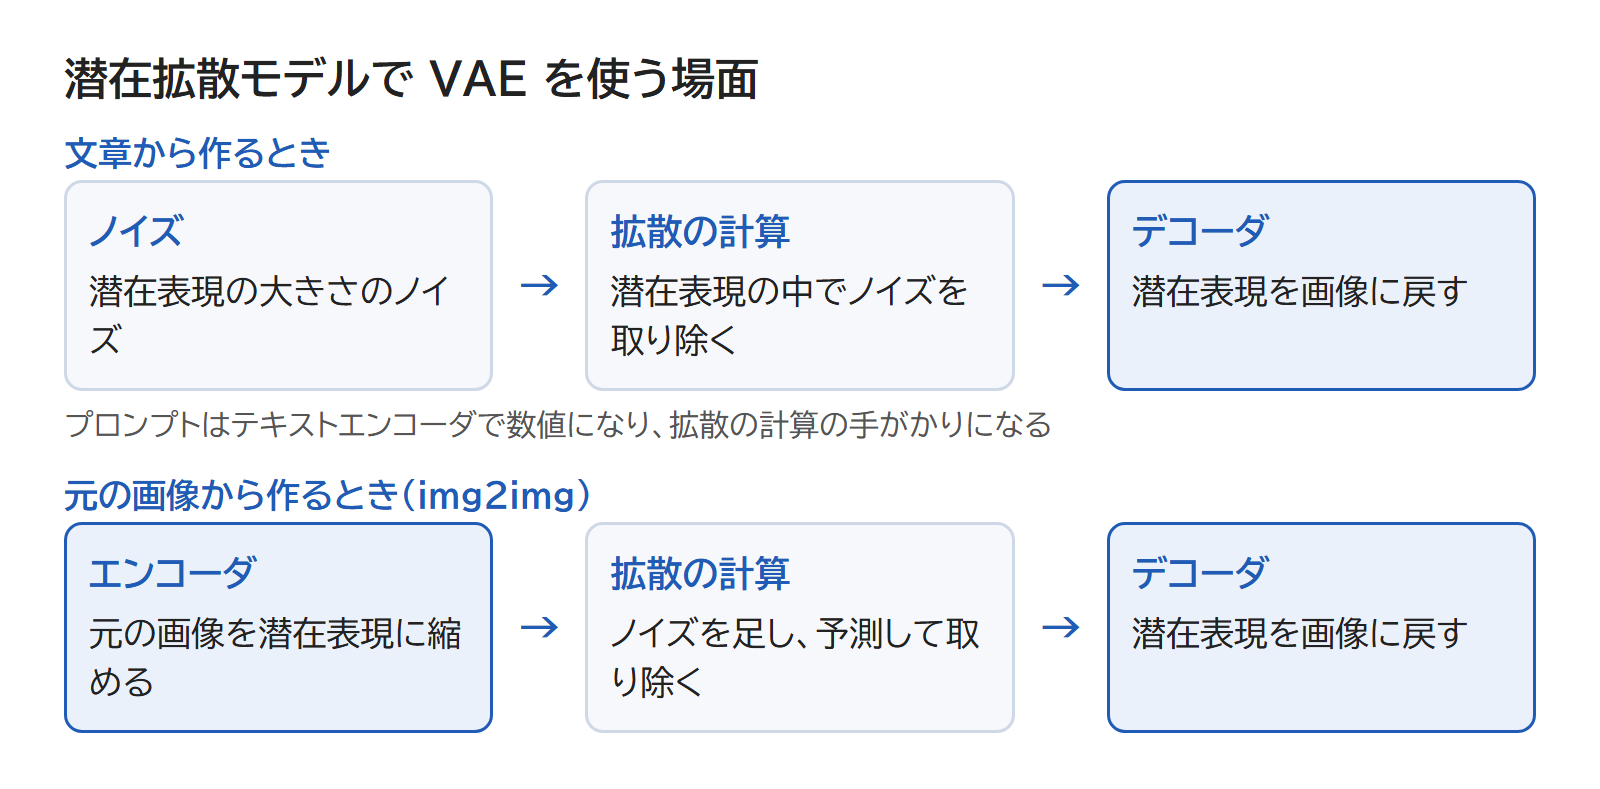
潜在拡散モデルで VAE のどちらの側を使うかは、作り方で変わります。作り方は、次の2つです。
- 文章から作るとき
- 元の画像から作るとき
文章から作るとき
文章(プロンプト)から画像を作るときは、デコーダだけを使います。初めのノイズを潜在表現の大きさで用意し、潜在空間の中でノイズを取り除いてから、デコーダで画像に戻す流れです。
プロンプトは、テキストエンコーダという別の部品で数値になり、ノイズを取り除くときの手がかりになります。VAE のエンコーダが使われるのは、モデルの学習で学習用の画像を縮めるときです。
元の画像から作るとき
文章に加えて画像を渡し、その画像をもとに新しい画像を作る方法が img2img です。img2img では、エンコーダも使います。
元の画像をエンコーダで潜在表現に縮め、そこにノイズを足します。足したノイズを予測して取り除き、最後にデコーダで画像に戻す流れです。
足すノイズが少ないほど元の画像に近く、多いほど元の画像から離れた画像になります。
潜在空間で計算する理由
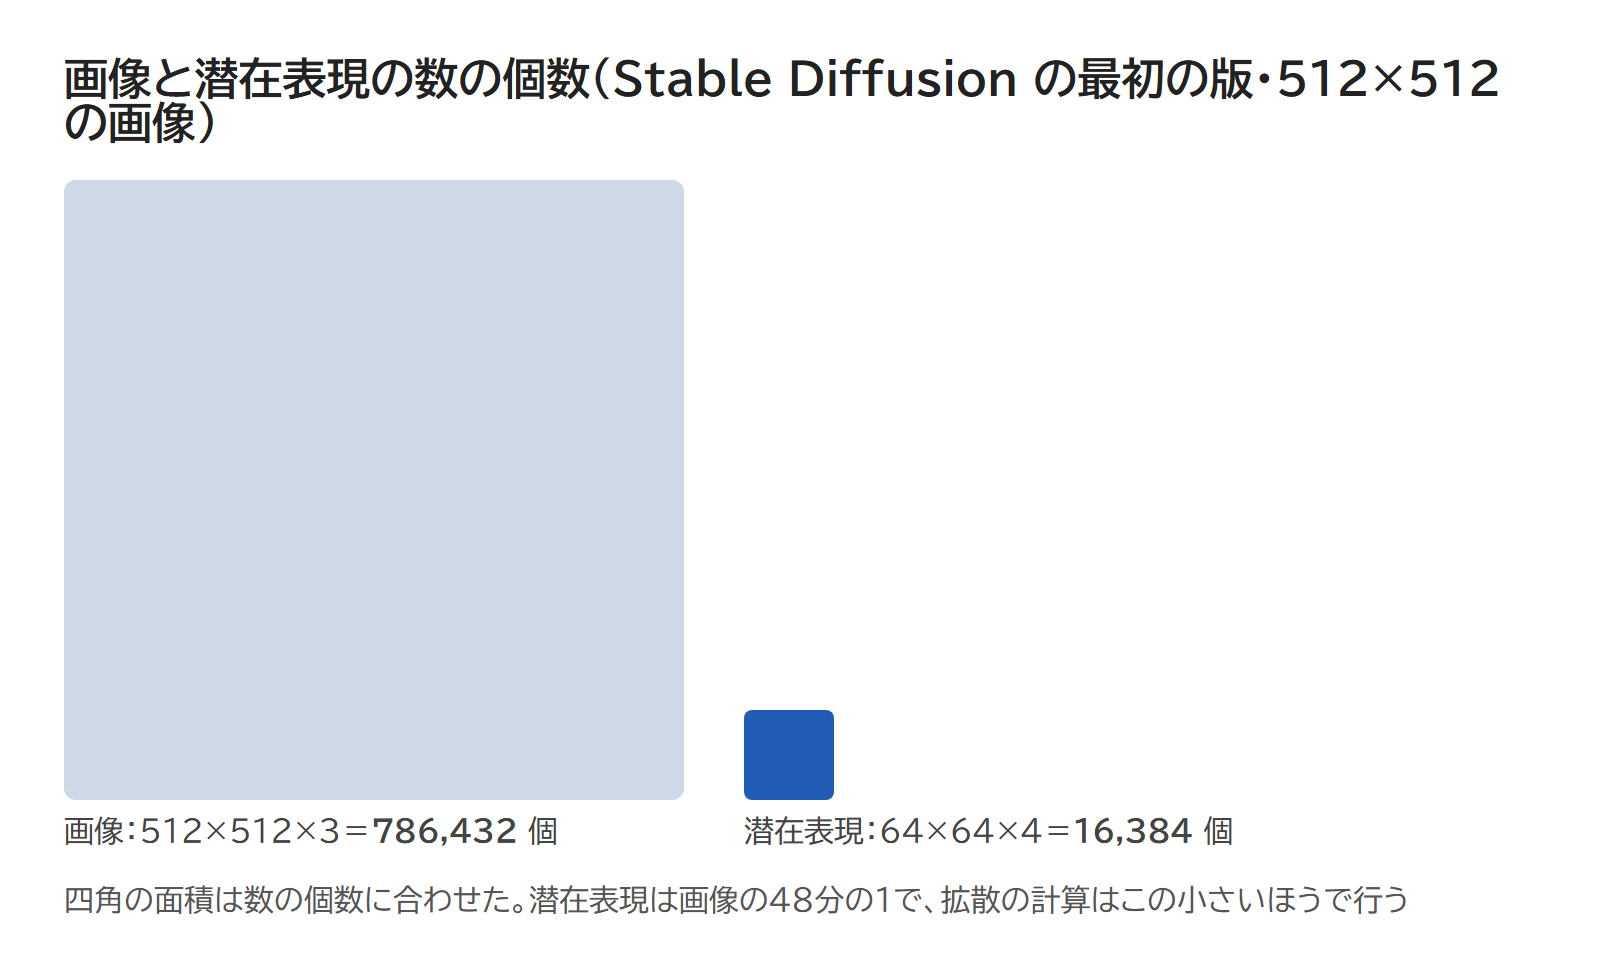
潜在空間で計算するのは、画像のまま計算するより扱う数が少なく、計算が軽いためです。
Stable Diffusion の最初の版(v1。1.5 もこの版)では、512×512 の画像は、色の3つ分で 786,432 個の数を持ちます。
これが 64×64 の4つの並びの潜在表現では 16,384 個で、画像の48分の1です。
拡散の計算は、ノイズを取り除くたびにくり返します。1回の計算に使う数が少なければ、そのたびの計算が軽くなります。
潜在拡散モデルより前の拡散モデルは、画像のまま計算していました。そのため、学習に数百 GPU 日(GPU 1台なら何百日もかかる量)の計算が要り、画像を作るときも重い計算を何回もくり返していたのです。
そこで2021年に、縮めて戻す仕組み(オートエンコーダ)の潜在空間で計算する、潜在拡散モデルが発表されました。
VAEで縮めて戻すと変わる細部
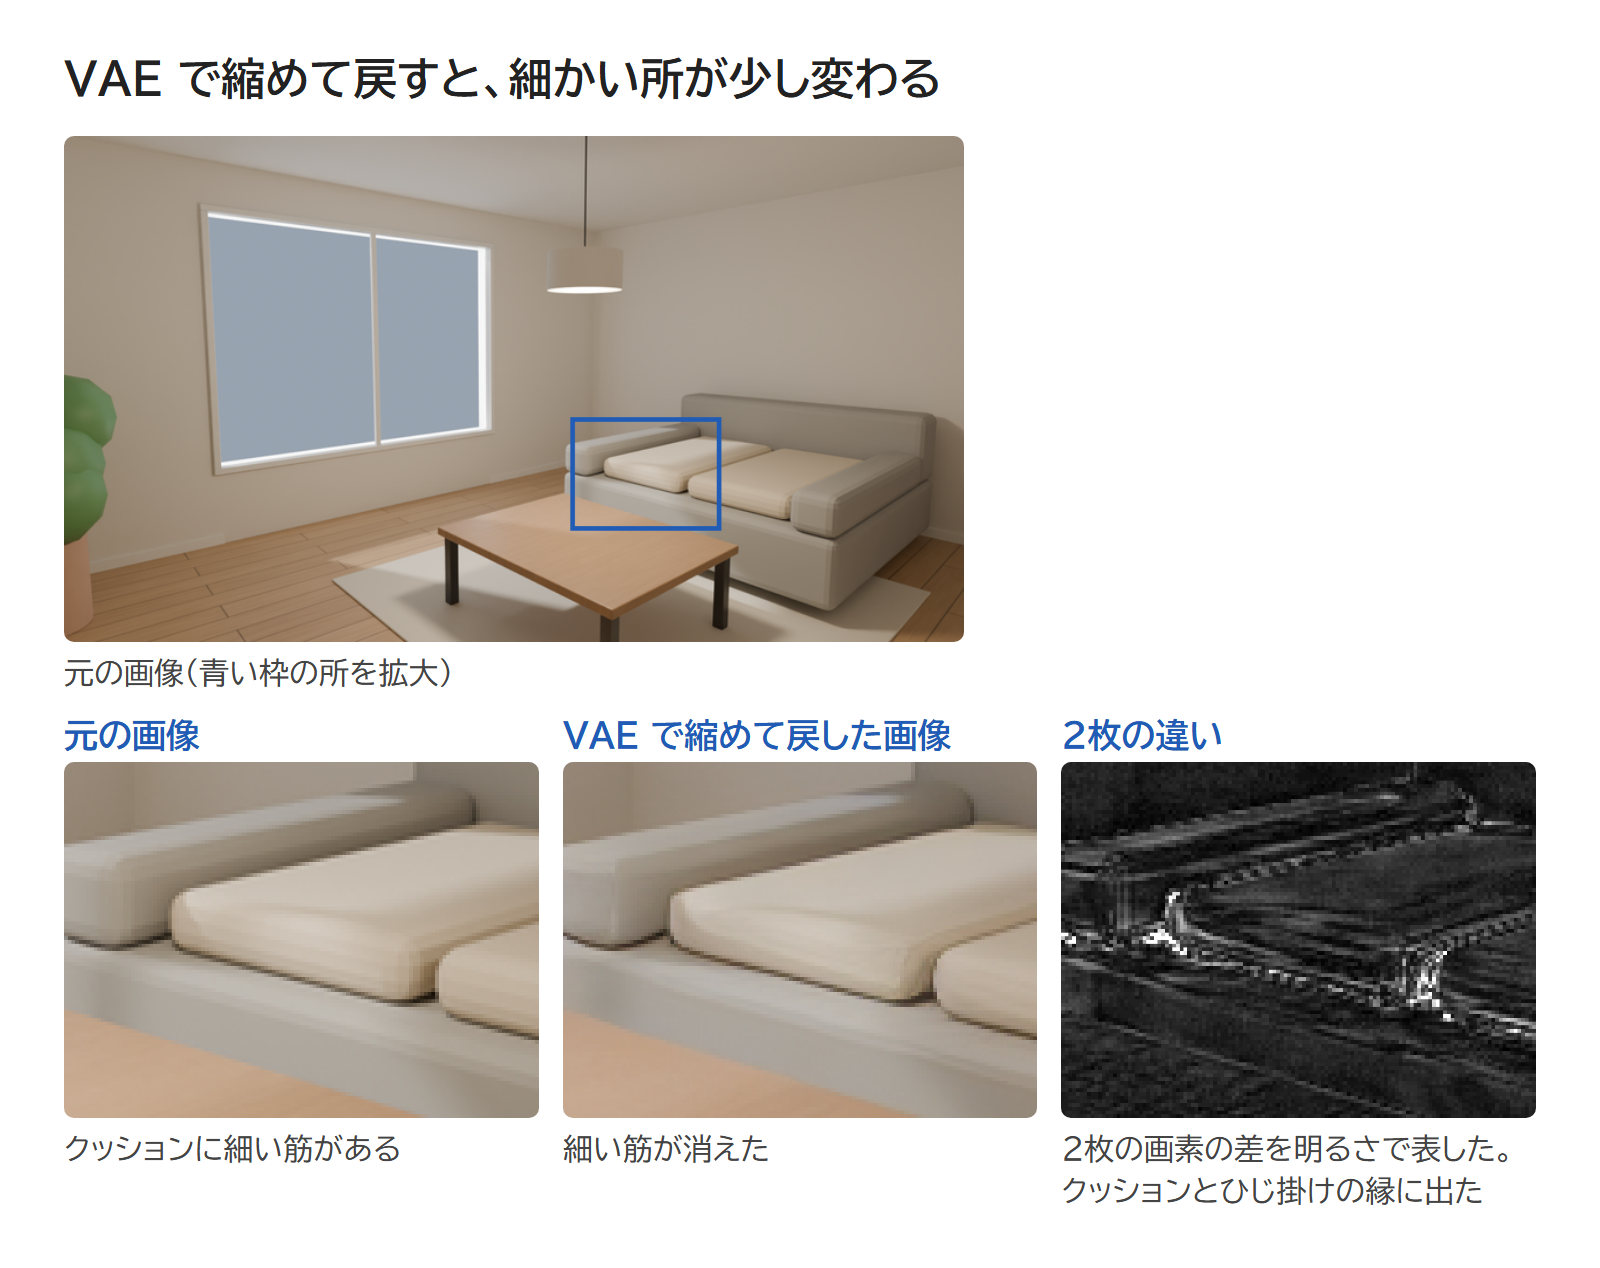
VAE で縮めて戻すと、画像の細かい所が少し変わります。Stable Diffusion 1.5 のモデルカード(開発元の説明)にも、縮めて戻す部分は情報が失われる(lossy)と書かれています。
上の画像は、部屋のレンダリングを VAE で縮め、すぐに戻した結果の一部です。この試しでは、全体はほぼ同じに見えましたが、拡大するとクッションの細い筋が消え、ひじ掛けの端の形も少し変わりました。
縮めて計算し戻す流れで潜在空間とVAEをつかもう
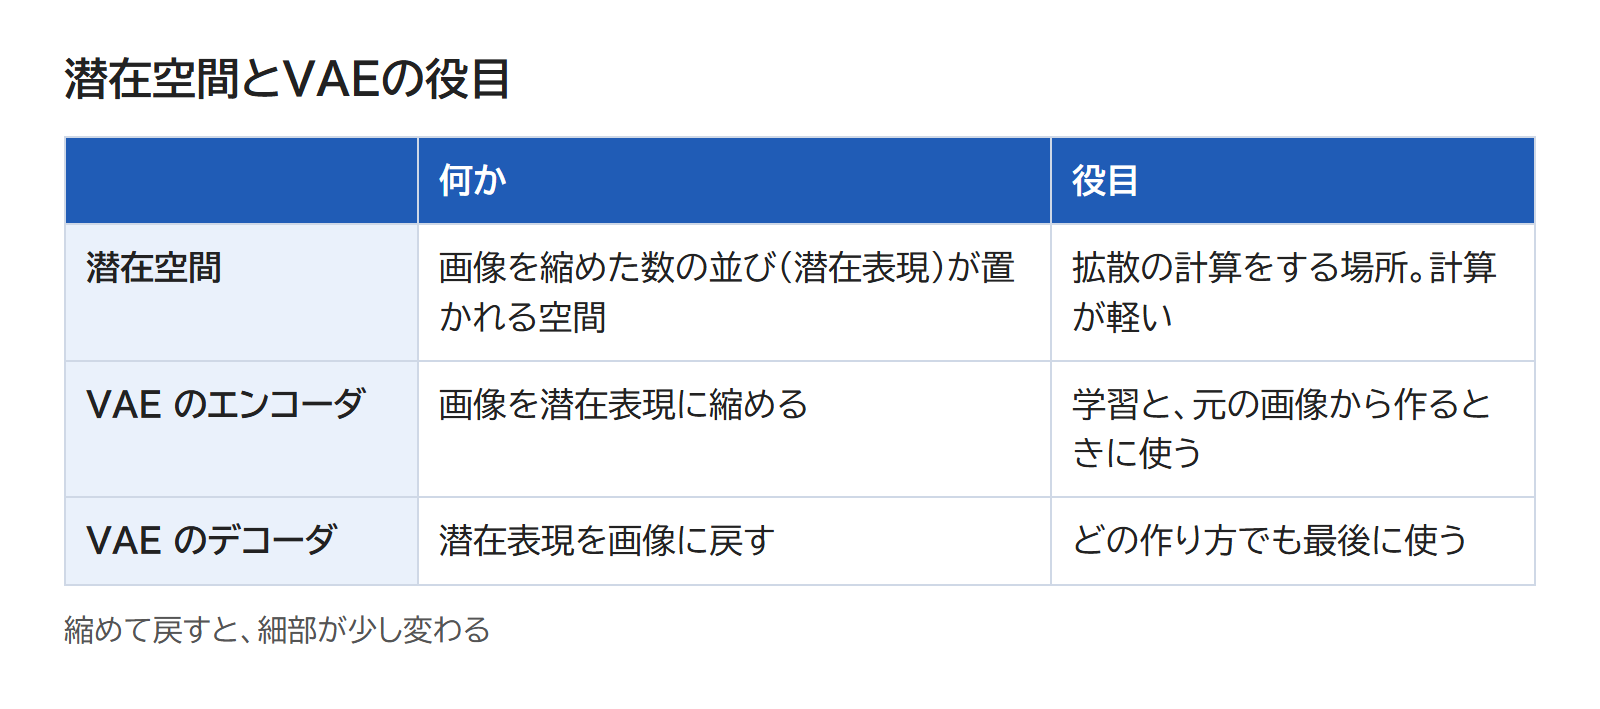
潜在空間は、画像を縮めた数の並び(潜在表現)が置かれる空間で、潜在拡散モデルはその中で拡散の計算をします。VAE の2つの側の役目は、次のとおりです。
- エンコーダ:画像を潜在表現に縮める(学習と、元の画像から作るときに使う)
- デコーダ:潜在表現を画像に戻す(どの作り方でも最後に使う)
ComfyUI では、縮める部品が VAE Encode、戻す部品が VAE Decode という名前です。名前の Encode と Decode で、縮める側か戻す側かを見分けてみてください。
あわせて読みたい
- 「拡散モデル|ノイズを少しずつ取り除いて作る画像」(準備中) — 潜在空間の中でしている、ノイズを取り除く計算を知りたいとき
- 「画像生成AIの歴史|GAN・VAE・拡散モデル」(準備中) — VAE と潜在拡散モデルが出てきた年と順を知りたいとき
- 「AI建築パースのプロンプトの書き方|建物・素材・光・視点とテキストエンコーダの仕組み」(準備中) — プロンプトが数値になって計算に伝わる仕組みを知りたいとき
- 「img2imgとノイズ除去強度|元の画像にどれだけ似せるか」(準備中) — エンコーダで縮めた元の画像から作る方法を知りたいとき
会員登録(無料)
記事やテーマのお気に入り・学習履歴・フォローが使えます。
この記事について
PERSC編集部が、建築の制作に関わる知識を実務目線で整理しています。内容は公開・更新日時点の情報にもとづきます。誤りや古い情報にお気づきの場合はお問い合わせよりご連絡ください。