画像編集モデル|指示文と元の画像から直した画像を作る仕組み
- 画像編集モデルって、何をしているの?
- 「床を木にして」のように、文でパースを直したい
- 指示文で直したとき、ほかの所が変わるかを知りたい
画像生成AIには、直したい所を文で頼むだけで画像を直せるモデルがあります。しかし、頼んでいない所まで変わることもあるので、直したあとは元の画像と見比べるのが前提です。
この記事では、画像編集モデルが指示文と元の画像から直した画像を作る仕組みを解説します。直していない所の変わり方と続けて直したときのずれは作例で、モデルごとのライセンスは表で分かります。
画像編集モデルは、元の画像と、何をどう直すかを書いた文の2つから、直した画像を作るモデルです。
画像編集モデルとは
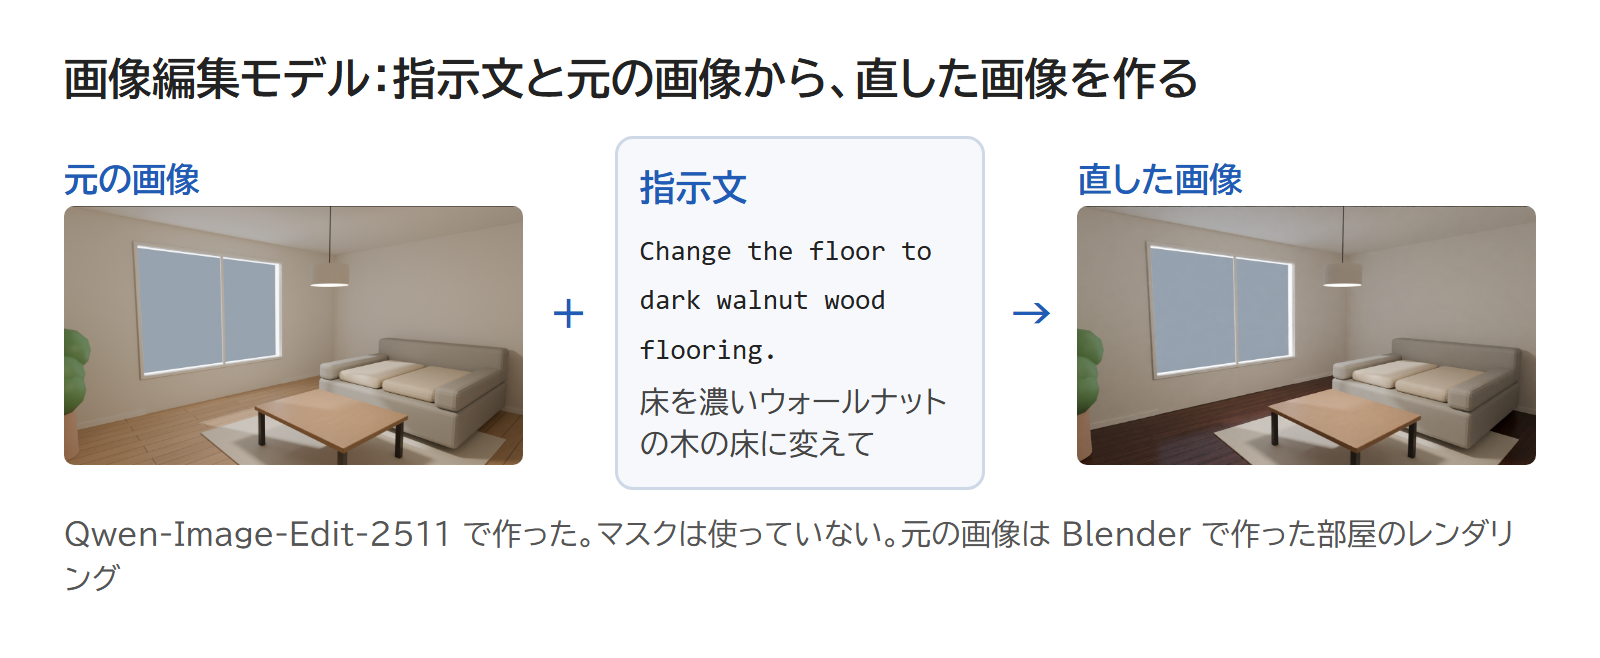
画像編集モデルとは、直したい内容を書いた指示文と元の画像から、直した画像を作るモデルです。指示文は、プロンプト(画像生成AIに入れる文章)のうち、何をどう直すかを書いたものを指します。
作例では、Qwen の開発チームの画像編集モデル Qwen-Image-Edit-2511 を自分のパソコンで動かし、部屋のレンダリングを直しました。
頼んだのは「Change the floor to dark walnut wood flooring.(床を濃いウォールナットの木の床に変えて)」だけです。
床が濃い木の床になり、敷物・テーブル・ソファ・窓は元のままに見えました。直す所を塗って決めるマスクは、使っていません。
img2img(元の画像にノイズを足して作り直す方法)やインペイント(マスクで決めた所を作り直す方法)と違い、マスクを描かずに、文だけで直す所を伝えます。
どこをどれだけ直すかは、モデルが指示文から決めることになります。
指示どおりに直すことを学ぶ仕組み
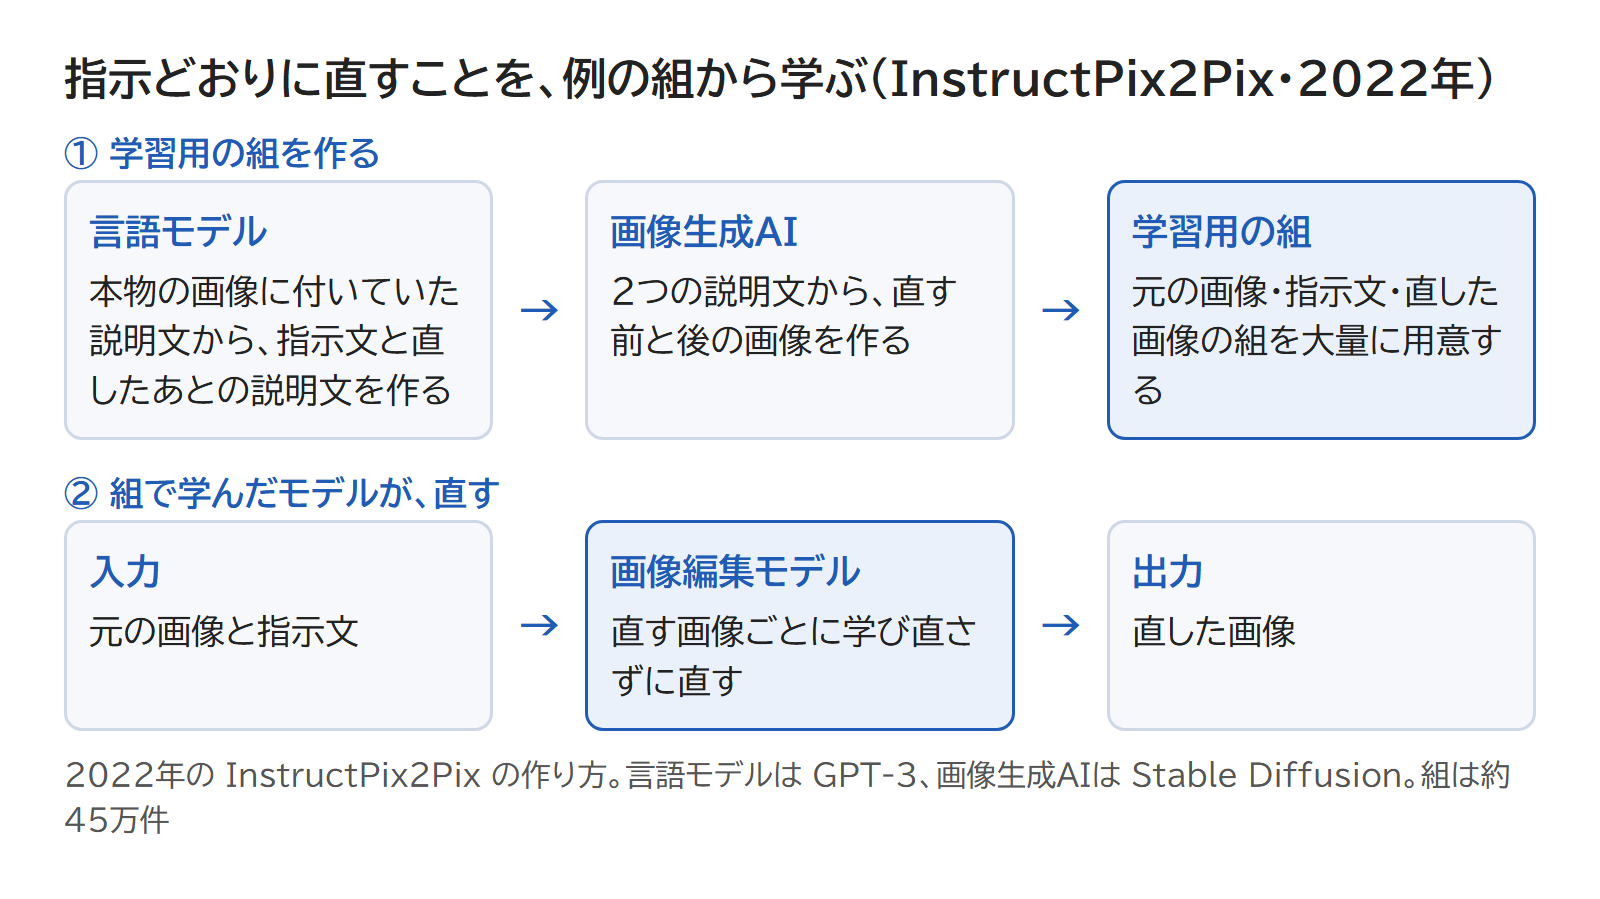
画像編集モデルの学び方の1つは、元の画像・指示文・直した画像の組を大量に学ぶ方法です。2022年の研究のモデル InstructPix2Pix は、この組を、学習済みの2つのAIで作りました。
1つは文章を作る言語モデル(GPT-3)で、本物の画像に付いていた説明文(画像そのものは使わない)から、指示文と直したあとの説明文を作ります。
もう1つは画像生成AI(Stable Diffusion)で、直す前と後の説明文から2枚の画像を作ります。
こうして作った組は、約45万件です。論文によると、AI が作った組で学んだモデルが、本物の画像と人が書いた指示文にも使えました。
直す画像ごとにモデルを学び直さずに使えるので、直すのにかかる時間は数秒だとしています。
直していない所も変わることがある
画像編集モデルで一部だけを直させても、ほかの所まで変わることがあるので注意が要ります。
たとえば ChatGPT の画像生成を作る OpenAI も、2025年3月の発表で、一部を直す頼みでは頼んでいない所まで変わることがあると書いています。
Qwen-Image-Edit の開発元の説明にあるのは、見た目の直しと意味の直しの2つです。物を足す・消す・変える見た目の直しは、ほかの所をまったく変えないことを求める直しです。
向きや画風を変える意味の直しは、画素が全体に変わってよいが、写っている物が何かは保つ直しとされています。
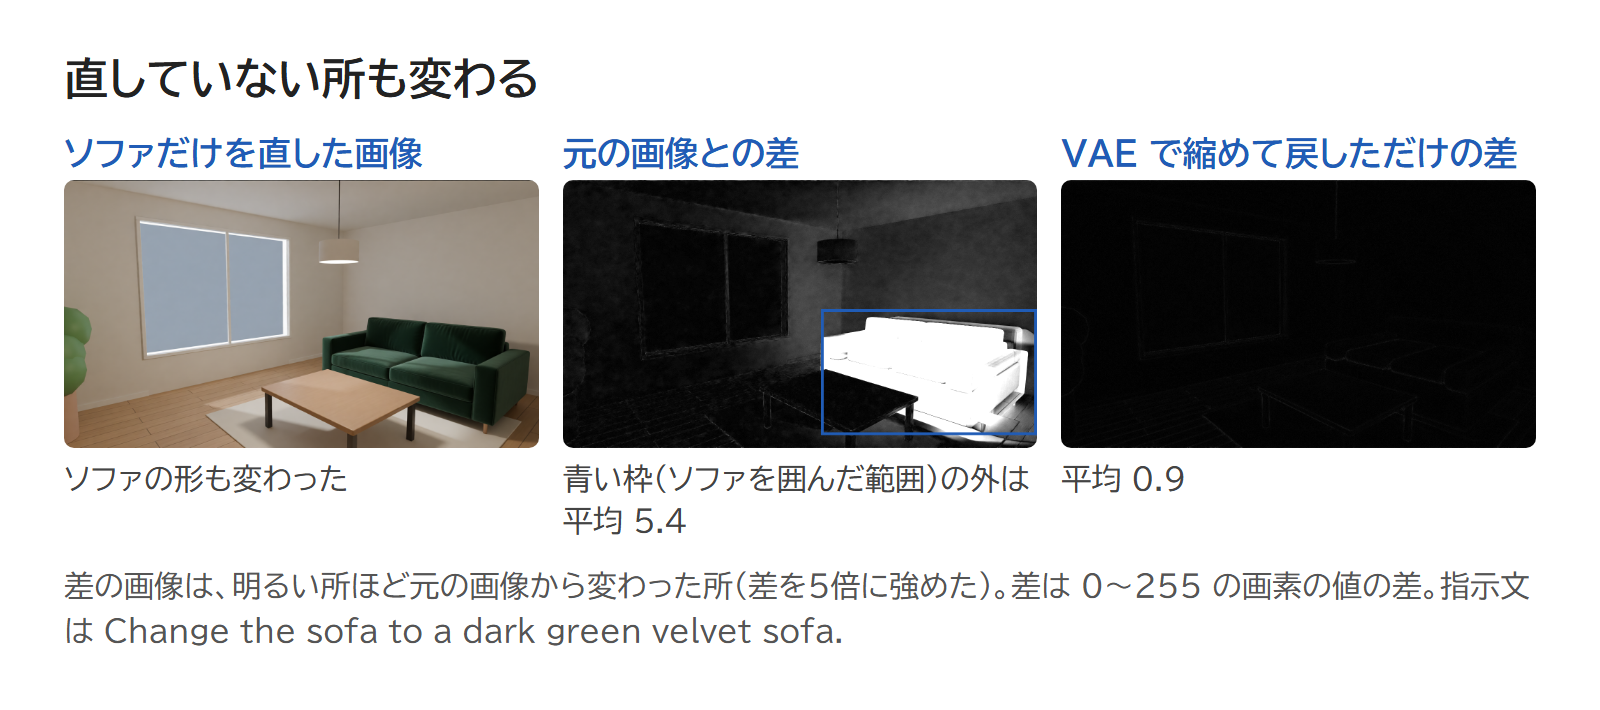
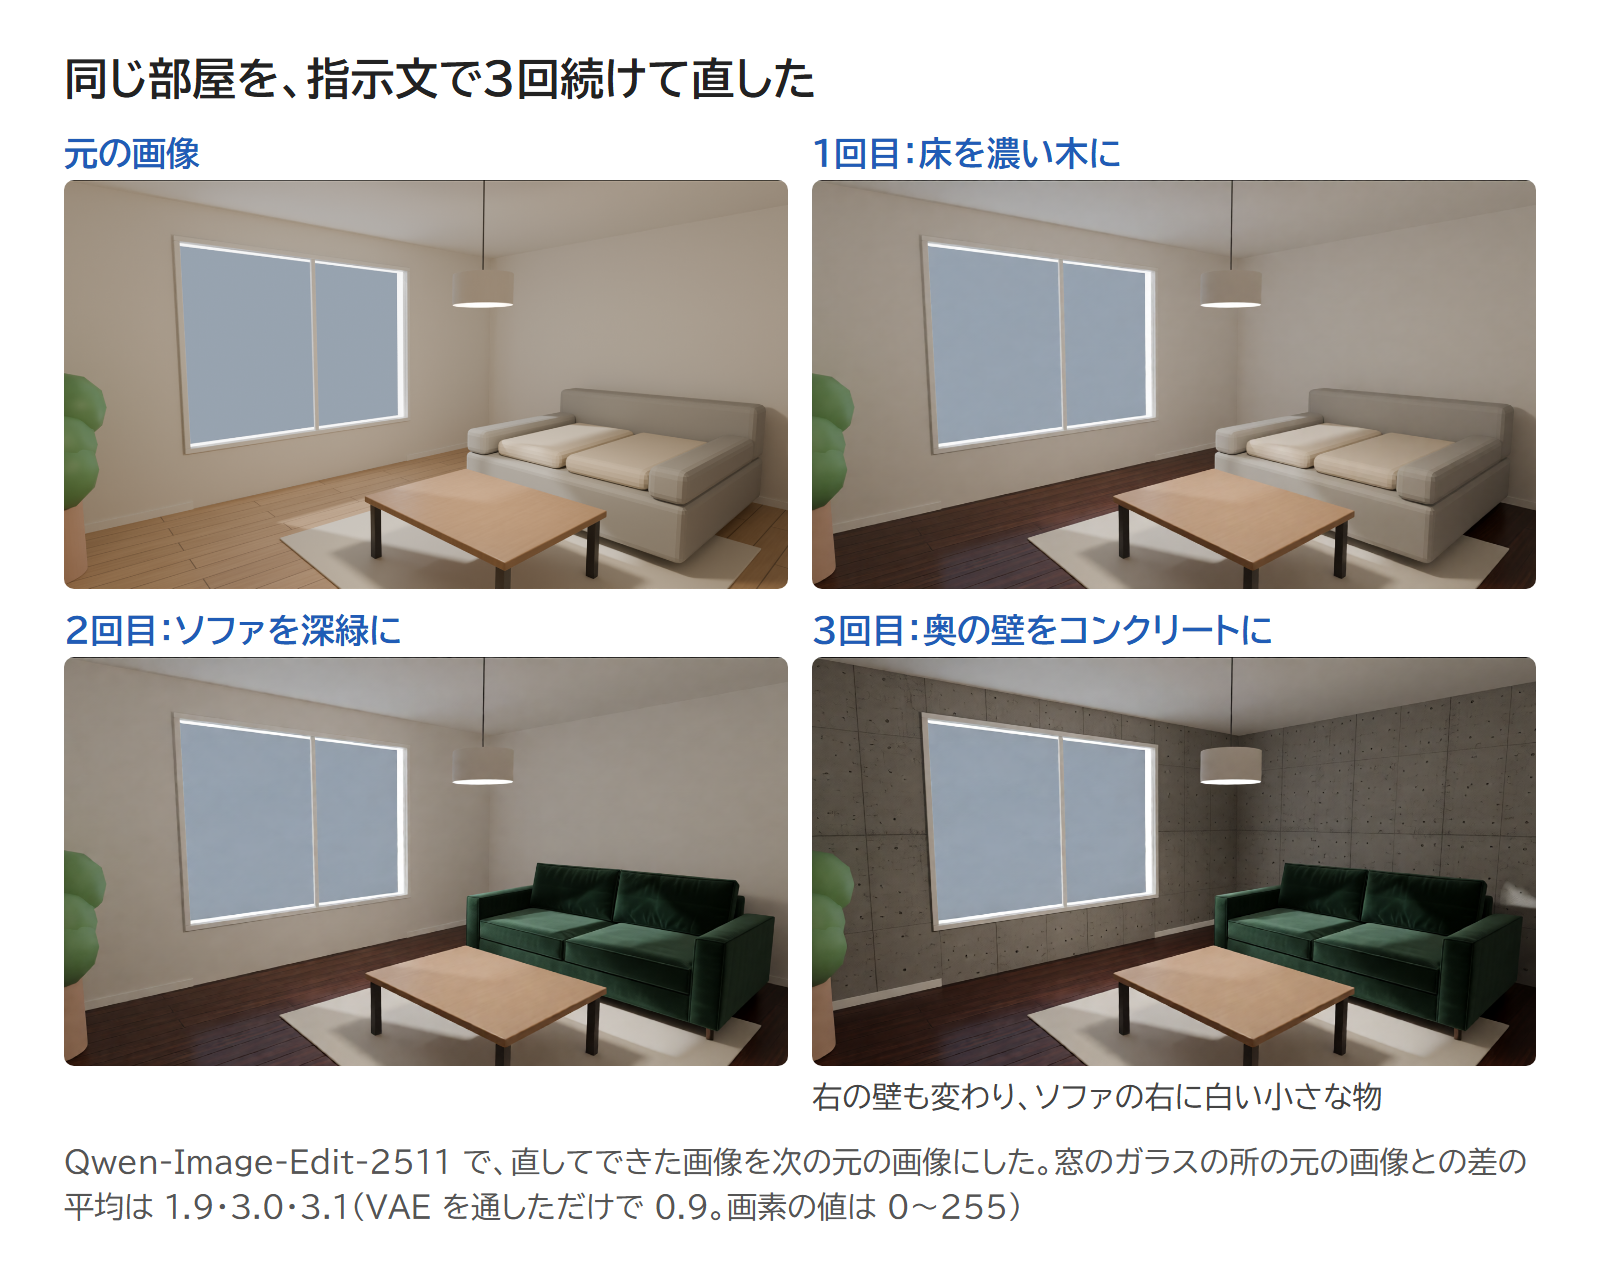
作例では、ソファだけを直すつもりで、元の画像に「Change the sofa to a dark green velvet sofa.(ソファを深緑のベルベットのソファに変えて)」と頼みました。
ソファの色や生地を変えるのは、見た目の直しにあたります。
ソファは深緑になり、指示文に書いていない形も、別のソファに変わりました。
ソファを四角く囲んだ範囲の外でも、画素が変わっています。元の画像との差を測ると、平均 5.4(画素の値は 0〜255)でした。
画像編集モデルの中では、画像を VAE(画像を小さな数の並びに縮めて戻す部品)で縮めて計算します。縮めて戻しただけの差は 0.9 で、それより大きな差でした。
大きな差の多くは、範囲の境目の近くに集まっています。
続けて直してもずれにくいモデル
画像編集モデルには、続けて直しても元の画像からずれにくくした、と開発元が説明するモデルもあります。
Black Forest Labs の FLUX.1 Kontext(2025年)は、画像を作ることも直すこともできるモデルです。
開発元の説明によれば、物や人物を同じ見た目で保つ力が上がり、何度も続けて直す使い方でも崩れにくいとのことです。
Qwen-Image-Edit-2511 も、開発元は前の版から画像のずれを抑えたと説明しています。
作例で試したのは、Qwen-Image-Edit-2511 で、床・ソファ・壁の順に、直してできた画像を次の元の画像にして3回続けて直す使い方です。
どの指示でも直していない窓のガラスの所で、最初の元の画像との差を測りました。差の平均は 1.9・3.0・3.1 と、回ごとに少しずつ増えています(VAE で縮めて戻しただけなら 0.9)。
一方、3回目の「奥の壁をコンクリートに」では、右の壁までコンクリートになり、ソファの右に白い小さな物が現れました。
画像編集モデルのライセンス
ここまでの作例のように、モデルのファイルを自分のパソコンに置いて動かすときは、モデルごとにライセンス(使ってよい範囲を決めた条件)が違うことに気をつけます。
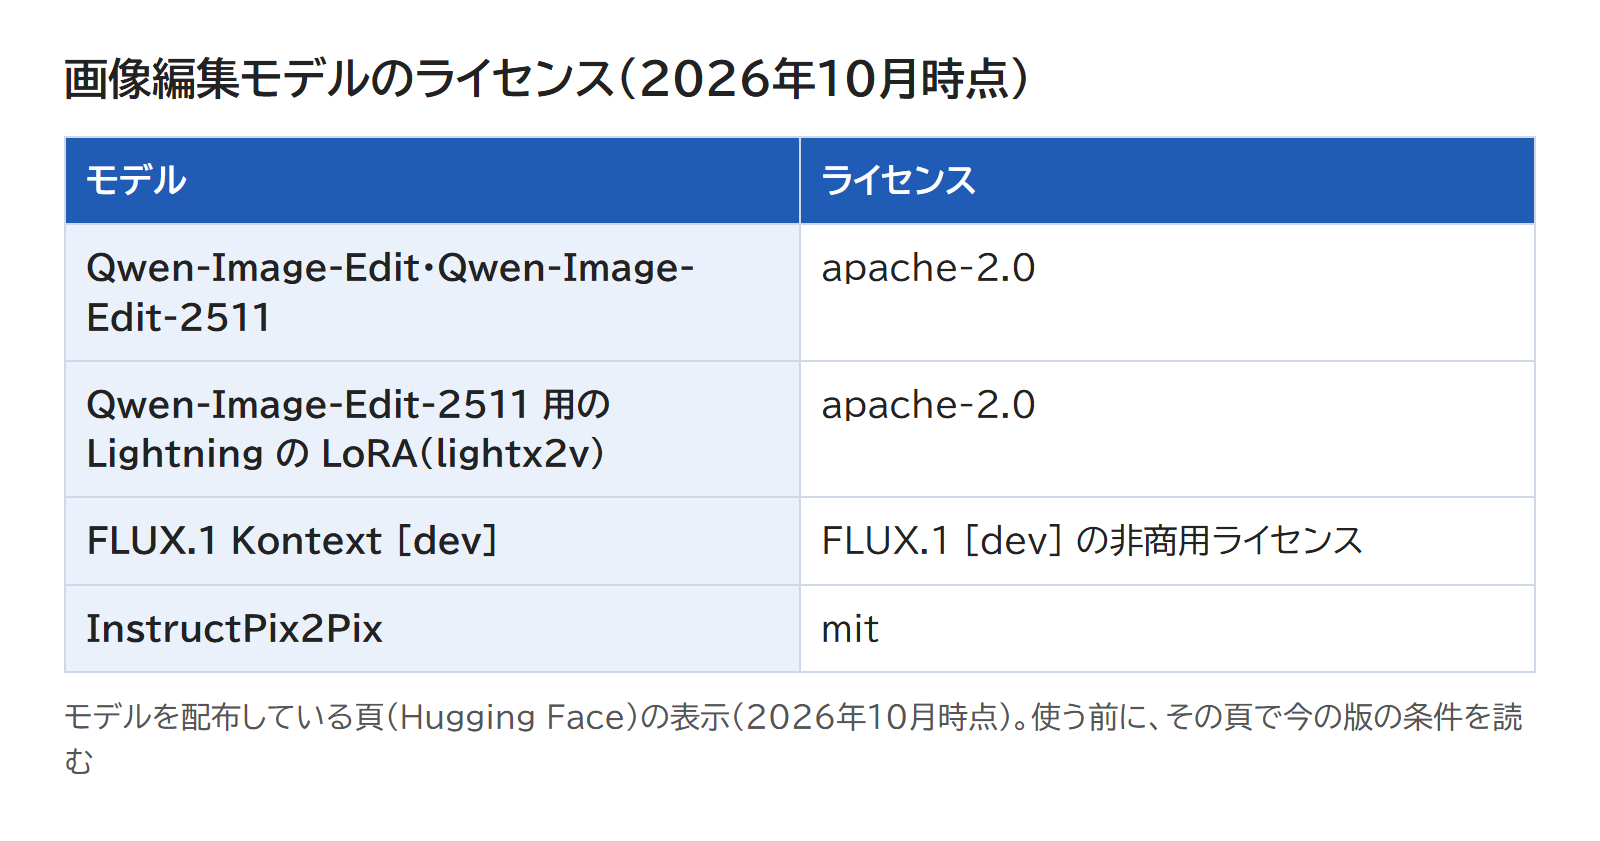
2026年10月時点の、モデルを配布している頁の表示を並べると、次の表のとおりです。
| モデル | ライセンス |
|---|---|
| Qwen-Image-Edit・Qwen-Image-Edit-2511 | apache-2.0 |
| Qwen-Image-Edit-2511 用の Lightning の LoRA(lightx2v) | apache-2.0 |
| FLUX.1 Kontext [dev] | FLUX.1 [dev] の非商用ライセンス |
| InstructPix2Pix | mit |
Lightning の LoRA は、計算の段(ステップ)を40回から4回に減らすために、元のモデルに足して使う小さなファイルです。作例もこれを足して、4回で直しました。
FLUX.1 Kontext [dev] は非商用のライセンスです。ライセンスは変わることがあるので、使う前に、そのモデルを配布している頁で今の版の条件を読んでください。
指示文で直した画像を、元の画像と見比べよう
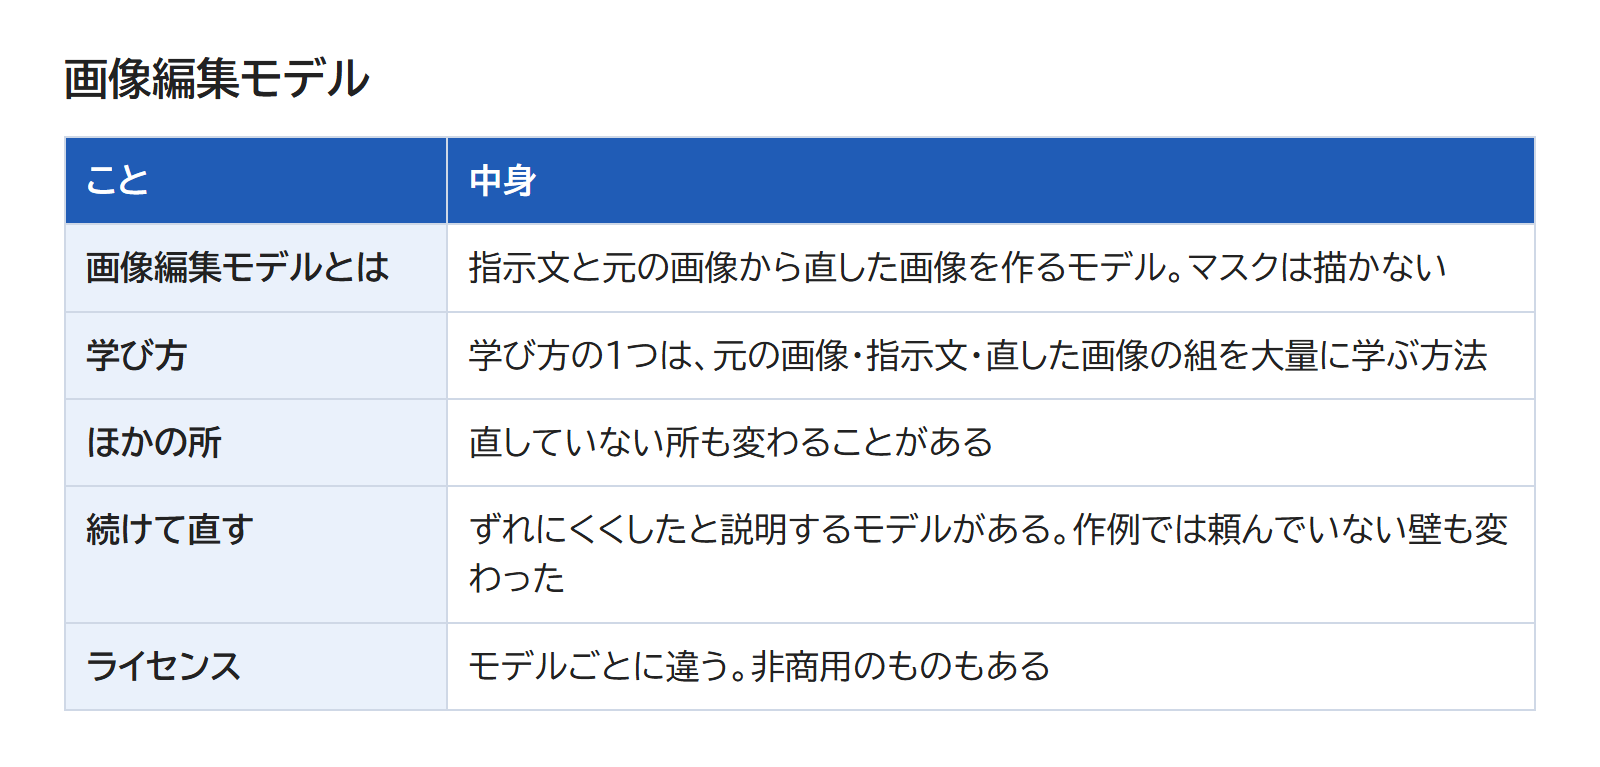
画像編集モデルは、指示文と元の画像から、直した画像を作るモデルです。この記事で解説したことは、次の5つです。
- マスクを描かずに、指示文で直す所を伝える
- 学び方の1つは、元の画像・指示文・直した画像の組を大量に学ぶ方法
- 直していない所も変わることがある
- 続けて直してもずれにくくしたと説明するモデルがあるが、作例では頼んでいない壁も変わった
- ライセンスはモデルごとに違い、非商用のものもある
パースを指示文で直したら、元の画像と並べて、頼んでいない所が変わっていないかを確かめてみてください。
あわせて読みたい
- img2imgとノイズ除去強度|元の画像にどれだけ似せるか — 元の画像にノイズを足して作り直す方法を知りたいとき
- 画像生成AIで建築の画像に起きる破綻|直線のゆがみ・形の食い違い・文字 — 一部を直したときにほかが変わる崩れを、くわしく知りたいとき
- 「ComfyUIのQwen-Image-Editでの編集|元の画像と指示文での修正」(準備中) — ComfyUI で Qwen-Image-Edit を使って画像を直す操作を知りたいとき
- ComfyUIのマテリアルと家具の差し替え|指示文の編集・インペイント — パースの床材や家具を、指示文で差し替える操作を知りたいとき
- 「ChatGPTの画像の編集|エディターで一部を直す・スマートフォンでの編集」(準備中) — ChatGPT で作った画像の一部を直す操作を知りたいとき
会員登録(無料)
記事やテーマのお気に入り・学習履歴・フォローが使えます。
この記事について
PERSC編集部が、建築の制作に関わる知識を実務目線で整理しています。内容は公開・更新日時点の情報にもとづきます。誤りや古い情報にお気づきの場合はお問い合わせよりご連絡ください。