画像生成AIの学習データ|何を学んだかで決まる作れる画像
- 画像生成AIの学習データって何?
- 画像生成AIは、どんな画像から学んでいるのか気になる
- 学習データで、作れる画像がどう変わるのかを知りたい
画像生成AIは、学習した大量の画像をもとに新しい画像を作ります。しかし、何を学んだかは使っているときには見えないので、思ったとおりの画像が出ない理由がつかみにくいものです。
この記事では、画像生成AIの学習データとは何かと、学習データで何が作りやすくなるかを解説します。プロンプト(画像を作るときに入れる文章)の英語と日本語の作り比べで、偏りの出方も分かります。
学習データは画像と説明文の組の集まりで、作りやすい物と作りにくい物は、その中身しだいです。
画像生成AIの学習データとは
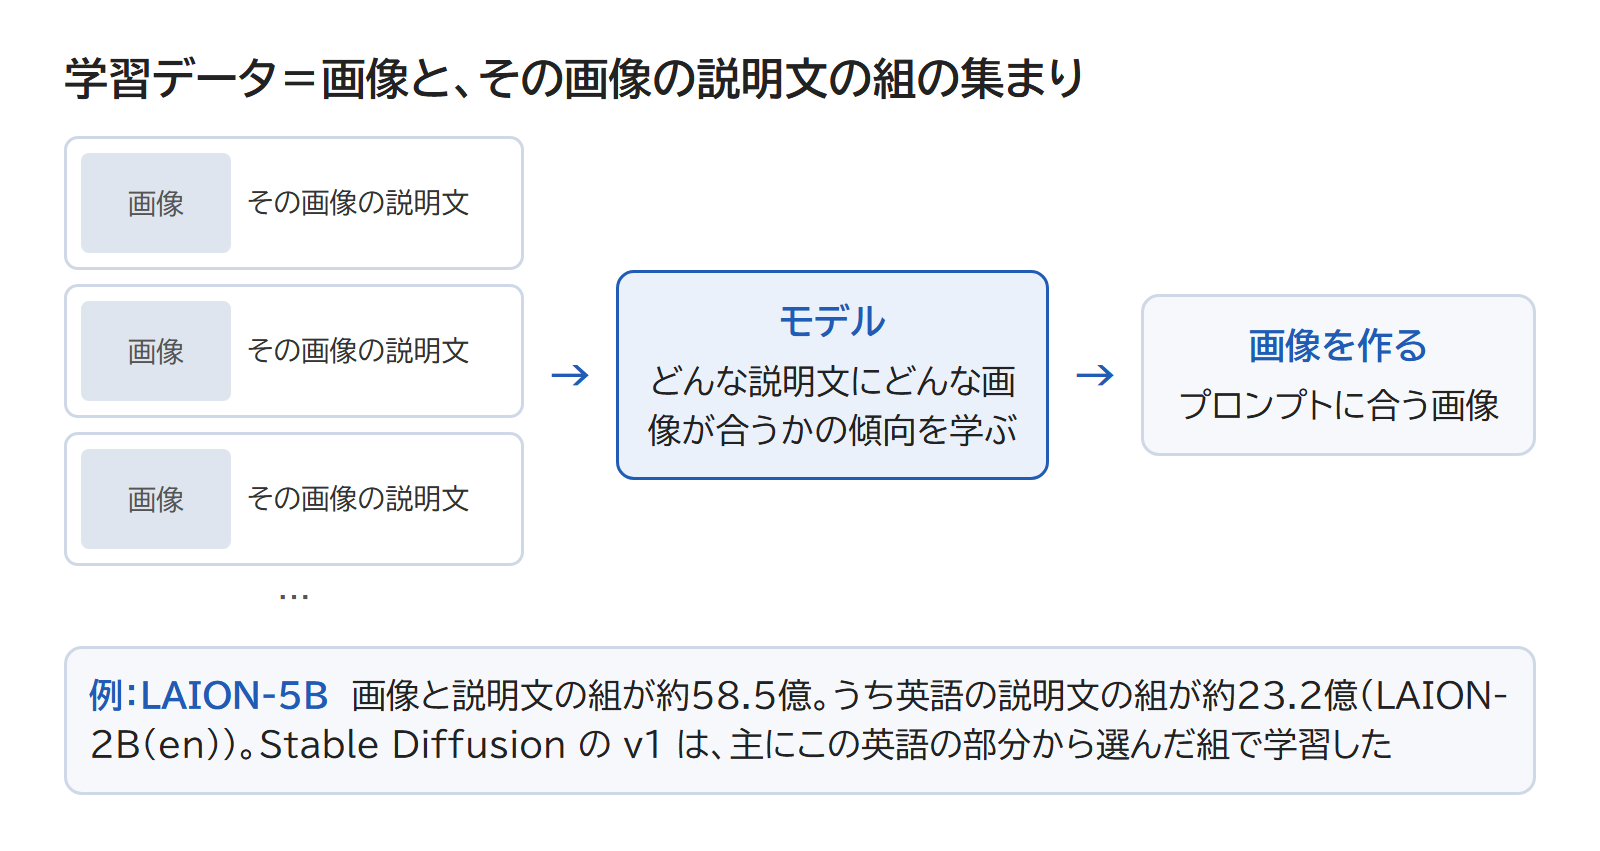
画像生成AIの学習データとは、画像を作る仕組み(モデル)が学ぶための、画像とその画像を説明する文章(説明文)の組を集めたものです。
学習データの別の呼び名には、解説の記事で使われるデータセットや教師データがあります。
モデルは、この組から、どんな説明文にどんな画像が合うかの傾向を学びます。その結果できるのが、プロンプトに書いた文章から、それに合う画像を作る力です。
学習データの組は、とても多く集められます。たとえば公開されている学習データの LAION-5B は、画像と説明文の組を約58.5億組集めたもので、うち約23.2億組が英語の説明文の組です。
画像生成AIのモデルの1つの Stable Diffusion は、v1 の版を、主にこの英語の部分(LAION-2B(en))から選んだ組で学習しました。
学習データに少ない物や画風は作りにくい
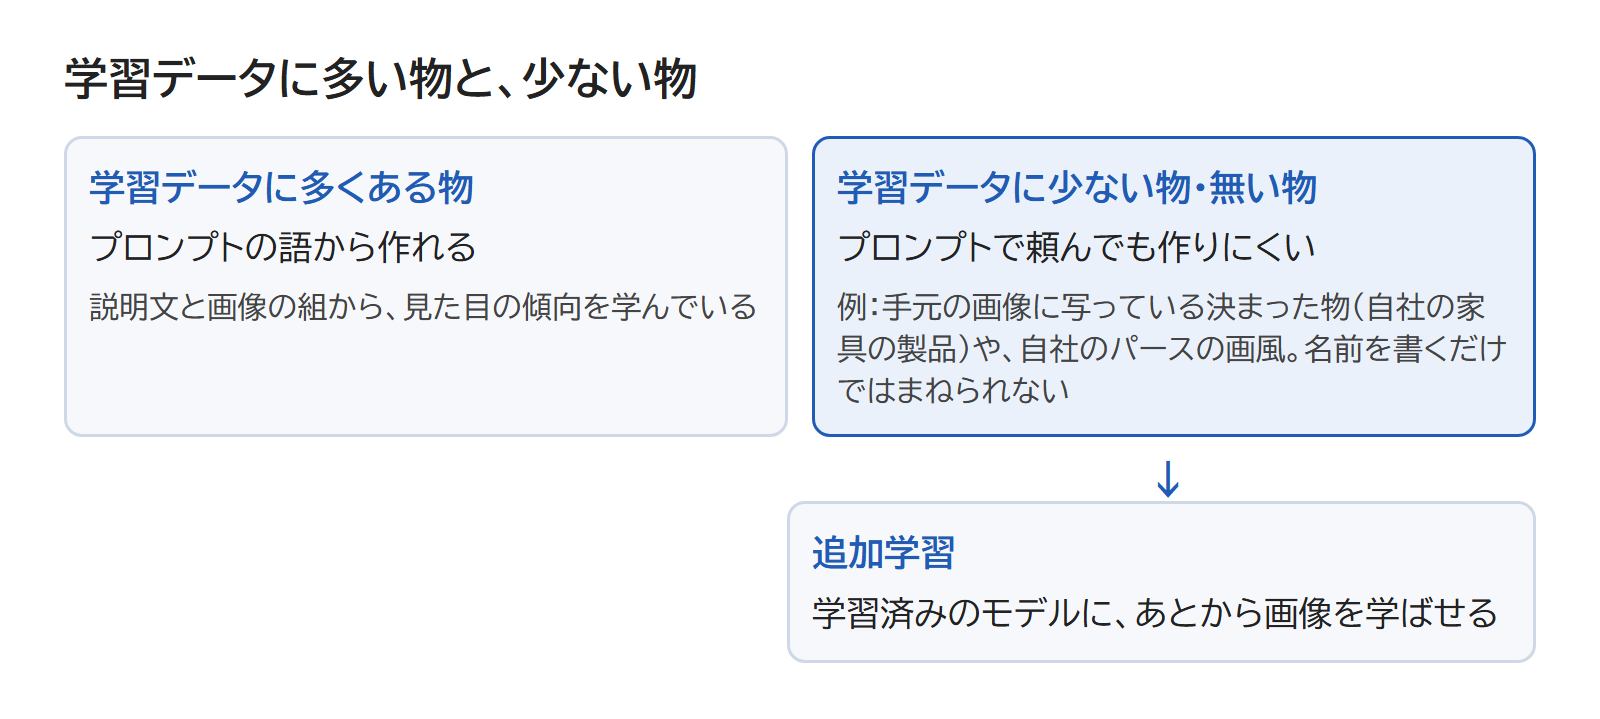
学習データから傾向を学ぶので、学習データに少ない物や画風は、プロンプトで頼んでも作りにくくなります。あまり学んでいない物の見た目は、文章だけでは引き出しにくいためです。
特に、手元の画像に写っている決まった物の見た目は、学習済みのモデルではまねられません。自社の家具の製品や、自社のパースの画風を、プロンプトに名前を書くだけで再現することは難しいわけです。
そのため、学習済みのモデルにあとから画像を学ばせる、追加学習という方法があります。
学習データの偏りが画像に出る
学習データの言語や文化に偏りがあると、その偏りは作られる画像に出ます。Stable Diffusion の v1 では、モデルの公開元がその限界を書いています。
Stable Diffusion の v1 は、主に英語の説明文の組で学習しました。そのため、英語以外のプロンプトでは、英語のプロンプトより思ったとおりに作る力が大きく劣ります。
また、英語以外の言語を使う人々や文化の画像と説明文は、十分に入っていない可能性が高いとされています。何も指定しないと、白人や西洋の文化が出やすいというわけです。
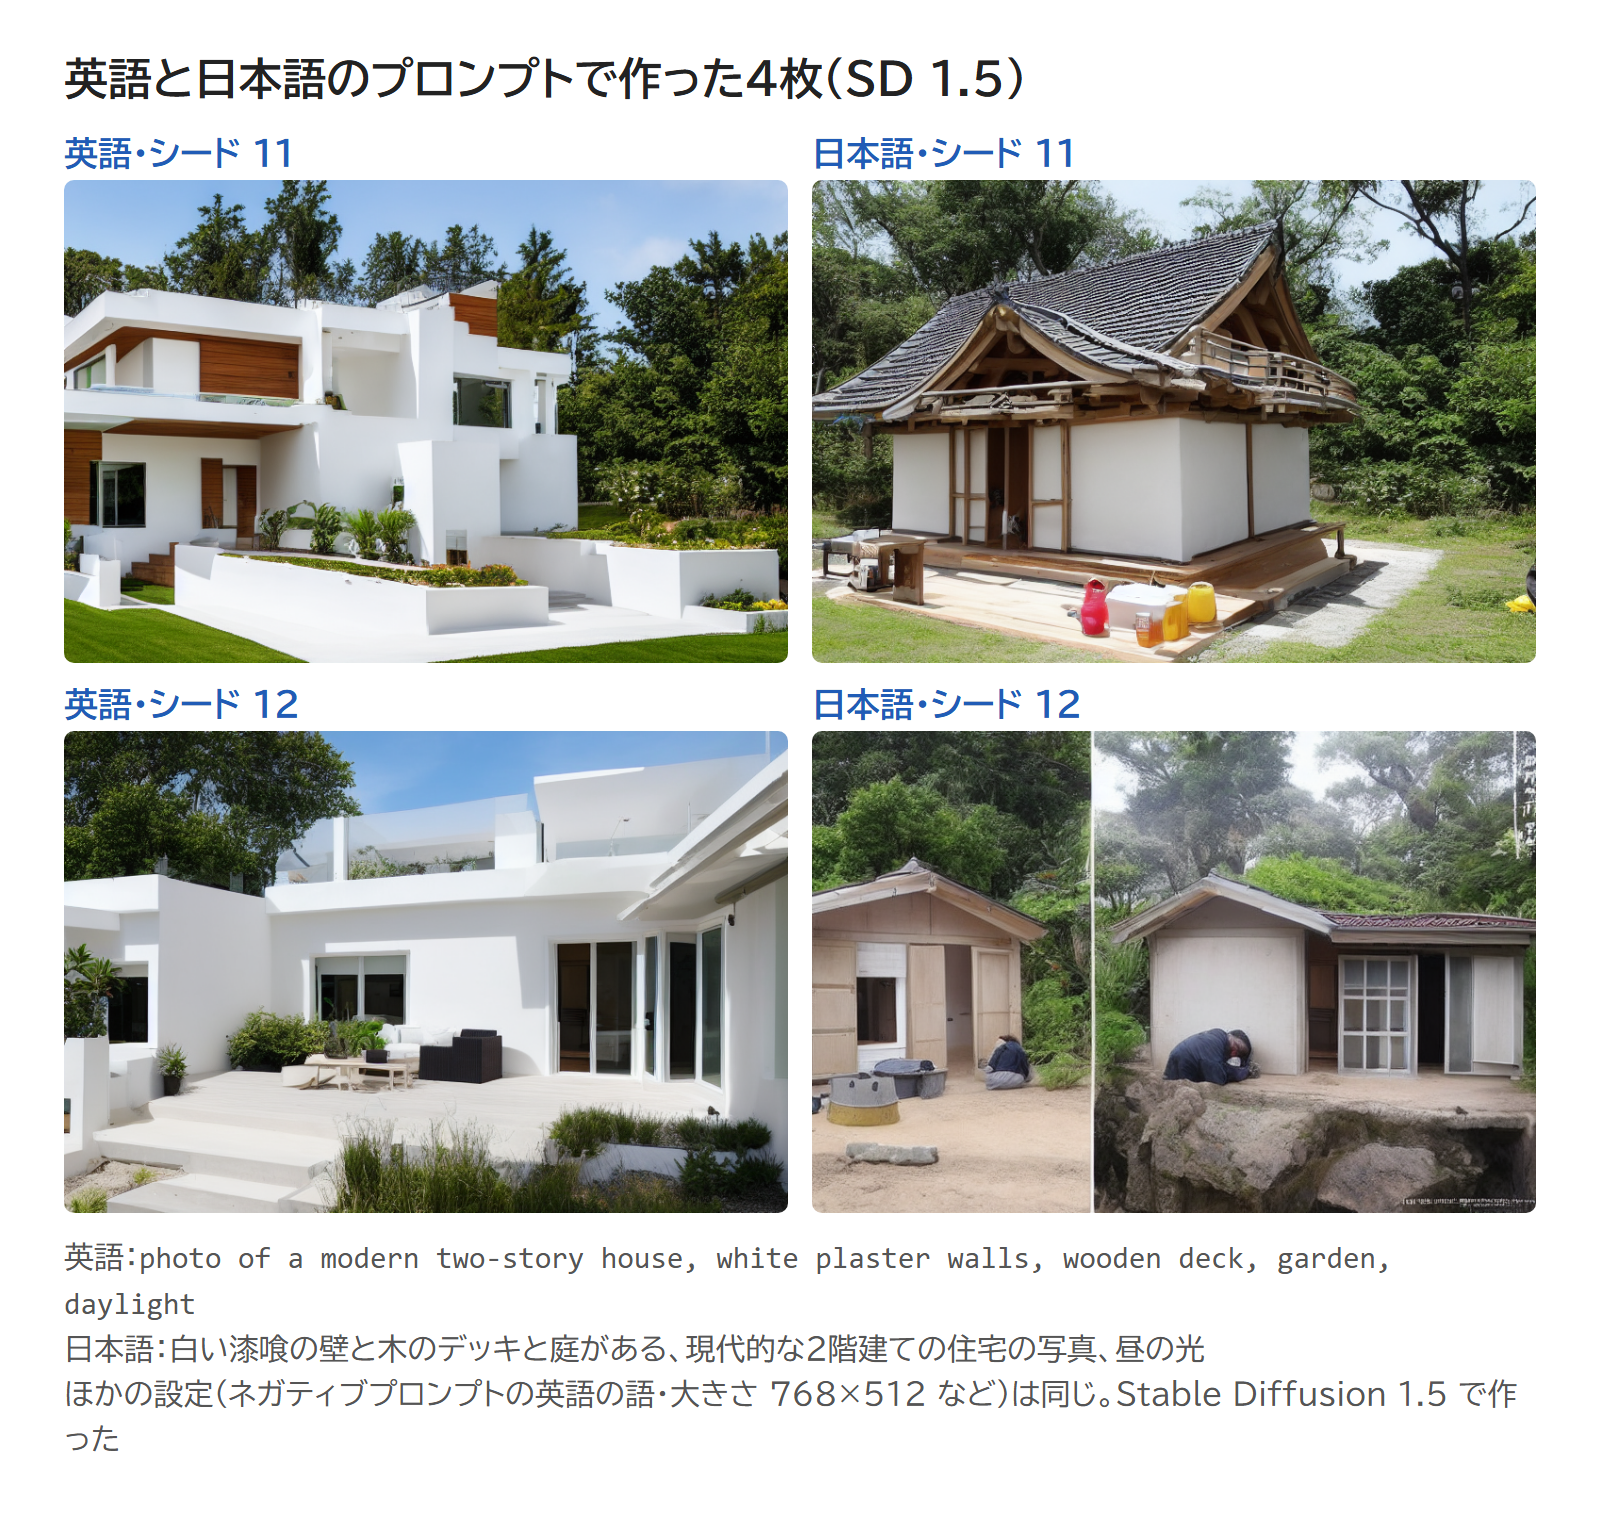
上の画像は、このうち言語の偏りを試した例です。Stable Diffusion 1.5(v1 の版の1つ)で、同じ中身のプロンプトを英語と日本語で書き、ほかの設定をそろえて作りました。
使ったシード(初めのノイズ=でたらめな点のざらつきを決める数)は、11 と 12 の2つです。
ネガティブプロンプト(画像に出したくないものを書く欄)は、どちらも英語の「blurry, lowres, deformed」です。
この試しでは、英語のプロンプトからは、白い壁の現代的な2階建ての家ができました。
日本語のプロンプトからは、2階建てにも現代的な家にもならず、瓦のような屋根の木造の建物(11)や、画面が左右2つに分かれた小屋(12)ができました。白い壁だけは、どちらにも出ています。
日本語でこうした建物になった理由までは、この試しからは分かりません。
学習した画像を貼り合わせて作るのではない
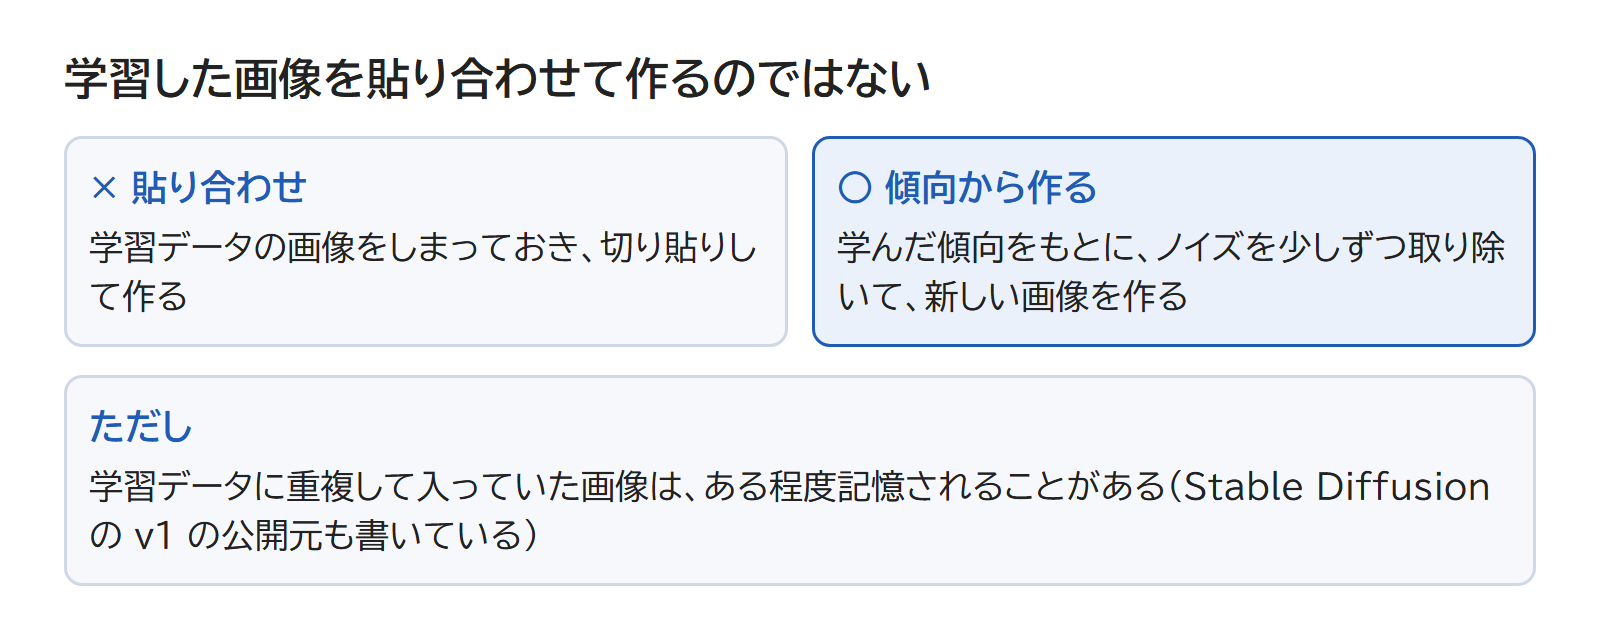
学習データから作るといっても、学習データの画像を切り貼りして作っているのではありません。
モデルがしているのは、学んだ傾向をもとに、ノイズを少しずつ取り除いて新しい画像を作ることです。
ただし、学習データに重複して入っていた画像は、ある程度記憶されることがあります。記憶とは、学習した画像とよく似た画像を作れるほど、覚えてしまうことです。
Stable Diffusion の v1 の公開元も、学習データの重複を取り除かなかったため、重複した画像の記憶が見られたと書いています。学習データにあった画像と、よく似た画像が出ることもあるわけです。
学習データを知って作りにくい画像の理由を見分けよう
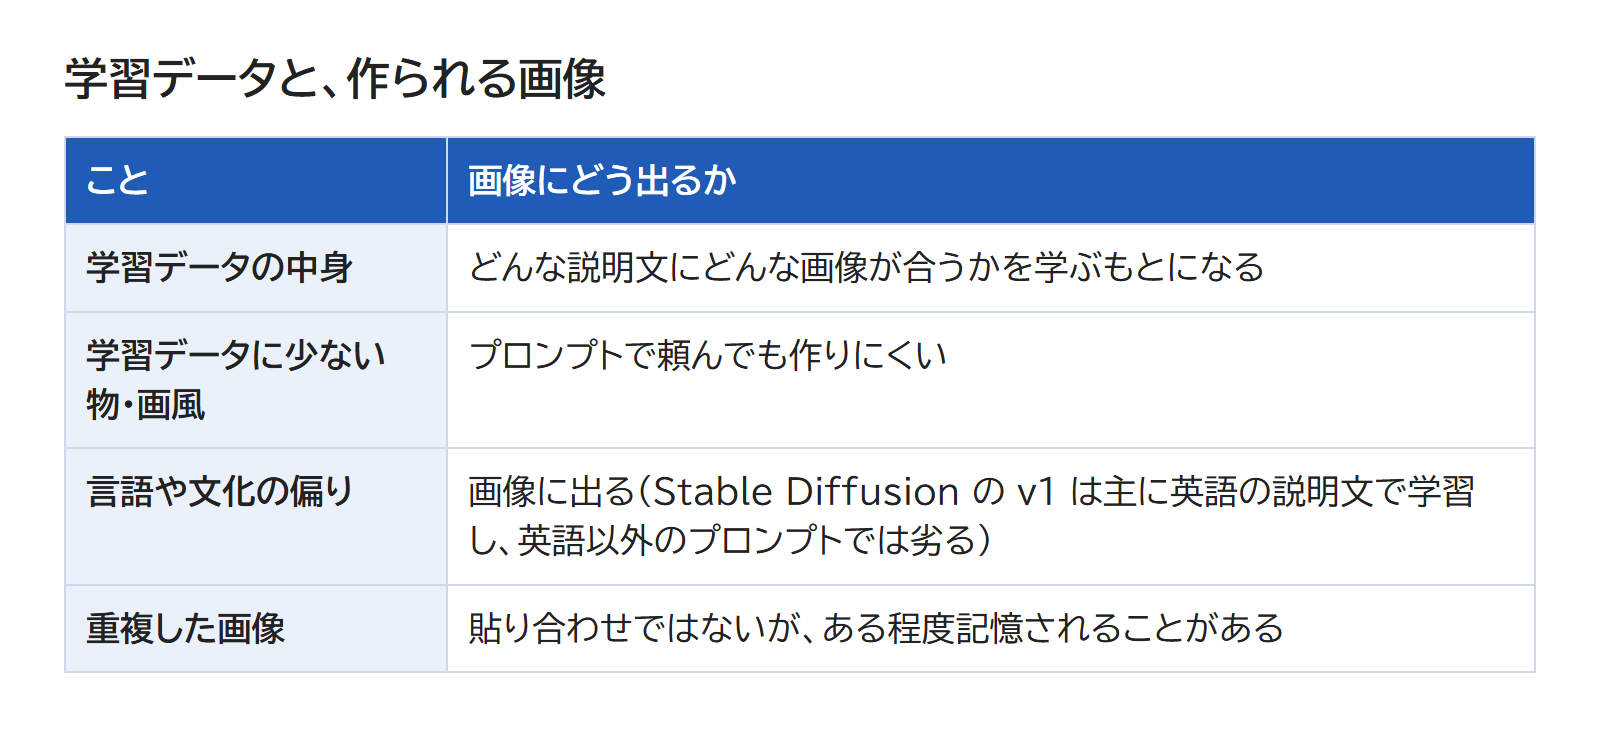
画像生成AIは、学習データの組から学んだ傾向で画像を作ります。この記事で解説したことは、次の4つです。
- 学習データは、画像とその画像の説明文の組でできている
- 学習データに少ない物や画風は、プロンプトで頼んでも作りにくい
- 学習データの言語や文化の偏りは、作られる画像に出る
- 学習した画像を貼り合わせて作るのではないが、重複した画像はある程度記憶されることがある
思ったとおりの画像が出ないときは、プロンプトを英語で書いているか、作りたい物が学習データに少なそうかを確かめてみてください。
あわせて読みたい
- 「モデルのファイルとファインチューニング|チェックポイント」(準備中) — 学習済みのモデルに、あとから学ばせて作るモデルを知りたいとき
- 「AIと著作権|学習の段階と生成・利用の段階」(準備中) — 学習データに他人の作品が入ることと、著作権の関係を知りたいとき
- 「画像生成AIの歴史|GAN・VAE・拡散モデル」(準備中) — 大量の画像から学ぶ今のモデルが、どう生まれたかを知りたいとき
- 「AI建築パースのプロンプトの書き方|建物・素材・光・視点とテキストエンコーダの仕組み」(準備中) — 英語で書くプロンプトに、何をどう書けばよいかを知りたいとき
会員登録(無料)
記事やテーマのお気に入り・学習履歴・フォローが使えます。
この記事について
PERSC編集部が、建築の制作に関わる知識を実務目線で整理しています。内容は公開・更新日時点の情報にもとづきます。誤りや古い情報にお気づきの場合はお問い合わせよりご連絡ください。