画像生成AIの歴史|GAN・VAE・拡散モデル
- 画像生成AIは、どう発展してきたの?
- GAN・VAE・拡散モデルの違いが分からない
- 今の画像生成AIの仕組みのもとを知りたい
画像生成AIの説明を読むと、GAN・VAE・拡散モデルといった名前がよく出てきます。ただ、名前だけが並んでいると、どれが今の画像生成AIにつながるのかは分かりにくいものです。
この記事では、VAE・GAN・拡散モデル・潜在拡散モデルが出てきた順と、それぞれの画像の作り方を解説します。
今の Stable Diffusion(画像生成AIの1つ)で、拡散モデルは作り方として、VAE は部品として生きています。
画像生成AIの歴史の流れ
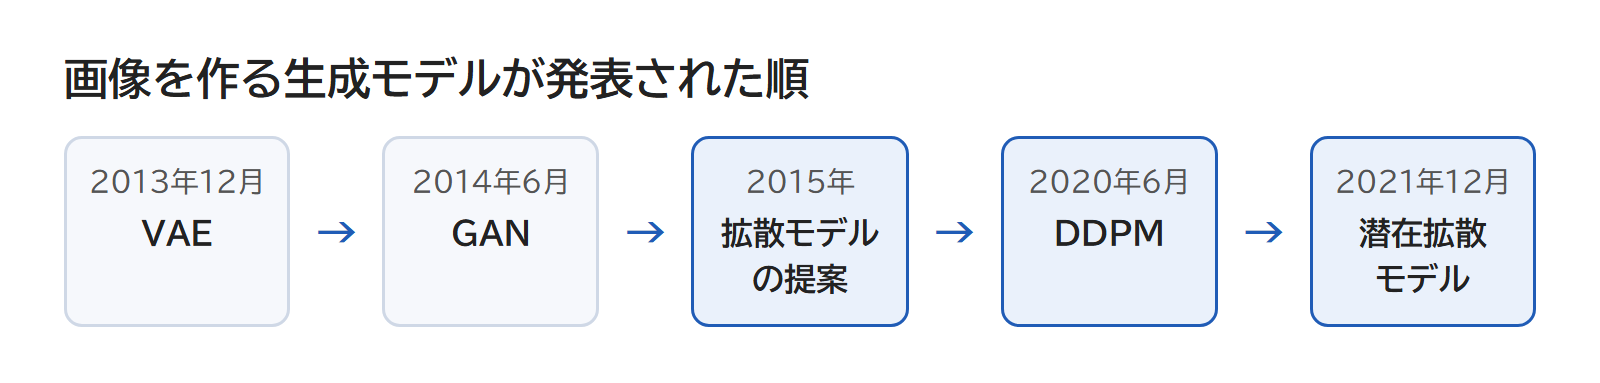
この記事の4つの生成モデルは、VAE・GAN・拡散モデル・潜在拡散モデルの順に論文で発表されました。生成モデルとは、データから特徴を学び、新しいデータを作るモデルのことです。
GAN・VAE の順に並べて書かれることもありますが、年の順では VAE が先に出ています。発表された年を並べると、次の表のとおりです。
| 年 | 出てきたもの |
|---|---|
| 2013年12月 | VAE |
| 2014年6月 | GAN |
| 2015年 | 拡散モデルの提案 |
| 2020年6月 | 拡散モデルの DDPM(画質で注目された) |
| 2021年12月 | 潜在拡散モデル |
VAE(2013年)
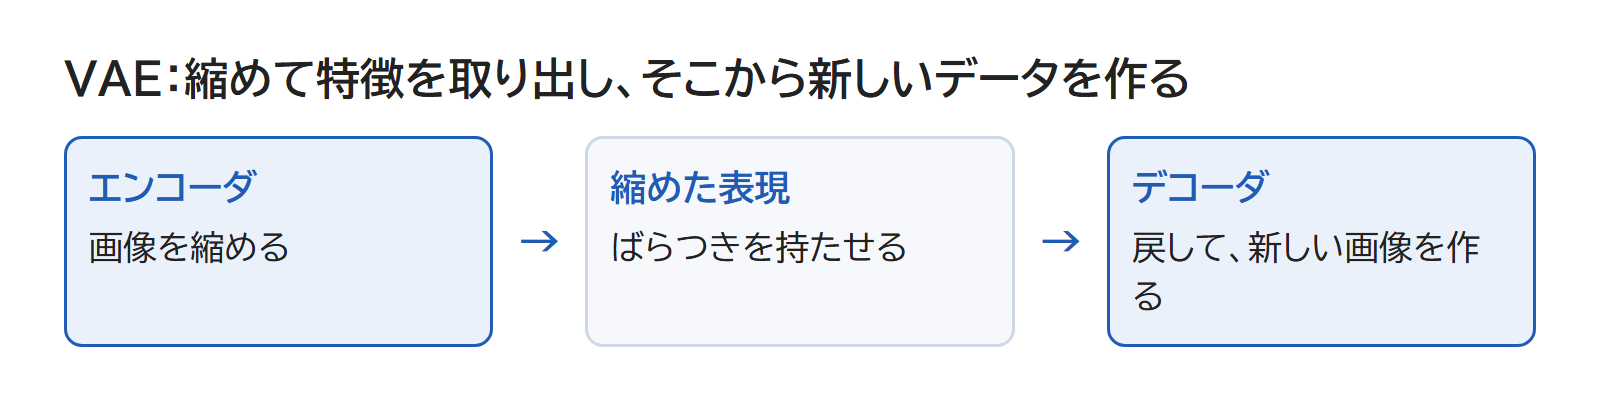
VAE(変分オートエンコーダー)は、データを小さく縮めて特徴を取り出し、そこから元とは違う新しいデータを作る生成モデルです。縮める側をエンコーダ、縮めた表現から戻す側をデコーダと呼びます。
縮めて戻すだけなら元のデータに戻りそうですが、VAE は縮めた表現に確率のばらつきを持たせるのが特徴です。そのため、戻すときに入力とは違う新しいデータを作れるようになっています。
GAN(2014年)
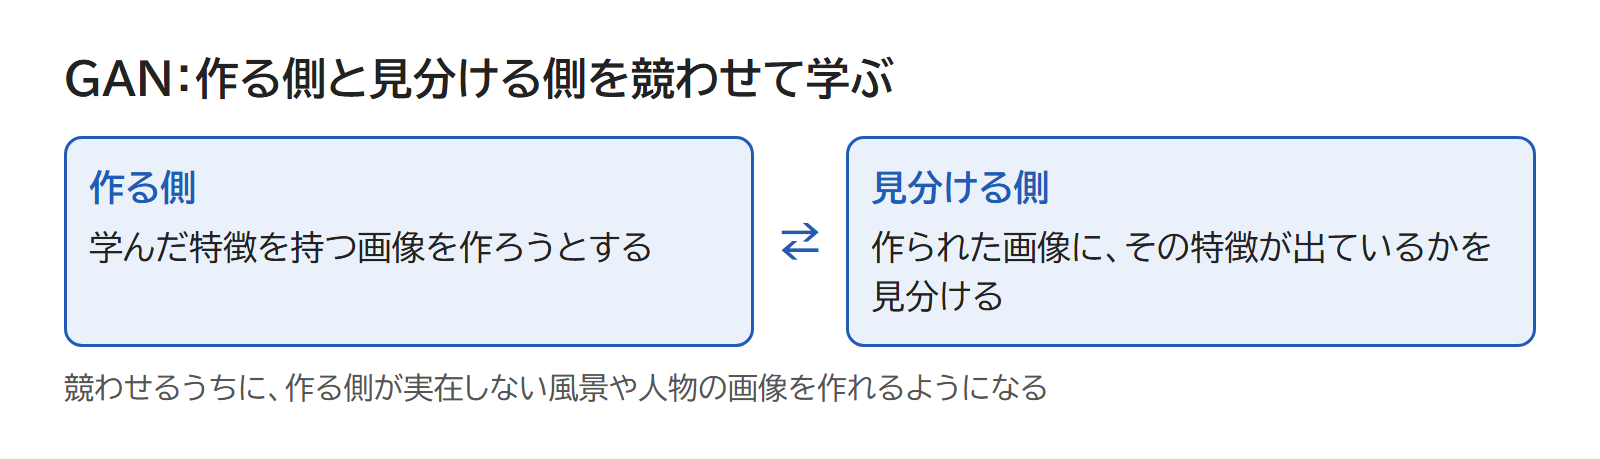
2014年に発表された GAN(敵対的生成ネットワーク)は、画像を作る側と、作られた画像を見分ける側を競わせて学習する生成モデルです。画像の作り方の考え方は、VAE とは別物です。
作る側は、学んだ特徴を持つ画像を作ろうとし、見分ける側は、その特徴が出ているかを見分けます。2つを競わせるうちに、作る側が実在しない風景や人物の画像を作れるようになります。
GAN は今も、拡散モデルと並ぶ、生成AIを作る手法の1つです。
拡散モデル(2015年・2020年)
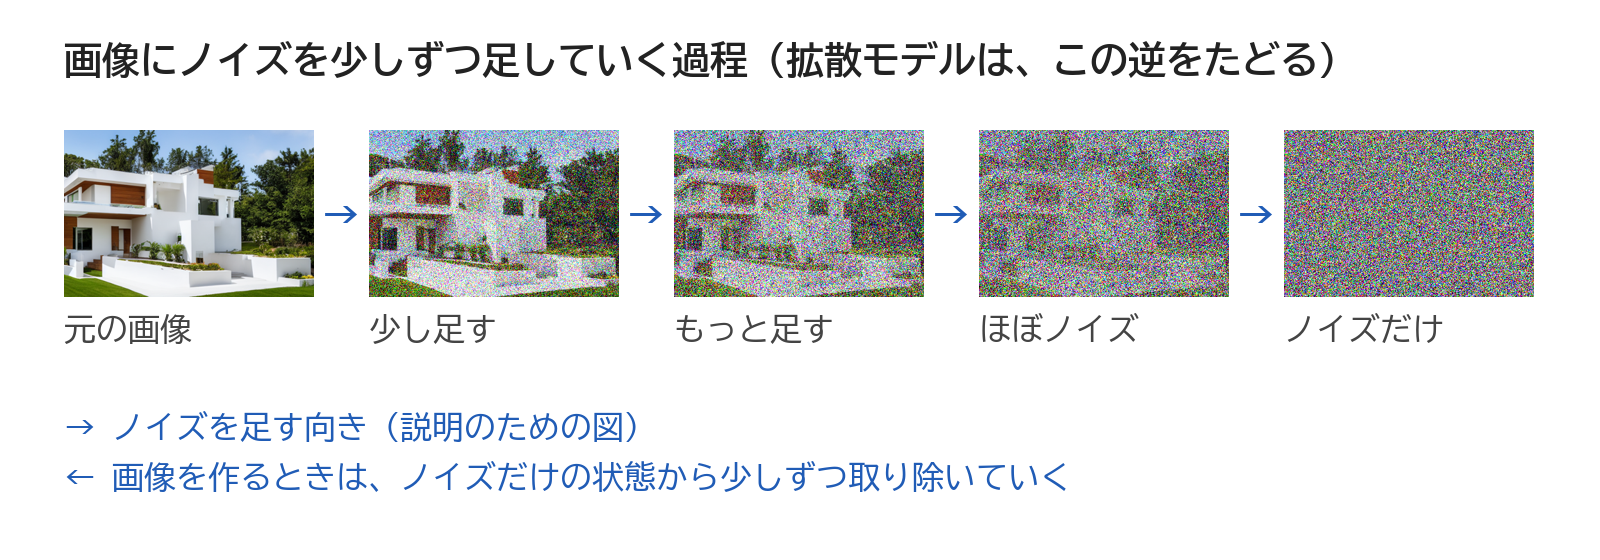
拡散モデルは、画像に少しずつノイズを足してノイズだけにする過程を逆にたどり、ノイズから画像を作る生成モデルです。
ノイズとは、画像に重なるでたらめな点のざらつきのこと。上の図のように、足すほど元の画像は見えなくなります。
考え方が論文で提案されたのは2015年でした。
その後、2020年に発表された DDPM という方式が高い画質の画像を作れることを示し、拡散モデルが注目されるようになりました。
画像を作るときは、ノイズを一度に取り除かず、何十回かに分けて少しずつ取り除きます。1回ごとに、学んだ傾向から「どこにどんなノイズがあるか」を予測して取り除く形です。
潜在拡散モデル(2021年)
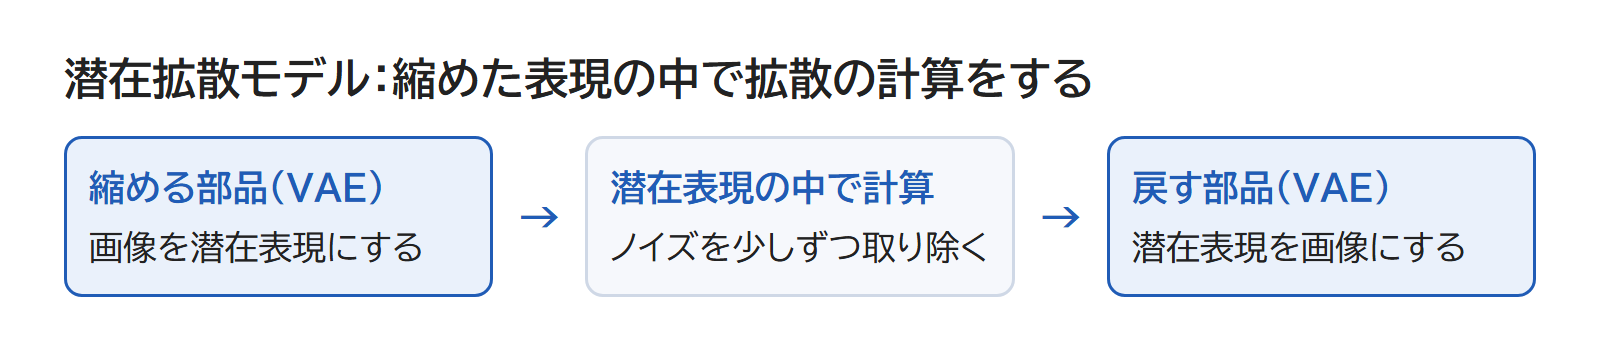
潜在拡散モデルは、拡散の計算を、画像を小さく縮めた表現(潜在表現)の中で行うモデルです。
それまでの拡散モデルは画像のまま計算していたので、学習に大きな計算が要り、画像を作るのにも何回も計算をくり返していました。
縮めた表現の中で計算すれば、画質を保ちながら計算を軽くできます。たとえば Stable Diffusion の最初の版では、512×512 の画像を 64×64 の大きさの表現に縮めてから計算する仕組みです。
画像を縮めて戻す部品には、VAE と同じ作りのものが使われています。
今の画像生成AIへのつながり
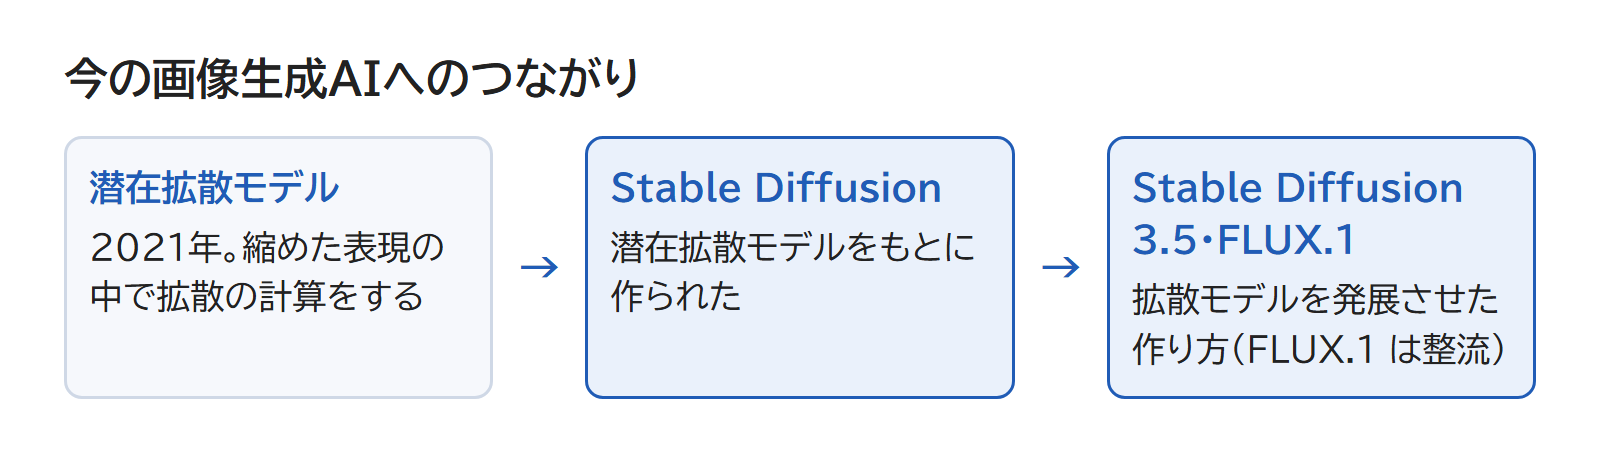
今の画像生成AIの Stable Diffusion は、潜在拡散モデルをもとに作られた画像生成AIです。最初の版では、ノイズを取り除く回数は50回ほどが目安とされています。
Stable Diffusion 3.5 や FLUX.1 のような新しいモデルも、拡散モデルを発展させた作り方で作られていると、開発元が公表しています。
たとえば Black Forest Labs の FLUX.1 は、ノイズから画像までのたどり方を直線にする整流(Rectified Flow)という作り方のモデルです。
画像生成AIの流れから今の仕組みをつかもう
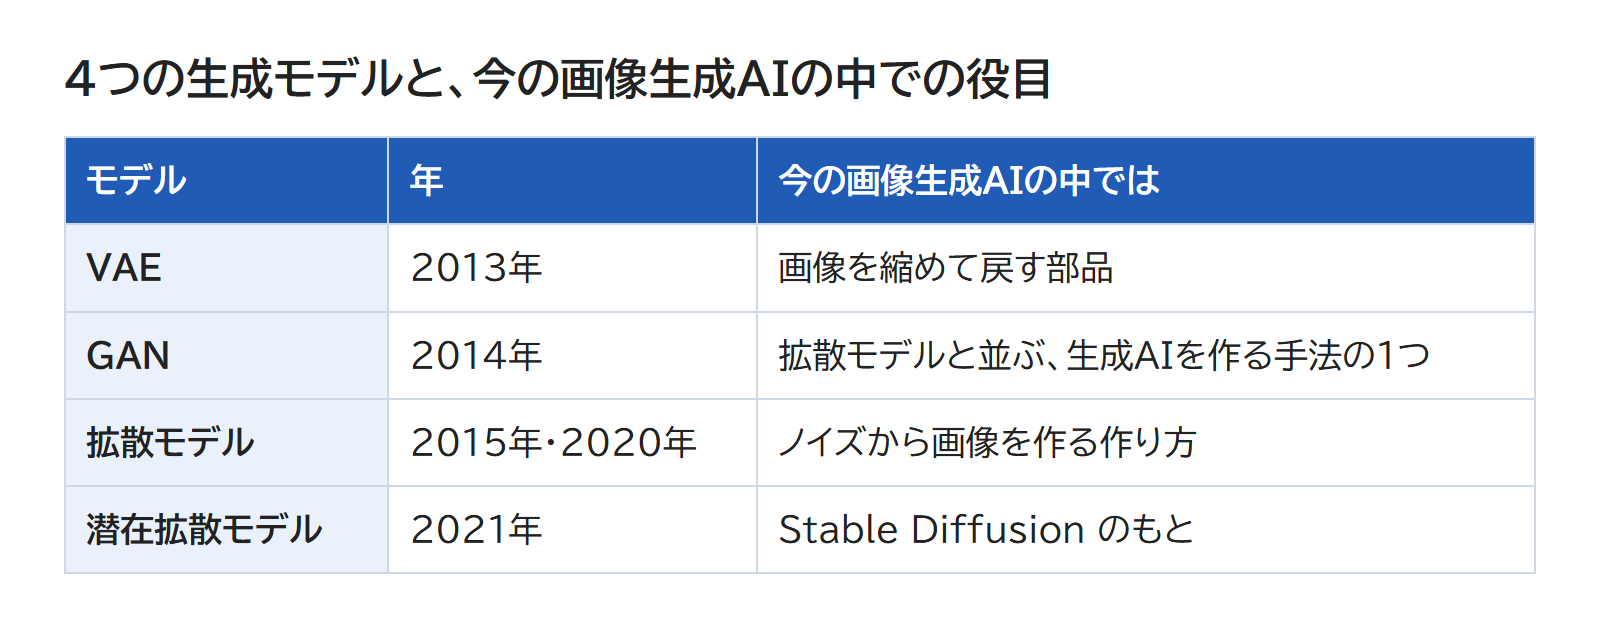
画像を作る生成モデルは、VAE・GAN のあとに拡散モデルが出てきて、縮めた表現で計算する潜在拡散モデルが Stable Diffusion のもとになりました。
この記事で解説した生成モデルは、次の4つです。
- VAE(2013年)
- GAN(2014年)
- 拡散モデル(2015年・2020年)
- 潜在拡散モデル(2021年)
ComfyUI のような画像生成AIを動かすソフトの画面にも、VAE の名前が出てきます。名前を見かけたら、どの年のどの部品かを思い出してみてください。
あわせて読みたい
- 「生成AIの種類|文章・画像・動画・音声・3Dを作るAI」(準備中) — 画像のほかに、生成AIが何を作るかを知りたいとき
- 「拡散モデル|ノイズを少しずつ取り除いて作る画像」(準備中) — ノイズから画像を作る仕組みをくわしく知りたいとき
- 「潜在空間とVAE|画像を小さく縮めた計算」(準備中) — 画像を縮めて計算する理由をくわしく知りたいとき
会員登録(無料)
記事やテーマのお気に入り・学習履歴・フォローが使えます。
この記事について
PERSC編集部が、建築の制作に関わる知識を実務目線で整理しています。内容は公開・更新日時点の情報にもとづきます。誤りや古い情報にお気づきの場合はお問い合わせよりご連絡ください。